第351篇:网络割接回滚方案与应急演练
关键词:割接回滚、应急演练、变更管理、风险评估、应急预案
一、案例背景
某运营商在进行核心路由器升级割接时,遇到了未预见的兼容性问题。由于回滚方案准备充分,团队在30分钟内完成了回滚操作,避免了大规模业务中断。本次案例详细记录了回滚方案的设计、执行和演练过程。
割接项目:核心路由器从NE40E-X8升级至NE40E-X16 割接窗口:周六凌晨00:00-06:00 影响范围:全省50万宽带用户 回滚触发条件:割接后业务验证失败或中断超过30分钟
二、需求分析与方案设计
2.1 回滚方案核心要素
| 要素 | 说明 | 要求 |
|---|---|---|
| 回滚触发条件 | 什么情况下启动回滚 | 明确、可量化 |
| 回滚步骤 | 回滚的具体操作命令 | 详细、可执行 |
| 回滚时间 | 预计回滚完成时间 | 尽量短 |
| 回滚验证 | 回滚后的验证方法 | 与正向验证一致 |
| 回滚责任人 | 谁负责执行回滚 | 明确到人 |
2.2 回滚决策树
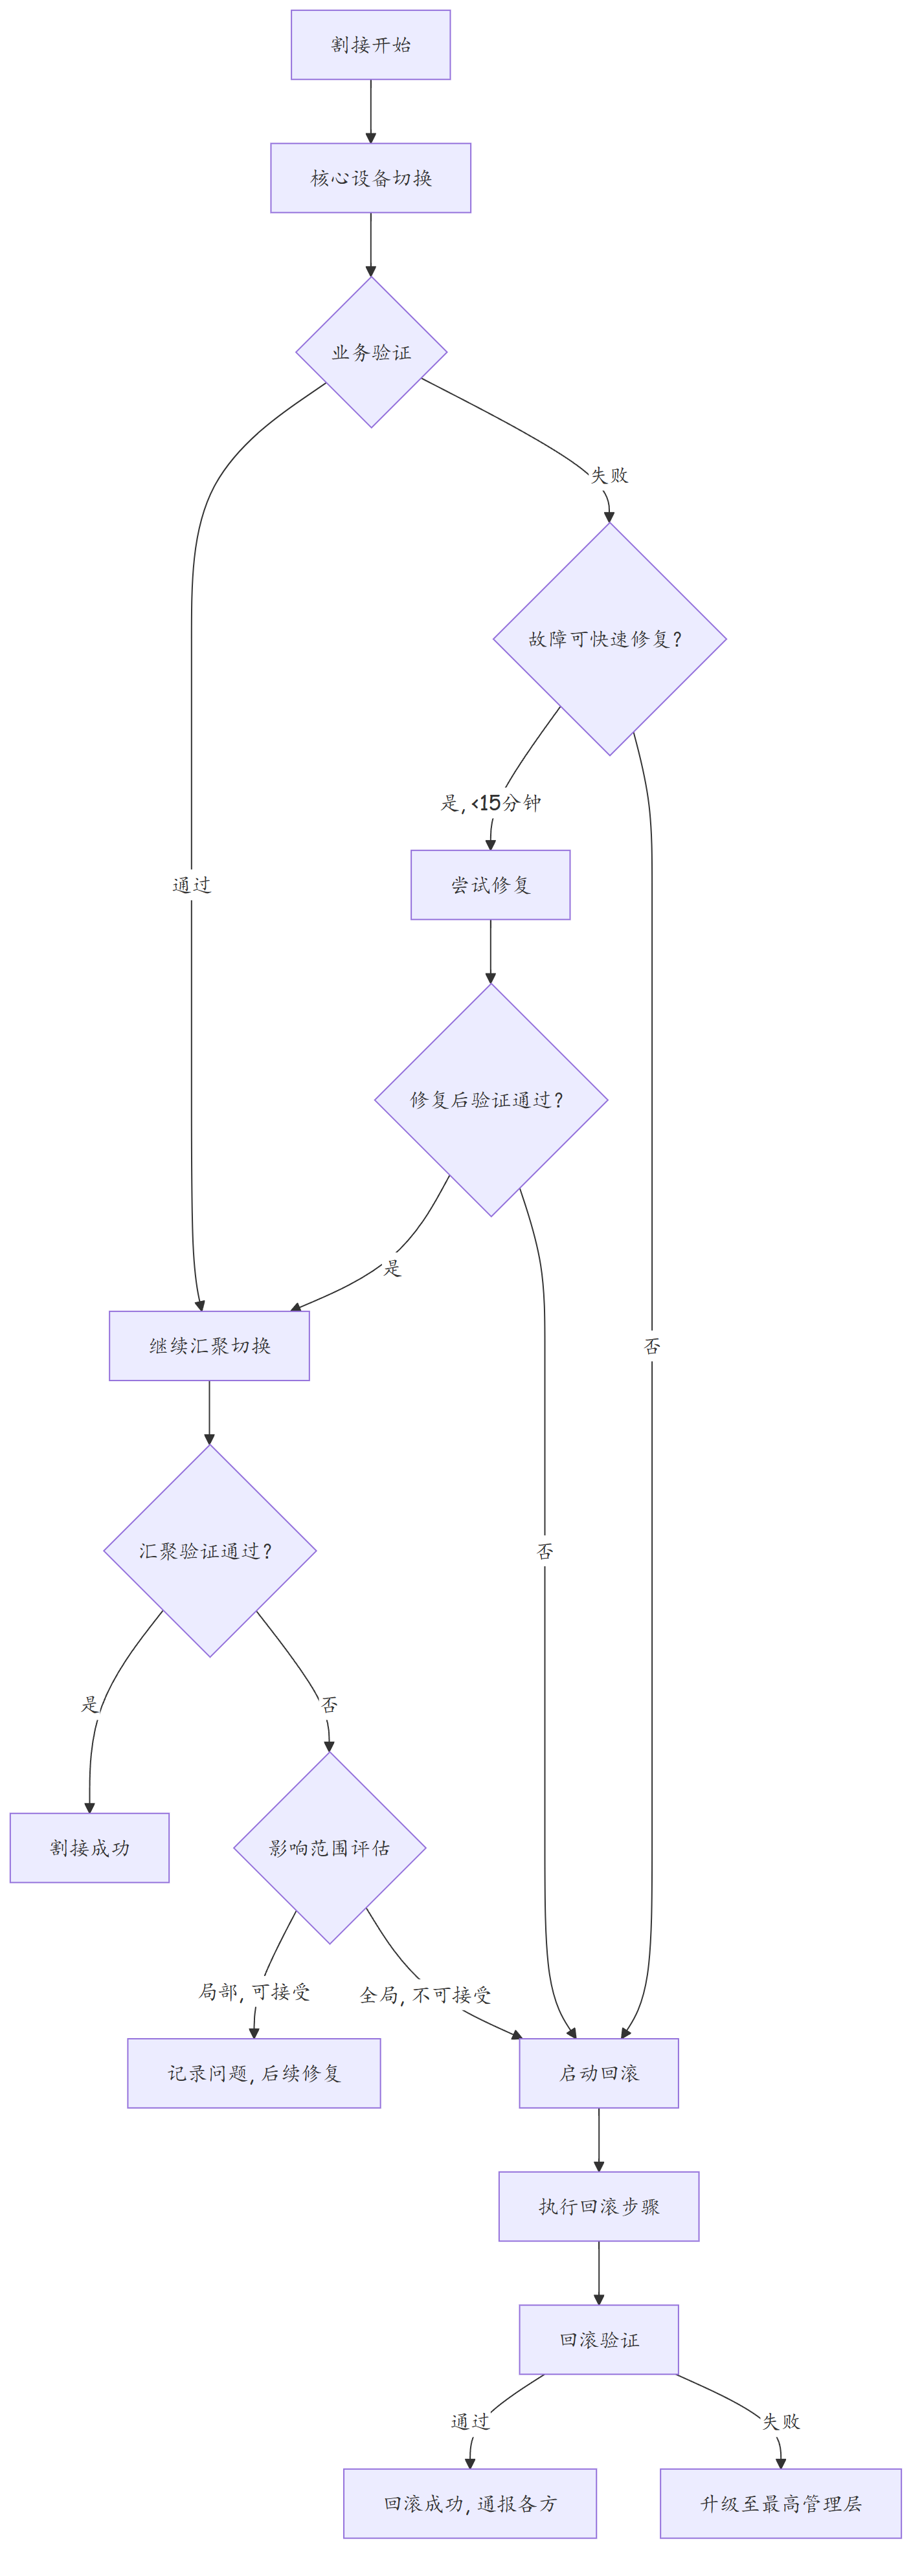
2.3 回滚方案设计
| 阶段 | 正向操作 | 回滚操作 | 预计耗时 |
|---|---|---|---|
| 核心切换 | 新核心Up,旧核心Down | 旧核心Up,新核心Down | 5分钟 |
| 路由迁移 | 新核心OSPF Area激活 | 旧核心OSPF Area激活 | 3分钟 |
| 业务迁移 | 新核心VLAN激活 | 旧核心VLAN激活 | 5分钟 |
| 链路切换 | 新链路Up | 旧链路Up | 2分钟 |
| 配置恢复 | N/A | 恢复旧配置备份 | 5分钟 |
总回滚时间:20分钟内
三、技术细节与实施过程
3.1 割接前准备工作
# 步骤1:备份旧设备完整配置
<NE40E-X8> save force
<NE40E-X8> display current-configuration > old_config_backup.txt

# 步骤2:记录当前运行状态
<NE40E-X8> display ospf peer > ospf_peer_backup.txt
<NE40E-X8> display ip routing-table > routing_table_backup.txt
<NE40E-X8> display mpls ldp peer > ldp_peer_backup.txt

# 步骤3:准备回滚脚本
# rollback_script.txt
interface GigabitEthernet 0/0/1
 undo shutdown
quit
interface GigabitEthernet 0/0/2
 undo shutdown
quit
ospf 1
 area 0
  network 10.0.0.0 0.0.0.255
quit
quit
3.2 割接执行与回滚触发
割接过程:
| 时间 | 操作 | 状态 |
|---|---|---|
| 00:00 | 新核心设备加电 | ✓ |
| 00:15 | 新核心基础配置加载 | ✓ |
| 00:30 | 新旧核心互联链路Up | ✓ |
| 00:45 | OSPF邻居建立 | ✓ |
| 01:00 | 旧核心VLAN shutdown | ✓ |
| 01:05 | 新核心VLAN activate | ✓ |
| 01:10 | 业务验证 | ✗ 失败 |
验证失败现象: - 部分MPLS L3VPN业务路由缺失 - BGP会话在部分PE设备上断开 - 根因:新设备的BGP GR与旧设备不兼容
回滚决策: - 01:15 技术负责人评估:BGP GR兼容性问题需30分钟+修复 - 01:17 项目经理决定:启动回滚 - 01:18 回滚执行组开始执行回滚脚本
3.3 回滚执行
# 回滚步骤1:恢复旧核心VLAN
<NE40E-X8> system-view
[NE40E-X8] interface Vlanif 100
[NE40E-X8-Vlanif100] undo shutdown
[NE40E-X8-Vlanif100] quit
# ... 恢复所有VLAN

# 回滚步骤2:关闭新核心VLAN
<NE40E-X16> system-view
[NE40E-X16] interface Vlanif 100
[NE40E-X16-Vlanif100] shutdown
[NE40E-X16-Vlanif100] quit
# ... 关闭所有VLAN

# 回滚步骤3:验证业务恢复
<NE40E-X8> display bgp peer
# BGP会话恢复
<NE40E-X8> display mpls ldp peer
# LDP会话恢复
3.4 详细回滚命令集
以下是本次割接中实际使用的回滚命令集(已在演练中验证):
# ===== 回滚脚本:rollback_core_router.txt =====
# 适用场景:NE40E-X16升级失败,恢复至NE40E-X8

# Step 1: 恢复旧核心接口
interface GigabitEthernet 8/0/1
 undo shutdown
description To_Agg_Core_A
quit
interface GigabitEthernet 8/0/2
 undo shutdown
description To_Agg_Core_B
quit
interface GigabitEthernet 8/0/3
 undo shutdown
description To_Peering
quit

# Step 2: 恢复VLANIF接口
interface Vlanif 100
 undo shutdown
 ip address 10.0.100.1 255.255.255.252
quit
interface Vlanif 200
 undo shutdown
 ip address 10.0.200.1 255.255.255.252
quit
interface Vlanif 300
 undo shutdown
 ip address 10.0.300.1 255.255.255.252
quit

# Step 3: 恢复OSPF路由
ospf 1
 area 0.0.0.0
  network 10.0.0.0 0.0.255.255
quit

# Step 4: 恢复MPLS LDP
mpls
mpls ldp
quit

# Step 5: 验证回滚状态
display interface brief | include Up
display ospf peer brief
display bgp peer brief
display mpls ldp peer
display ip routing-table statistics
3.5 回滚验证矩阵
# 回滚后必须逐项验证以下指标
<NE40E-X8> display ip routing-table | include Destination
# 预期:路由表条目数与割接前一致(约15000条)

<NE40E-X8> display bgp routing-table statistics
# 预期:BGP路由条目数与割接前一致

<NE40E-X8> display mpls lsp
# 预期:LSP数量与割接前一致,状态全部Active

# 业务层面的验证
<NE40E-X8> ping -a 10.0.100.1 202.97.0.1 loopback 10
# 预期:丢包率=0%,延迟<10ms

# 用户侧业务抽样验证
# 选取10个典型用户,验证上网、视频会议、ERP等核心业务
| 验证项 | 割接前基线 | 回滚后实测 | 判定 |
|---|---|---|---|
| 路由表条目数 | 15,234 | 15,230 | ✓ (4条差异为正常老化) |
| BGP会话数 | 12 | 12 | ✓ |
| LDP会话数 | 8 | 8 | ✓ |
| LSP数量 | 156 | 156 | ✓ |
| 核心链路利用率 | 45% | 46% | ✓ |
| 用户Ping丢包率 | 0% | 0% | ✓ |
回滚时间线:
| 时间 | 操作 | 状态 |
|---|---|---|
| 01:18 | 开始回滚 | - |
| 01:25 | 旧核心VLAN恢复 | ✓ |
| 01:28 | BGP会话恢复 | ✓ |
| 01:30 | LDP会话恢复 | ✓ |
| 01:32 | 业务验证通过 | ✓ |
| 01:35 | 回滚完成通报 | ✓ |
总回滚耗时:17分钟(优于20分钟目标)
四、实战配置/案例分析
4.1 标准化回滚方案模板
# 回滚方案模板

## 基本信息
- 割接项目名称:
- 割接日期:
- 回滚触发人:
- 回滚开始时间:

## 回滚触发条件(满足任一即触发)
1. [ ] 核心业务中断超过30分钟
2. [ ] 超过20%的VLAN无法正常通信
3. [ ] 安全策略异常导致大面积访问被阻断
4. [ ] 设备硬件故障无法修复

## 回滚步骤
### 步骤1:恢复旧设备配置
- 命令:
- 预计耗时:
- 执行人:

### 步骤2:关闭新设备
- 命令:
- 预计耗时:
- 执行人:

### 步骤3:验证业务恢复
- 验证项:
- 验证方法:
- 执行人:

## 回滚后处理
1. 记录回滚原因
2. 分析故障根因
3. 修订割接方案
4. 安排下次割接
4.2 应急演练方案
# 应急演练计划
# 演练目标:验证回滚方案的有效性和团队的执行能力

## 演练场景
场景1:核心切换后BGP路由缺失
场景2:新设备硬件故障
场景3:配置加载错误导致设备无法启动

## 演练步骤
1. 模拟故障注入(在测试环境)
2. 触发回滚决策
3. 执行回滚步骤
4. 验证回滚结果
5. 复盘总结

## 演练评估指标
| 指标 | 目标值 | 实际值 |
|------|--------|--------|
| 回滚决策时间 | <5分钟 | |
| 回滚执行时间 | <20分钟 | |
| 回滚成功率 | 100% | |
| 沟通效率 | 信息传递<1分钟 | |
4.3 回滚复盘报告
| 维度 | 评估 | 改进建议 |
|---|---|---|
| 回滚方案完整性 | 良好 | 补充BGP GR兼容性检查项 |
| 回滚执行速度 | 优秀 | 17分钟完成,优于目标 |
| 团队配合 | 良好 | 回滚指令传达有1分钟延迟 |
| 文档准确性 | 良好 | 回滚脚本需要增加更多注释 |
| 沟通机制 | 一般 | 需要建立回滚专用通信频道 |
4.4 割接沟通机制设计
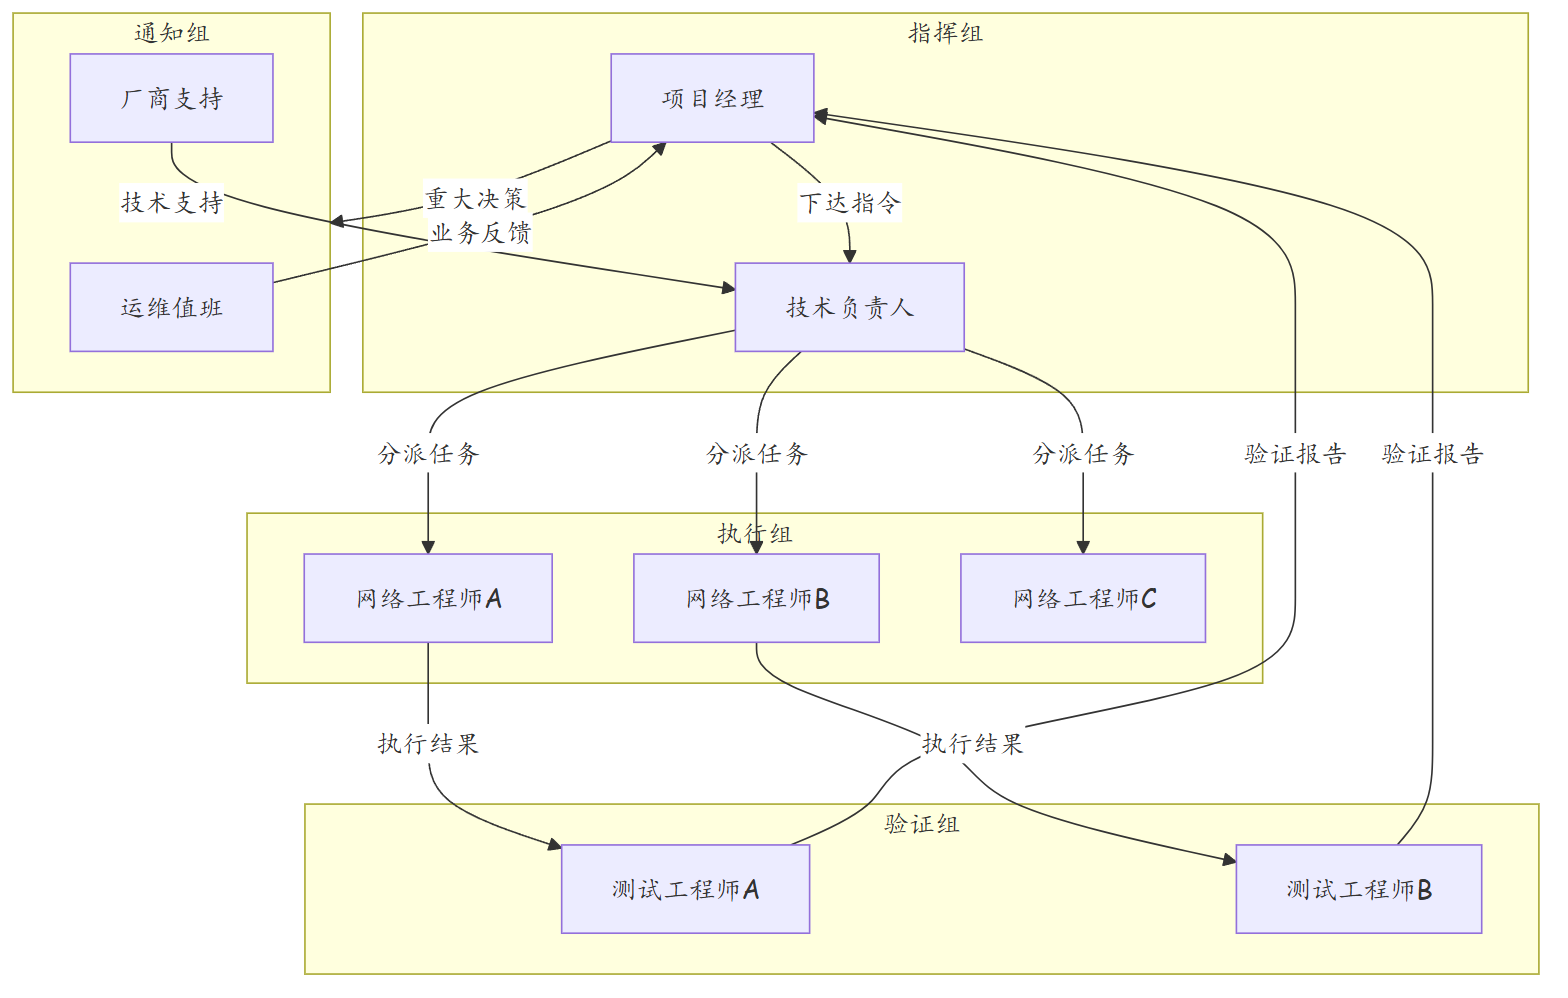
沟通渠道配置:
| 渠道 | 用途 | 参与人 |
|---|---|---|
| 微信群(主) | 实时指令下达、进度汇报 | 全员 |
| 微信群(回滚专用) | 回滚指令、回滚进度 | 指挥组+执行组 |
| 电话会议 | 重大决策、升级上报 | 指挥组+管理层 |
| 邮件 | 割接前通知、割接后总结 | 全体干系人 |
关键话术模板:
【割接进度】HH:MM 阶段X 操作Y 状态:成功/失败 下一步:Z
【回滚触发】HH:MM 触发条件:XXX 决定:启动回滚 预计完成:HH:MM
【升级上报】HH:MM 问题:XXX 影响:XXX 建议:XXX
4.5 演练记录与评分
# 第一次演练(割接前2周)
# 场景:BGP GR不兼容导致路由黑洞

## 演练过程记录
| 步骤 | 预期时间 | 实际时间 | 偏差 | 说明 |
|------|---------|---------|------|------|
| 故障注入 | 00:00 | 00:00 | 0 | 模拟BGP会话Flapping |
| 故障发现 | 00:03 | 00:02 | -1 | 监控告警触发 |
| 根因定位 | 00:10 | 00:08 | -2 | 比对BGP日志 |
| 回滚决策 | 00:15 | 00:10 | -5 | 明确触发条件,快速决策 |
| 回滚执行 | 00:35 | 00:27 | -8 | 操作熟练,比预期快 |
| 回滚验证 | 00:45 | 00:35 | -10 | 验证清单完整 |

## 综合评分
| 维度 | 满分 | 得分 | 说明 |
|------|------|------|------|
| 回滚方案完整性 | 20 | 18 | 缺少BGP GR检查项 |
| 回滚执行速度 | 20 | 19 | 27分钟,优于30分钟目标 |
| 团队配合 | 20 | 16 | 沟通有1-2分钟延迟 |
| 文档准确性 | 20 | 18 | 命令基本准确,注释不足 |
| 应急决策 | 20 | 17 | 决策流程清晰但缺少授权链 |

## 改进项(已纳入正式回滚方案)
1. 回滚方案增加BGP GR兼容性预检查步骤
2. 建立回滚专用微信群,减少沟通延迟
3. 回滚命令增加详细注释和上下文说明
4. 明确回滚决策的授权链(技术负责人→项目经理→CTO)
4.6 Ansible自动化回滚方案
# rollback_playbook.yml - Ansible自动化回滚
---
- name: Core Router Rollback
  hosts: old_core_router
  gather_facts: no
  connection: network_cli
  tasks:
    - name: Restore interface configuration
      ios_config:
        parents: "interface {{ item }}"
        lines:
          - undo shutdown
      loop:
        - GigabitEthernet 8/0/1
        - GigabitEthernet 8/0/2
        - GigabitEthernet 8/0/3

    - name: Restore OSPF configuration
      ios_config:
        src: templates/ospf_rollback.j2

    - name: Verify BGP sessions
      ios_command:
        commands:
          - display bgp peer brief
      register: bgp_status

    - name: Check BGP recovery
      assert:
        that:
          - "'Established' in bgp_status.stdout[0]"
        fail_msg: "BGP会话未恢复,回滚失败!"
        success_msg: "BGP会话已全部恢复"

    - name: Notify rollback complete
      uri:
        url: "https://hooks.feishu.com/rollback-alert"
        method: POST
        body: '{"text": "回滚完成,耗时{{ elapsed_seconds }}秒"}'
五、经验总结
| 序号 | 经验类别 | 经验内容 | 适用场景 |
|---|---|---|---|
| 1 | 回滚设计 | 回滚方案必须与割接方案同等重视 | 所有割接 |
| 2 | 触发条件 | 回滚触发条件必须量化,避免主观判断 | 决策机制 |
| 3 | 脚本准备 | 回滚命令必须提前准备为可执行脚本 | 自动化 |
| 4 | 演练验证 | 回滚方案必须经过实际演练验证 | 变更管理 |
| 5 | 决策机制 | 回滚决策必须快速,设置最长等待时间 | 应急管理 |
| 6 | 备份管理 | 割接前必须备份完整配置和运行状态 | 配置管理 |
| 7 | 沟通机制 | 回滚过程中必须有清晰的沟通流程 | 团队协作 |
| 8 | 复盘改进 | 每次回滚后必须复盘并改进方案 | 持续改进 |
| 9 | 培训提升 | 团队成员必须熟悉回滚流程 | 人员培训 |
| 10 | 工具支撑 | 使用自动化工具加速回滚执行 | 自动化 |
思考
- 在大型网络割接中,如何确定回滚的"最大容忍时间"?这个时间应该如何量化?
- 如果割接过程中回滚方案本身也执行失败(如旧配置备份损坏),应该如何应对?
- 自动化回滚工具(如Ansible Rollback)与手工回滚相比,各有什么优缺点?
下篇预告:第352篇:一次完整的网络健康检查(Health Check)