第361篇:新员工如何快速掌握网络排错方法论
关键词:网络排错、排错方法论、OSI模型、分段隔离、根因分析
一、引言
网络排错是网络工程师的核心能力。新员工往往具备理论知识,但在实际故障面前却手足无措。本文总结了一套系统化的网络排错方法论,帮助新员工在3个月内建立完整的排错思维框架。
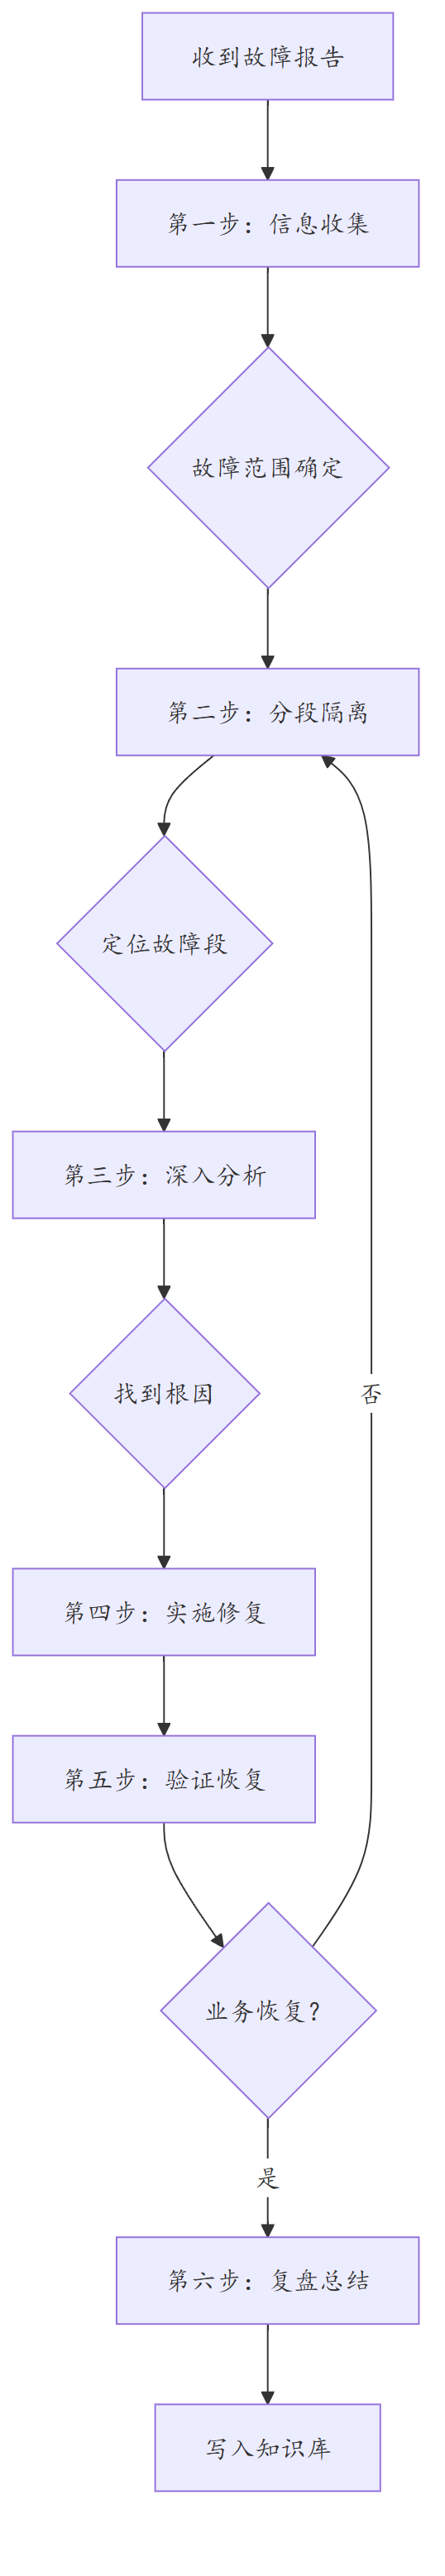
核心方法论: 1. 分段隔离法:将复杂问题分解为可管理的小问题 2. 二分排除法:每次排除一半可能,快速收敛 3. 证据驱动法:基于数据和证据做判断,而非猜测 4. 根因分析法:不止解决表象,更要找到根本原因
二、需求分析与方案设计
2.1 排错能力成长路径
| 阶段 | 时间 | 能力描述 | 排错方式 |
|---|---|---|---|
| 新手 | 0-1月 | 能执行既定排错步骤 | 按手册操作 |
| 进阶 | 1-3月 | 能独立处理常见故障 | 分段隔离 |
| 熟练 | 3-6月 | 能处理复杂故障 | 根因分析 |
| 专家 | 6-12月 | 能预判和预防故障 | 系统思维 |
2.2 排错方法论框架
2.3 排错工具清单
| 工具类别 | 工具 | 用途 | 优先级 |
|---|---|---|---|
| 连通性测试 | ping/traceroute | 基础连通性检查 | P0 |
| 端口测试 | telnet/nc | TCP端口可达性 | P0 |
| 抓包分析 | Wireshark/tcpdump | 协议级分析 | P1 |
| 性能测试 | iPerf/mtr | 带宽和路径分析 | P1 |
| 设备诊断 | display命令 | 设备状态检查 | P0 |
| 日志分析 | log analyzer | 历史事件追溯 | P2 |
三、技术细节与实施过程
3.1 第一步:信息收集
信息收集是排错的基础,必须问对问题:
5W1H信息收集法:
| 问题 | 目的 | 示例 |
|---|---|---|
| What(什么故障) | 确定故障现象 | "Ping不通还是访问慢?" |
| When(何时发生) | 确定故障时间 | "几点开始的?持续多久?" |
| Where(哪里故障) | 确定影响范围 | "所有用户还是部分用户?" |
| Who(谁受影响) | 确定影响对象 | "哪个部门/哪个系统?" |
| Why(可能原因) | 初步判断 | "最近有变更吗?" |
| How(影响程度) | 确定优先级 | "业务完全中断还是降级?" |
3.2 第二步:分段隔离(OSI七层法)
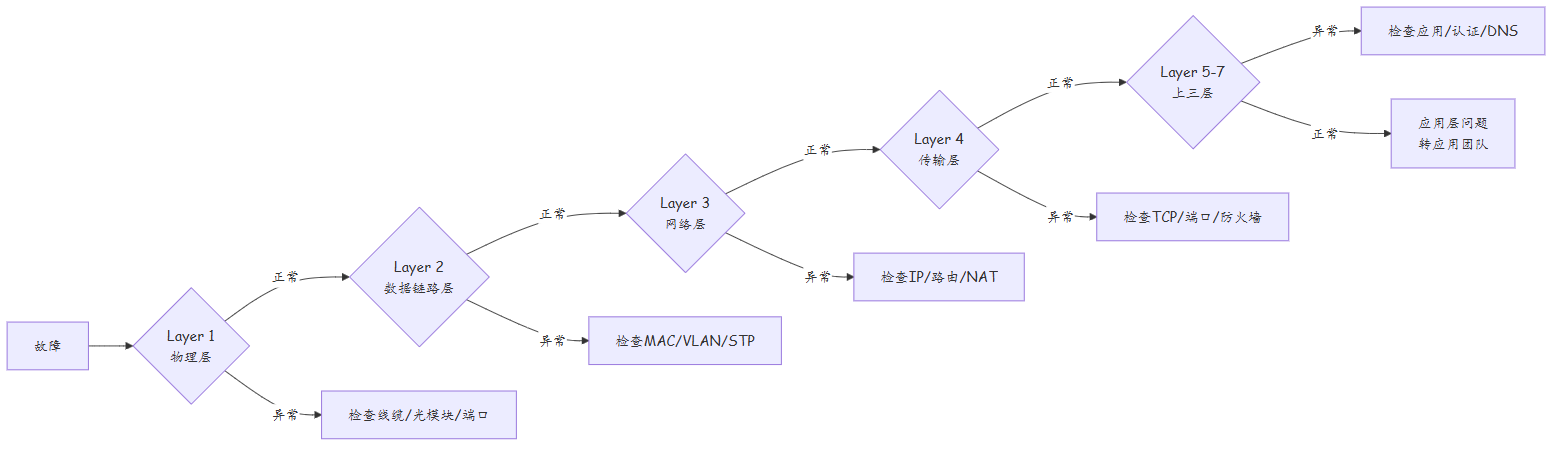
各层排错要点:
| OSI层 | 检查项 | 常用命令 |
|---|---|---|
| L1 物理层 | 端口状态、光功率、线缆 | display interface |
| L2 数据链路层 | MAC表、VLAN、STP | display mac-address |
| L3 网络层 | 路由表、ARP、IP配置 | display ip routing-table |
| L4 传输层 | TCP连接、端口监听 | telnet/nc测试 |
| L5-7 上三层 | 应用状态、认证、DNS | 抓包分析 |
3.3 第三步:二分排除法
二分排除法的核心是每次排除一半可能,快速收敛到故障点:
网络拓扑:A → B → C → D → E → F(用户)
故障:F无法访问A

第1步:从中间C点测试
  C ping A → 通 → 故障在C之后
  C ping F → 不通 → 故障在C和F之间

第2步:在C和F之间取中间点E测试
  E ping C → 通 → 故障在E和F之间
  E ping F → 不通 → 故障在E和F之间的链路上

第3步:检查E到F的链路
  发现E的端口Down → 根因定位:E到F的光模块故障
3.4 第四步:根因分析(5 Why法)
问题:用户无法访问互联网

Why 1: 为什么无法访问?
→ 因为出口防火墙阻断了流量

Why 2: 为什么防火墙阻断?
→ 因为安全策略匹配了deny规则

Why 3: 为什么匹配了deny规则?
→ 因为用户的源IP不在允许列表中

Why 4: 为什么源IP不在列表中?
→ 因为用户通过新的VLAN接入,该VLAN的网段未添加到策略

Why 5: 为什么新网段未添加到策略?
→ 因为VLAN扩展时遗漏了防火墙策略变更

根因:变更流程不完善,VLAN扩展未触发防火墙策略更新

纠正措施:建立VLAN变更与防火墙策略变更的联动检查清单
3.4 第四步:根因分析(5 Why法)
问题:用户无法访问互联网

Why 1: 为什么无法访问?
→ 因为出口防火墙阻断了流量

Why 2: 为什么防火墙阻断?
→ 因为安全策略匹配了deny规则

Why 3: 为什么匹配了deny规则?
→ 因为用户的源IP不在允许列表中

Why 4: 为什么源IP不在列表中?
→ 因为用户通过新的VLAN接入,该VLAN的网段未添加到策略

Why 5: 为什么新网段未添加到策略?
→ 因为VLAN扩展时遗漏了防火墙策略变更

根因:变更流程不完善,VLAN扩展未触发防火墙策略更新

纠正措施:建立VLAN变更与防火墙策略变更的联动检查清单
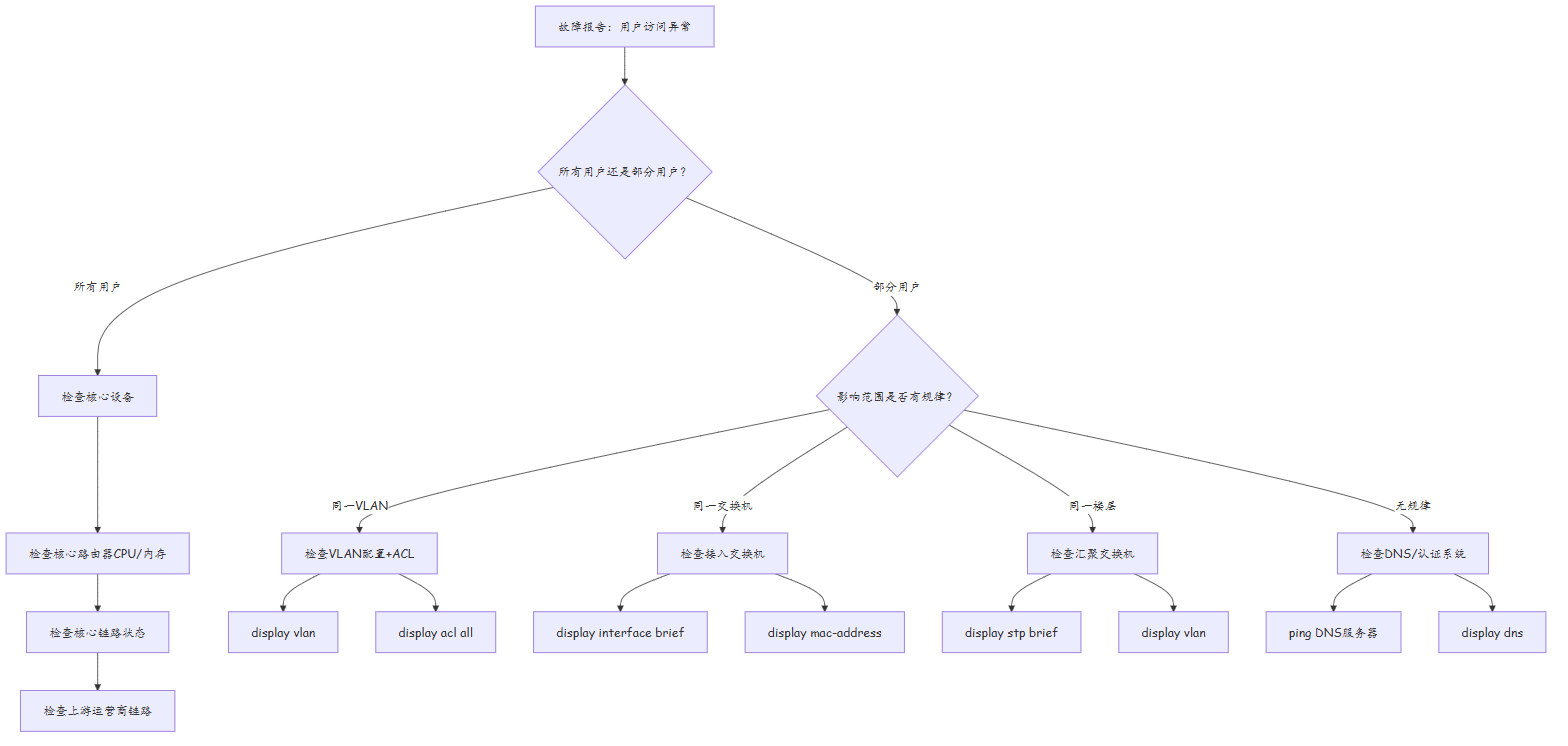
3.5 排错决策树模板
面对复杂故障时,使用决策树可以系统化地缩小排查范围:
四、实战排错案例
4.1 案例1:用户无法访问内网文件服务器
故障描述:财务部用户无法访问文件服务器10.10.10.100
排错过程:
故障描述:财务部用户无法访问文件服务器10.10.10.100

排错过程:

1. 信息收集
   - 影响范围:仅财务部(VLAN 200)
   - 故障时间:今天上午9点开始
   - 最近变更:无

2. 分段隔离
   Step 1: 物理层
   $ display interface brief
   → 端口状态正常 ✓

   Step 2: 数据链路层
   $ display vlan 200
   → VLAN 200存在 ✓
   $ display mac-address vlan 200
   → MAC学习正常 ✓

   Step 3: 网络层
   $ ping -a 10.10.200.1 10.10.10.100
   → Request timeout ✗

   $ display ip routing-table 10.10.10.100
   → 路由存在:10.10.10.0/24 via 10.10.0.1 ✓

   $ display arp all | include 10.10.10.100
   → ARP条目不存在 ✗ ← 问题在这里!

3. 深入分析
   $ display interface Vlanif 200
   → Vlanif 200的状态为up ✓

   $ display firewall session table
   → 无匹配会话 ← 防火墙可能阻断了ARP

4. 根因定位
   检查防火墙策略:
   $ display security-policy rule name VLAN200_TO_SERVER
   → 发现该策略仅允许TCP/UDP,未允许ARP!

5. 修复
   [FW] security-policy
   [FW-policy] rule name VLAN200_TO_SERVER
   [FW-policy-rule] service ARP  ← 添加ARP服务
   [FW-policy-rule] action permit
   [FW-policy-rule] quit

6. 验证
   $ ping -a 10.10.200.1 10.10.10.100
   → Reply from 10.10.10.100: bytes=56 time=2ms ✓
4.2 案例2:全网DNS解析间歇性失败
故障描述: 某公司500台终端间歇性出现DNS解析失败,表现为部分域名无法解析,但ping 8.8.8.8正常。故障随机出现,持续数秒至数分钟后自动恢复。
排错过程:
# 步骤1:确认故障范围
# 在多台终端上测试:
C:\> nslookup www.baidu.com
Server:  10.10.1.2
Address: 10.10.1.2

** Resolved to a different name server **
Non-existent domain, error (NXDOMAIN)  ← 间歇性失败

# 步骤2:测试DNS服务器可达性
$ ping 10.10.1.2
Reply from 10.10.1.2: bytes=32 time<1ms TTL=255  ← 可达

# 步骤3:直接测试DNS服务器
$ nslookup www.baidu.com 10.10.1.2
Server:  10.10.1.2
Address: 10.10.1.2

Name:    www.baidu.com
Address:  220.181.38.148  ← 直接查询正常!

# 步骤4:故障转移到了DNS转发环节
# 检查DNS服务器的转发配置
<Huawei> display dns
DNS server : 8.8.8.8, 114.114.114.114
DNS proxy : Enable

# 步骤5:在DNS服务器上抓包分析
$ tcpdump -i eth0 port 53 -w dns_capture.pcap
# 分析抓包发现:
# - 向8.8.8.8的DNS查询大量超时(无响应)
# - 向114.114.114.114的DNS查询正常
# → 8.8.8.8的国际DNS解析不稳定

# 步骤6:根因确认
# 公司DNS服务器配置了两个上游DNS:8.8.8.8(Google)和114.114.114.114
# 当8.8.8.8响应超时但尚未完全超时时,DNS服务器等待超时期间返回NXDOMAIN
# 当切换到114.114.114.114时解析正常

# 步骤7:修复
[Huawei] dns
[Huawei-dns] undo dns server 8.8.8.8
[Huawei-dns] dns server 119.29.29.29  # 使用国内稳定DNS
[Huawei-dns] dns server 114.114.114.114
[Huawei-dns] dns retry 2              # 减少重试次数
[Huawei-dns] dns timeout 2            # 缩短超时时间
[Huawei-dns] quit

# 步骤8:验证
# 连续24小时监控DNS解析成功率
# 解析成功率从92%提升至99.9%
4.3 案例3:OSPF邻居频繁Flapping
故障描述: 核心路由器Core-01与汇聚路由器Agg-03之间的OSPF邻居状态频繁在Full和Init之间切换(Flapping),每30秒一次。导致该方向的路由不稳定,部分业务间歇性中断。
排错过程:
# 步骤1:观察OSPF邻居状态
<Huawei> display ospf peer brief
Area Id: 0.0.0.0
Neighbor   Pri  State           Address         Interface
10.1.3.3    1   Full/DROther    10.1.3.3        GE1/0/1
# State在Full和Init之间切换

# 步骤2:查看OSPF日志
<Huawei> display logbuffer | include ospf
Mar 15 14:23:15 2024 %%%01OSPF/4/NeighborUp(l): OSPF Neighbor Up.
Mar 15 14:23:45 2024 %%%01OSPF/4/NeighborDown(l): OSPF Neighbor Down.
  Reason: Receive packet from other IP.
Mar 15 14:24:15 2024 %%%01OSPF/4/NeighborUp(l): OSPF Neighbor Up.
# → Reason: Receive packet from other IP ← 收到来自其他IP的OSPF报文

# 步骤3:检查接口IP配置
<Huawei> display ip interface brief GE1/0/1
Interface       IP Address      Physical Protocol
GE1/0/1         10.1.3.1/30     up       up

# 步骤4:在对端检查
<Agg-03> display ip interface brief GE1/0/2
Interface       IP Address      Physical Protocol
GE1/0/2         10.1.3.3/30     up       up
GE1/0/2.100     10.1.3.5/30     up       up  ← 子接口!

# 步骤5:根因分析
# Agg-03的GE1/0/2接口上有一个子接口GE1/0/2.100,也运行了OSPF
# 子接口的OSPF Hello报文从GE1/0/2物理端口发出,源IP为10.1.3.5
# Core-01收到源IP为10.1.3.5的OSPF报文,但邻居表中的IP是10.1.3.3
# → OSPF认为这是来自"其他IP"的报文,触发邻居Down

# 步骤6:修复方案
# 方案A:在子接口上关闭OSPF(推荐,如果子接口不需要OSPF)
[Agg-03] interface GE1/0/2.100
[Agg-03-GigabitEthernet1/0/2.100] undo ospf enable
[Agg-03-GigabitEthernet1/0/2.100] quit

# 方案B:在物理接口上配置OSPF忽略不同源的Hello
[Core-01] ospf 1
[Core-01-ospf-1] ignore hello-source-mismatch
[Core-01-ospf-1] quit

# 步骤7:验证
<Huawei> display ospf peer brief
Neighbor   Pri  State           Address         Interface
10.1.3.3    1   Full/DROther    10.1.3.3        GE1/0/1
# 持续观察30分钟,邻居状态稳定 ✓

# 步骤8:排查为什么会出现子接口OSPF
# 发现是3个月前的一个变更遗留:当时为VLAN 100配置了子接口OSPF,
# 但后来VLAN 100已迁移到其他链路,子接口OSPF未清理
4.4 排错检查清单(Checklist)
| 序号 | 检查项 | 命令/方法 | 正常标志 |
|---|---|---|---|
| 1 | 设备可达性 | ping 设备IP | 通 |
| 2 | 端口状态 | display interface brief | Up/Up |
| 3 | 光功率 | display transceiver | 在正常范围 |
| 4 | VLAN配置 | display vlan | VLAN存在且正确 |
| 5 | IP配置 | display ip interface brief | IP正确 |
| 6 | 路由表 | display ip routing-table | 路由存在 |
| 7 | ARP表 | display arp | ARP条目存在 |
| 8 | 防火墙策略 | display security-policy | 策略permit |
| 9 | 端到端连通性 | traceroute | 路径完整 |
| 10 | 应用端口 | telnet 服务器IP 端口 | 连接成功 |
4.5 培训体系设计
| 培训模块 | 内容 | 时长 | 方式 |
|---|---|---|---|
| 基础理论 | OSI模型、TCP/IP协议 | 2天 | 课堂 |
| 工具使用 | ping/traceroute/Wireshark | 1天 | 实操 |
| 排错方法 | 分段隔离、二分排除 | 1天 | 案例 |
| 案例演练 | 10个典型故障案例 | 3天 | 沙盘 |
| 实战带教 | 跟随资深工程师处理真实故障 | 4周 | 带教 |
| 独立排错 | 在监督下独立处理故障 | 4周 | 实践 |
五、经验总结
| 序号 | 经验类别 | 经验内容 | 适用场景 |
|---|---|---|---|
| 1 | 排错思路 | 先通后畅:先恢复连通性,再优化性能 | 所有故障 |
| 2 | 信息收集 | 充分的故障信息收集能节省50%的排错时间 | 故障响应 |
| 3 | 分段隔离 | OSI七层法是系统排错的基础框架 | 复杂故障 |
| 4 | 二分排除 | 每次排除一半,最快定位故障点 | 路径故障 |
| 5 | 证据驱动 | 基于数据做判断,避免凭经验猜测 | 所有故障 |
| 6 | 根因分析 | 5 Why法是找到根本原因的有效工具 | 故障复盘 |
| 7 | 工具熟练 | 熟练使用排错工具是基本功 | 日常排错 |
| 8 | 文档记录 | 排错过程必须详细记录,形成案例 | 知识沉淀 |
| 9 | 复盘改进 | 每次故障后必须复盘,避免重复故障 | 持续改进 |
| 10 | 心态管理 | 保持冷静、不慌不乱,是高效排错的前提 | 应急处理 |
思考
- 在大型分布式网络中,当故障可能涉及多个层级和多个设备时,如何确定排错的优先级和顺序?
- 自动化排错工具(如AIOps)能否完全替代人工排错?在什么场景下人工排错仍然不可替代?
- 如何将排错经验转化为可执行的自动化脚本,实现"一次排错,自动修复"?
下篇预告:第362篇:网络工程师的职业成长路径与技能树