第360篇:网络运维知识管理体系搭建
关键词:知识管理、故障案例库、SOP、运维体系、持续改进
一、案例背景
某大型企业的网络运维团队有30名工程师,负责管理覆盖全国200+站点的网络。团队面临以下痛点:
- 故障重复发生:相同类型故障每年重复发生3-5次,每次都需要重新排查
- 新人上手慢:新员工平均需要6个月才能独立处理故障
- 知识流失:核心员工离职后,积累的排错经验也随之流失
- 效率低下:故障平均解决时间(MTTR)为4小时,行业标杆为1小时
- 文档散乱:文档散落在个人电脑、邮件、即时通讯工具中,难以检索
目标:搭建网络运维知识管理体系,将MTTR降低至1.5小时以内,新人上手时间缩短至3个月。
二、需求分析与方案设计
2.1 知识管理体系架构
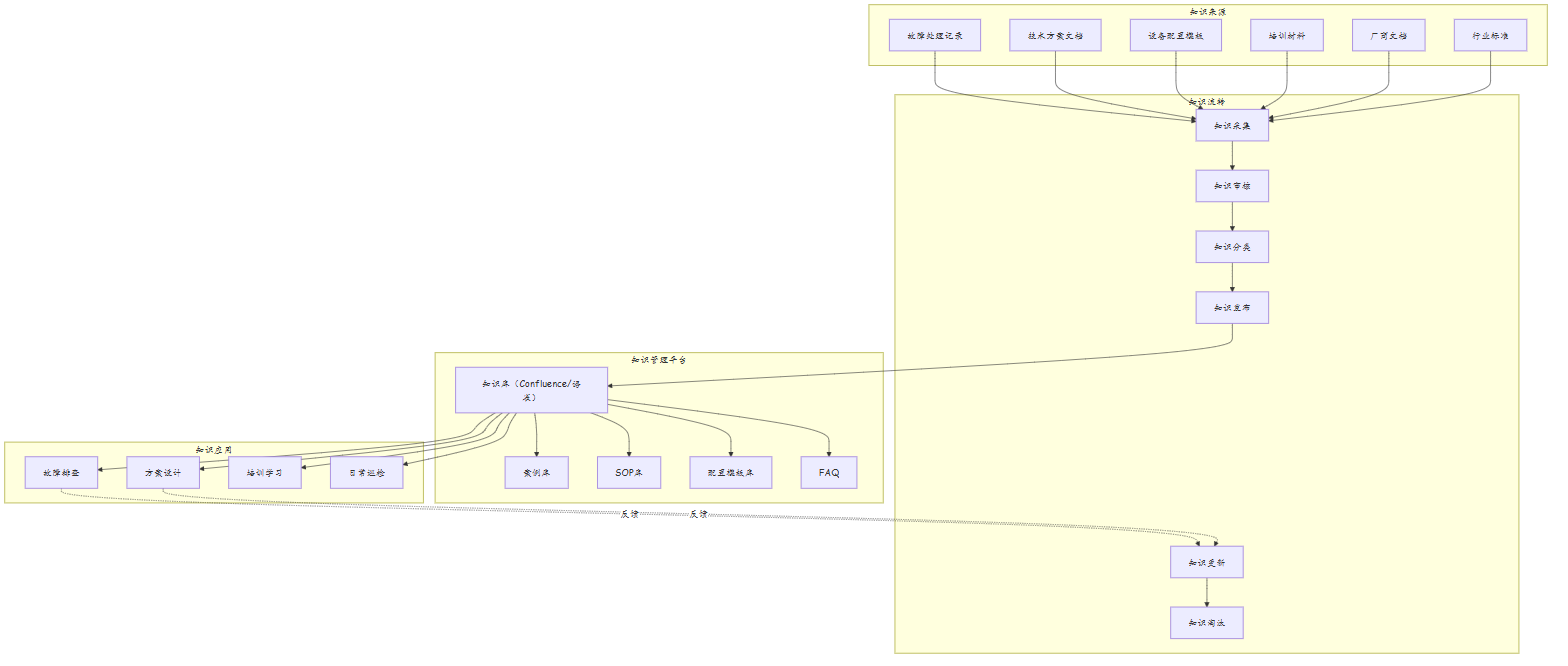
2.2 知识分类体系
| 一级分类 | 二级分类 | 三级分类 | 示例 |
|---|---|---|---|
| 故障案例 | 设备故障 | 交换机/路由器/防火墙 | BGP邻居Flapping排查 |
| 故障案例 | 协议故障 | OSPF/BGP/MPLS | OSPF次优路径分析 |
| 故障案例 | 业务故障 | 互联网/VPN/WiFi | WiFi频繁掉线优化 |
| 技术方案 | 组网方案 | 园区/DC/分支 | SPINE-LEAF设计方案 |
| 技术方案 | 安全方案 | 防火墙/IPS/WAF | 零信任网络方案 |
| SOP | 日常操作 | 巡检/备份/升级 | 日常巡检SOP |
| SOP | 故障处理 | 应急/回滚/升级 | 割接回滚SOP |
| 配置模板 | 设备配置 | 华为/Cisco/Juniper | BGP标准配置模板 |
| FAQ | 常见问题 | 连通性/性能/安全 | Ping不通排查流程 |
2.3 知识生命周期管理
| 阶段 | 责任人 | 操作 | 周期 |
|---|---|---|---|
| 采集 | 处理人 | 故障处理后24小时内提交 | 实时 |
| 审核 | 技术负责人 | 审核知识质量、准确性 | 3个工作日内 |
| 分类 | 知识管理员 | 按分类体系归类、打标签 | 审核通过后 |
| 发布 | 知识管理员 | 发布到知识库,通知相关人 | 分类完成后 |
| 使用 | 全员 | 搜索、引用、评论 | 持续 |
| 更新 | 原作者 | 根据反馈更新内容 | 半年一次 |
| 淘汰 | 技术委员会 | 评估知识时效性,淘汰过期内容 | 一年一次 |
2.4 知识管理成熟度模型
| 成熟度等级 | 特征描述 | 典型指标 |
|---|---|---|
| L0 初始级 | 知识散落在个人电脑和即时通讯中 | 文档覆盖率<20% |
| L1 萌芽级 | 建立了基本的文档存储,但无管理流程 | MTTR>4h |
| L2 规范级 | 有标准化的模板和审核流程 | MTTR<2h |
| L3 优化级 | 知识主动关联、智能推荐、自动更新 | MTTR<1h |
| L4 卓越级 | AI驱动的知识发现,预测性维护 | 故障预防率>60% |
三、技术细节与实施过程
3.1 知识库平台选型
| 平台 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| Confluence | 功能强大、插件丰富 | 部署复杂、成本高 | 大型团队 |
| 语雀 | 中文友好、易用 | 定制性差 | 中小型团队 |
| Notion | 灵活、美观 | 国内访问慢 | 国际化团队 |
| Wiki.js | 开源、可定制 | 功能相对简单 | 技术团队 |
| 自建系统 | 完全定制 | 开发维护成本高 | 特殊需求 |
最终选择:Confluence(企业版)+ Jira(故障管理)+ 自研知识检索工具
3.2 故障案例模板
# 故障案例模板

## 基本信息
- 故障编号:INC-2024-001
- 故障时间:2024-03-15 02:15
- 恢复时间:2024-03-15 03:00
- 影响范围:全省50万用户
- 故障等级:P1(重大)
- 处理人:张三

## 故障现象
(描述故障的具体表现)

## 排查过程
1. 第一步:检查xxx
2. 第二步:分析xxx
3. 第三步:定位xxx

## 根因分析
(详细分析故障的根本原因)

## 解决方案
(描述最终的解决方案和配置变更)

## 经验教训
- 教训1:xxx
- 教训2:xxx

## 改进措施
- 措施1:xxx
- 措施2:xxx

## 关联知识
- 相关案例:[案例链接]
- 相关SOP:[SOP链接]
- 相关配置:[配置模板链接]
3.2.1 知识库条目JSON Schema设计
知识库的核心数据结构应满足:结构化存储、全文检索、关联推荐、质量评估。以下为JSON Schema定义:
{
  "$schema": "http://json-schema.org/draft-07/schema#",
  "title": "KnowledgeBaseEntry",
  "type": "object",
  "required": ["id", "title", "category", "content", "tags", "author", "created_at"],
  "properties": {
    "id": {
      "type": "string",
      "pattern": "^KB-\\d{4}-\\d{3}$",
      "description": "唯一编号,格式KB-YYYY-NNN"
    },
    "title": {
      "type": "string",
      "minLength": 5,
      "maxLength": 200,
      "description": "案例标题"
    },
    "category": {
      "type": "object",
      "required": ["level1", "level2", "level3"],
      "properties": {
        "level1": { "type": "string", "enum": ["故障案例", "技术方案", "SOP", "配置模板", "FAQ"] },
        "level2": { "type": "string" },
        "level3": { "type": "string" }
      }
    },
    "severity": {
      "type": "string",
      "enum": ["P0-灾难", "P1-重大", "P2-一般", "P3-轻微", "N/A"],
      "description": "故障等级(仅故障案例需要)"
    },
    "content": {
      "type": "object",
      "required": ["phenomenon", "root_cause", "solution"],
      "properties": {
        "phenomenon": { "type": "string", "description": "故障现象描述" },
        "investigation_steps": {
          "type": "array",
          "items": { "type": "string" },
          "description": "排查步骤列表"
        },
        "root_cause": { "type": "string", "description": "根因分析" },
        "solution": { "type": "string", "description": "解决方案" },
        "lessons_learned": {
          "type": "array",
          "items": { "type": "string" },
          "description": "经验教训"
        },
        "prevention_measures": {
          "type": "array",
          "items": { "type": "string" },
          "description": "预防措施"
        }
      }
    },
    "tags": {
      "type": "array",
      "items": { "type": "string" },
      "minItems": 3,
      "maxItems": 15,
      "description": "标签列表(协议/设备/场景/根因等维度)"
    },
    "keywords": {
      "type": "array",
      "items": { "type": "string" },
      "description": "搜索关键词(用于全文检索)"
    },
    "metadata": {
      "type": "object",
      "properties": {
        "incident_id": { "type": "string", "description": "关联工单号" },
        "device_model": { "type": "string", "description": "涉及设备型号" },
        "device_vendor": { "type": "string", "description": "厂商" },
        "os_version": { "type": "string", "description": "系统版本" },
        "resolution_time_min": { "type": "integer", "description": "解决耗时(分钟)" },
        "affected_users": { "type": "integer", "description": "影响用户数" },
        "repeated_count": { "type": "integer", "default": 0, "description": "同类故障重复次数" }
      }
    },
    "relations": {
      "type": "object",
      "properties": {
        "related_cases": {
          "type": "array",
          "items": { "type": "string" },
          "description": "关联案例ID列表"
        },
        "related_sops": {
          "type": "array",
          "items": { "type": "string" },
          "description": "关联SOP ID列表"
        },
        "related_configs": {
          "type": "array",
          "items": { "type": "string" },
          "description": "关联配置模板ID"
        }
      }
    },
    "quality": {
      "type": "object",
      "properties": {
        "score": { "type": "number", "minimum": 0, "maximum": 100, "description": "质量评分" },
        "review_status": {
          "type": "string",
          "enum": ["draft", "pending_review", "approved", "rejected", "archived"]
        },
        "reviewer": { "type": "string" },
        "reviewed_at": { "type": "string", "format": "date-time" },
        "view_count": { "type": "integer", "default": 0 },
        "cited_count": { "type": "integer", "default": 0 },
        "useful_count": { "type": "integer", "default": 0 }
      }
    },
    "author": { "type": "string" },
    "created_at": { "type": "string", "format": "date-time" },
    "updated_at": { "type": "string", "format": "date-time" },
    "version": { "type": "integer", "default": 1 }
  }
}
Schema设计原则:
- id 全局唯一,支持按日期自增
- category 三级分类体系,与检索菜单一致
- tags 多维标签(协议/设备/场景/根因),支持组合过滤
- relations 关联引用,形成知识图谱
- quality 质量追踪,支持评分、审核、使用统计
3.3 SOP标准化
# SOP模板:设备配置备份

## 适用范围
所有华为/思科网络设备的配置备份操作

## 前置条件
- 已获取设备SSH访问权限
- 已配置TFTP/SCP服务器

## 操作步骤

### 步骤1:登录设备
```bash
ssh admin@<device_ip>
步骤2:执行备份命令
华为设备:
save force
scp startup.cfg backup@server:/backup/<hostname>_$(date +%Y%m%d).cfg
Cisco设备:
copy running-config tftp
步骤3:验证备份
# 在备份服务器上验证文件完整性
md5sum /backup/<hostname>_*.cfg
注意事项
- 备份时间选择业务低谷期
- 备份文件必须异地存储
- 备份文件保留至少30天
常见问题
- Q: SCP连接失败怎么办?
- A: 检查防火墙策略,确保TCP 22端口放行
### 3.4 知识检索工具

```python
# 简单的知识检索工具(基于Elasticsearch)
from elasticsearch import Elasticsearch

es = Elasticsearch(['http://es-server:9200'])

def search_knowledge(query, category=None, limit=10):
    """搜索知识库"""
    search_body = {
        "query": {
            "multi_match": {
                "query": query,
                "fields": ["title^3", "content^2", "tags^1", "keywords^2"]
            }
        },
        "highlight": {
            "fields": {
                "content": {}
            }
        }
    }

    if category:
        search_body["query"]["filter"] = {
            "term": {"category": category}
        }

    search_body["size"] = limit

    result = es.search(index="knowledge_base", body=search_body)

    for hit in result["hits"]["hits"]:
        print(f"Title: {hit['_source']['title']}")
        print(f"Category: {hit['_source']['category']}")
        print(f"Relevance: {hit['_score']}")
        print("---")

# 使用示例
search_knowledge("BGP邻居无法建立", category="故障案例")
search_knowledge("OSPF", category="技术方案")
3.5 从工单自动提取案例生成知识库条目
在运维流程中,故障处理完毕后通常会在工单系统中留下完整记录。以下脚本自动解析工单数据,提取关键信息并生成标准化的知识库条目。
#!/usr/bin/env python3
"""
ticket_to_kb.py — 从工单自动提取案例生成知识库条目
功能: 工单解析 → 信息提取 → 标签生成 → 去重 → 入库
依赖: pip install jieba hashlib datetime
"""
import json
import hashlib
import re
from datetime import datetime
from pathlib import Path
import jieba


# ====== 1. 工单解析器 ======
class TicketParser:
    """解析工单JSON/Dict,提取结构化信息"""

    PROTOCOL_KEYWORDS = {
        "BGP": ["bgp", "peer", "neighbor", "as-path", "route-reflector"],
        "OSPF": ["ospf", "area", "dr", "bdr", "lsa"],
        "MPLS": ["mpls", "vpn", "vrf", "ldp", "label", "te"],
        "VXLAN": ["vxlan", "vtep", "vni", "evpn"],
        "BFD": ["bfd", "session"],
        "ISIS": ["isis", "level", "net"],
        "PIM": ["pim", "sm", "dm", "rp"],
        "DHCP": ["dhcp", "relay", "option"],
    }

    VENDOR_KEYWORDS = {
        "华为": ["huawei", "ce68", "ce128", "ne40", "ne80", "ar6", "vrp"],
        "Cisco": ["cisco", "ios", "nx-os", "asr", "n9k", "csr"],
        "Juniper": ["juniper", "junos", "mx", "qfx", "ptx"],
    }

    ROOT_CAUSE_PATTERNS = [
        r"(?i)(根因|root.?cause|原因|cause)[::\s]*(.+?)(?:\n|$)",
        r"(?i)(结论|conclusion|finding)[::\s]*(.+?)(?:\n|$)",
        r"(?i)(分析结果|analysis)[::\s]*(.+?)(?:\n|$)",
    ]

    SOLUTION_PATTERNS = [
        r"(?i)(解决方案|solution|修复|fix|resolution)[::\s]*(.+?)(?:\n|$)",
        r"(?i)(操作|action|change)[::\s]*(.+?)(?:\n|$)",
    ]

    def __init__(self, ticket: dict):
        self.ticket = ticket
        self.raw_text = json.dumps(ticket, ensure_ascii=False)

    def parse(self) -> dict:
        """解析工单,返回结构化数据"""
        return {
            "title": self._extract_title(),
            "phenomenon": self._extract_field("description") or self._extract_field("summary"),
            "investigation_steps": self._extract_field("steps") or self._extract_steps(),
            "root_cause": self._extract_root_cause(),
            "solution": self._extract_solution(),
            "severity": self._extract_severity(),
            "tags": self._generate_tags(),
            "keywords": self._generate_keywords(),
            "metadata": self._extract_metadata(),
        }

    def _extract_field(self, field: str) -> str:
        return self.ticket.get(field, "") or ""

    def _extract_title(self) -> str:
        """提取或生成标题"""
        title = self._extract_field("title") or self._extract_field("subject")
        if not title:
            summary = self._extract_field("summary") or ""
            title = summary[:50] + "..." if len(summary) > 50 else summary
        return title or "未命名案例"

    def _extract_steps(self) -> list[str]:
        """从处理记录中提取步骤"""
        history = self.ticket.get("history", [])
        steps = []
        for entry in history:
            action = entry.get("action", "")
            comment = entry.get("comment", "")
            if action and comment:
                steps.append(f"[{action}] {comment}")
        return steps[:10]  # 取前10步

    def _extract_root_cause(self) -> str:
        """提取根因"""
        rc = self._extract_field("root_cause") or self._extract_field("cause")
        if rc:
            return rc
        for pattern in self.ROOT_CAUSE_PATTERNS:
            match = re.search(pattern, self.raw_text)
            if match:
                return match.group(1).strip()
        return ""

    def _extract_solution(self) -> str:
        """提取解决方案"""
        sol = self._extract_field("solution") or self._extract_field("resolution")
        if sol:
            return sol
        for pattern in self.SOLUTION_PATTERNS:
            match = re.search(pattern, self.raw_text, re.DOTALL)
            if match:
                return match.group(1).strip()
        return ""

    def _extract_severity(self) -> str:
        severity = self.ticket.get("severity", "").upper()
        mapping = {
            "P0": "P0-灾难", "P1": "P1-重大", "P2": "P2-一般", "P3": "P3-轻微",
            "CRITICAL": "P0-灾难", "HIGH": "P1-重大", "MEDIUM": "P2-一般", "LOW": "P3-轻微",
        }
        return mapping.get(severity, "P2-一般")

    def _generate_tags(self) -> list[str]:
        """基于关键词自动生成标签"""
        tags = set()
        text_lower = self.raw_text.lower()

        # 协议标签
        for proto, keywords in self.PROTOCOL_KEYWORDS.items():
            if any(kw in text_lower for kw in keywords):
                tags.add(f"协议:{proto}")

        # 厂商标签
        for vendor, keywords in self.VENDOR_KEYWORDS.items():
            if any(kw in text_lower for kw in keywords):
                tags.add(f"厂商:{vendor}")

        # 场景标签
        if any(w in text_lower for w in ["断网", "中断", "down", "unreachable"]):
            tags.add("场景:连通性故障")
        if any(w in text_lower for w in ["慢", "延迟", "delay", "latency"]):
            tags.add("场景:性能问题")
        if any(w in text_lower for w in ["丢包", "loss", "packet loss"]):
            tags.add("场景:丢包")
        if any(w in text_lower for w in ["flap", "震荡", "振荡", "频繁"]):
            tags.add("场景:震荡")

        # 设备类型
        if any(w in text_lower for w in ["switch", "交换机", "ce68", "ce128"]):
            tags.add("设备:交换机")
        if any(w in text_lower for w in ["router", "路由器", "ne40", "ne80"]):
            tags.add("设备:路由器")

        # 保证至少3个标签
        if len(tags) < 3:
            tags.add("运维:故障处理")

        return sorted(tags)

    def _generate_keywords(self) -> list[str]:
        """使用jieba分词生成搜索关键词"""
        text = f"{self._extract_title()} {self._extract_field('description') or ''} " \
               f"{self._extract_root_cause()} {self._extract_solution()}"
        words = jieba.lcut(text)
        # 过滤停用词和太短的词
        stop_words = {"的", "了", "在", "是", "我", "有", "和", "就", "不", "人",
                      "都", "一", "一个", "上", "也", "很", "到", "说", "要", "去",
                      "你", "会", "着", "没有", "看", "好", "自己", "这"}
        keywords = [w for w in words if len(w) > 1 and w not in stop_words]
        return list(set(keywords))[:20]  # 最多20个关键词

    def _extract_metadata(self) -> dict:
        return {
            "incident_id": self.ticket.get("id", ""),
            "device_model": self.ticket.get("device_model", ""),
            "device_vendor": self.ticket.get("vendor", ""),
            "resolution_time_min": self._calc_resolution_time(),
            "affected_users": self.ticket.get("affected_users", 0),
        }

    def _calc_resolution_time(self) -> int:
        """计算解决耗时(分钟)"""
        created = self.ticket.get("created_at", "")
        resolved = self.ticket.get("resolved_at", "")
        if created and resolved:
            try:
                t1 = datetime.fromisoformat(created.replace("Z", "+00:00"))
                t2 = datetime.fromisoformat(resolved.replace("Z", "+00:00"))
                return int((t2 - t1).total_seconds() / 60)
            except ValueError:
                pass
        return 0


# ====== 2. 去重引擎 ======
class DedupEngine:
    """基于内容相似度的去重引擎"""

    def __init__(self, existing_entries: list[dict]):
        self.existing = existing_entries
        self._signatures = []
        for entry in existing_entries:
            sig = self._compute_signature(entry)
            self._signatures.append(sig)

    @staticmethod
    def _compute_signature(entry: dict) -> str:
        """计算内容签名(标题+根因的hash)"""
        content = f"{entry.get('title', '')}|{entry.get('content', {}).get('root_cause', '')}"
        return hashlib.md5(content.encode()).hexdigest()

    def is_duplicate(self, new_entry: dict, threshold: float = 0.8) -> tuple[bool, str]:
        """
        判断是否重复

        Returns:
            (is_dup, dup_id) — 是否重复,重复条目的ID
        """
        new_sig = self._compute_signature(new_entry)

        # 精确匹配(签名相同)
        for i, sig in enumerate(self._signatures):
            if sig == new_sig:
                return True, self.existing[i]["id"]

        # 模糊匹配(标题相似度)
        new_title = new_entry.get("title", "").lower()
        for entry in self.existing:
            old_title = entry.get("title", "").lower()
            similarity = self._jaccard_similarity(new_title, old_title)
            if similarity > threshold:
                return True, entry["id"]

        return False, ""

    @staticmethod
    def _jaccard_similarity(s1: str, s2: str) -> float:
        """Jaccard相似度(基于词集合)"""
        set1 = set(jieba.lcut(s1))
        set2 = set(jieba.lcut(s2))
        if not set1 or not set2:
            return 0.0
        intersection = set1 & set2
        union = set1 | set2
        return len(intersection) / len(union)


# ====== 3. 知识库写入器 ======
class KnowledgeBaseWriter:
    """将条目写入知识库(JSON文件存储,可替换为ES/数据库)"""

    def __init__(self, kb_dir: str = "knowledge_base"):
        self.kb_dir = Path(kb_dir)
        self.kb_dir.mkdir(parents=True, exist_ok=True)
        self.index_file = self.kb_dir / "index.json"
        self._load_index()

    def _load_index(self):
        if self.index_file.exists():
            self.index = json.loads(self.index_file.read_text())
        else:
            self.index = {"entries": [], "next_seq": 1}

    def _save_index(self):
        self.index_file.write_text(json.dumps(self.index, ensure_ascii=False, indent=2))

    def add_entry(self, entry: dict) -> str:
        """添加条目,返回条目ID"""
        seq = self.index["next_seq"]
        year = datetime.now().strftime("%Y")
        entry_id = f"KB-{year}-{seq:03d}"
        entry["id"] = entry_id
        entry["created_at"] = datetime.now().isoformat()
        entry["updated_at"] = entry["created_at"]
        entry["version"] = 1
        entry.setdefault("quality", {}).update({
            "review_status": "pending_review",
            "view_count": 0, "cited_count": 0, "useful_count": 0
        })

        # 写入独立文件
        entry_file = self.kb_dir / f"{entry_id}.json"
        entry_file.write_text(json.dumps(entry, ensure_ascii=False, indent=2))

        # 更新索引
        self.index["entries"].append(entry_id)
        self.index["next_seq"] = seq + 1
        self._save_index()

        return entry_id


# ====== 4. 主流程 ======
def process_ticket(ticket: dict, kb_dir: str = "knowledge_base") -> dict:
    """
    处理单个工单,生成知识库条目

    Args:
        ticket: 工单字典
        kb_dir: 知识库目录

    Returns:
        处理结果
    """
    # 1. 解析工单
    parser = TicketParser(ticket)
    parsed = parser.parse()

    # 2. 组装知识库条目
    entry = {
        "title": parsed["title"],
        "category": {
            "level1": "故障案例",
            "level2": "协议故障",
            "level3": ""
        },
        "severity": parsed["severity"],
        "content": {
            "phenomenon": parsed["phenomenon"],
            "investigation_steps": parsed["investigation_steps"],
            "root_cause": parsed["root_cause"],
            "solution": parsed["solution"],
            "lessons_learned": [],
            "prevention_measures": []
        },
        "tags": parsed["tags"],
        "keywords": parsed["keywords"],
        "metadata": parsed["metadata"],
        "relations": {"related_cases": [], "related_sops": [], "related_configs": []},
    }

    # 3. 去重检查
    writer = KnowledgeBaseWriter(kb_dir)
    dedup = DedupEngine(writer.index.get("entries", []))
    is_dup, dup_id = dedup.is_duplicate(entry)

    if is_dup:
        return {
            "status": "duplicate",
            "duplicate_id": dup_id,
            "title": parsed["title"],
            "message": f"与已有条目 {dup_id} 重复"
        }

    # 4. 写入知识库
    entry_id = writer.add_entry(entry)
    return {
        "status": "created",
        "id": entry_id,
        "title": parsed["title"],
        "tags": parsed["tags"],
        "message": f"成功创建知识库条目 {entry_id}"
    }


if __name__ == "__main__":
    # 示例工单
    sample_ticket = {
        "id": "INC-2024-0156",
        "title": "BGP邻居频繁Flapping导致部分站点无法上网",
        "description": "某站点BGP邻居状态在Established和Idle之间反复切换,导致站点Internet访问中断",
        "severity": "P1",
        "root_cause": "对端设备CPU利用率高达95%,无法及时响应BGP Keepalive报文,导致会话超时断开",
        "solution": "在对端设备上优化BGP路由表(汇总路由),降低CPU利用率;同时调整BGP Hold Time从18s到60s",
        "device_model": "NE40E-X8",
        "vendor": "Huawei",
        "created_at": "2024-03-15T02:15:00Z",
        "resolved_at": "2024-03-15T04:30:00Z",
        "affected_users": 50000,
        "history": [
            {"action": "诊断", "comment": "检查BGP邻居状态,发现Flapping"},
            {"action": "排查", "comment": "检查对端设备CPU利用率"},
            {"action": "修复", "comment": "优化路由表并调整Hold Time"},
        ]
    }

    result = process_ticket(sample_ticket)
    print(json.dumps(result, ensure_ascii=False, indent=2))
工单解析Pipeline:
| 阶段 | 输入 | 处理 | 输出 |
|---|---|---|---|
| 1. 工单采集 | Jira/ServiceNow API | 拉取已解决的工单 | 工单JSON |
| 2. 信息提取 | 工单JSON | 解析标题/现象/根因/方案 | 结构化数据 |
| 3. 标签生成 | 全文文本 | 关键词匹配+分词 | 协议/厂商/场景标签 |
| 4. 去重检查 | 新条目vs已有库 | MD5签名+Jaccard相似度 | 重复判定 |
| 5. 入库 | 去重后条目 | 写入JSON/ES/数据库 | 知识库条目 |
| 6. 审核通知 | 新条目 | 邮件/IM通知审核人 | 待审核队列 |
四、实战案例:知识管理体系落地
4.1 案例:某运营商网络运维知识体系建设
项目背景: 某省级运营商网络运维团队有30名工程师,负责全省200+站点的传输网、数据网、无线核心网。团队面临典型"知识流失"问题:3名资深工程师离职后,其积累的特殊排错经验随之丢失;新人平均需要6个月才能独立处理故障。
实施过程(6个月):
第1个月:平台搭建与模板设计
# 知识贡献激励制度(示例)

## 积分规则
| 行为 | 积分 | 说明 |
|------|------|------|
| 提交一篇故障案例 | +20分 | 需通过审核 |
| 案例被引用 | +5分/次 | 自动累计 |
| 案例被评为优秀 | +50分 | 月度评选 |
| 审核一篇案例 | +10分 | 技术负责人 |
| 更新一篇过期案例 | +15分 | 保持知识时效 |
| 评论有价值的案例 | +2分 | 促进交流 |

## 积分兑换
| 积分 | 奖励 |
|------|------|
| 100分 | 技术书籍一本 |
| 300分 | 外部培训机会 |
| 500分 | 年度优秀员工评选优先 |
| 1000分 | 技术大会门票 |
第2-3个月:历史案例迁移
| 迁移类别 | 数量 | 迁移方式 | 质量分级 |
|---|---|---|---|
| 重大故障报告 | 85份 | 逐篇改写为标准模板 | S级(审核通过) |
| 日常排错记录 | 320份 | 批量导入+人工整理 | A级(需补充) |
| 技术方案文档 | 120份 | 直接迁移+打标签 | B级(待审核) |
| 配置模板 | 65份 | 模板标准化 | A级 |
第4个月:SOP编写与标准化
# SOP示例:BGP邻居Down应急处理

## 适用场景
BGP邻居状态非Established

## 前置检查
- [ ] 确认IP路由可达(ping对端BGP Peer IP)
- [ ] 确认TCP 179端口可达(telnet 对端IP 179)
- [ ] 确认本地BGP进程运行正常

## 排查步骤

### 步骤1:检查BGP邻居状态
```bash
display bgp peer <peer-ip>
# 关注字段:State、Uptime、Message statistics
步骤2:根据状态码定位
| 状态码 | 含义 | 排查方向 |
|---|---|---|
| Idle | 初始状态,未收到Open | 检查IP/TCP连通性 |
| Connect | 等待TCP连接 | 检查防火墙策略 |
| Active | 尝试建立TCP | 检查对端BGP配置 |
| OpenSent | 已发送Open | 检查AS号、版本 |
| OpenConfirm | 已收到Open | 检查Router ID |
| Establish | 正常 | 无故障 |
步骤3:查看BGP日志
display logbuffer | include bgp
# 关注:Notification消息、Keepalive超时
常见根因TOP5
- TCP 179端口被防火墙阻断(30%)
- AS号配置错误(20%)
- Router ID冲突(15%)
- eBGP Max-Hop不足(15%)
- MD5认证密码不一致(10%)
关联知识
- 故障案例:INC-2024-015 BGP邻居频繁Flapping
- 配置模板:BGP eBGP标准配置模板 ```
第5-6个月:全员培训与推广
| 培训对象 | 培训内容 | 培训方式 | 考核方式 |
|---|---|---|---|
| 全员 | 知识库使用规范 | 线上课程+考试 | 在线考试≥80分 |
| 技术骨干 | 案例编写规范 | 线下工作坊 | 提交1篇案例 |
| 新人 | 知识库检索技巧 | 导师带教 | 独立完成1次检索 |
4.2 知识管理实施里程碑
| 阶段 | 时间 | 里程碑 | 成果 |
|---|---|---|---|
| 准备 | 第1月 | 平台部署、模板设计 | 平台上线 |
| 采集 | 第2-3月 | 历史案例迁移 | 500+案例入库 |
| 规范 | 第4月 | SOP编写、模板标准化 | 100+SOP |
| 推广 | 第5-6月 | 全员培训、使用规范 | 全员使用 |
| 优化 | 第7-12月 | 持续改进、质量提升 | MTTR下降60% |
4.3 实施效果
| 指标 | 实施前 | 实施后 | 改善 |
|---|---|---|---|
| MTTR(平均故障解决时间) | 4小时 | 1.2小时 | ↓70% |
| 新人上手时间 | 6个月 | 2.5个月 | ↓58% |
| 故障重复率 | 30% | 5% | ↓83% |
| 知识检索成功率 | 20% | 85% | ↑325% |
| 文档覆盖率 | 30% | 95% | ↑217% |
4.4 知识统计
| 知识类型 | 数量 | 月均新增 | 月均更新 |
|---|---|---|---|
| 故障案例 | 520 | 15 | 8 |
| 技术方案 | 85 | 3 | 2 |
| SOP文档 | 120 | 5 | 3 |
| 配置模板 | 65 | 2 | 1 |
| FAQ | 200 | 10 | 5 |
4.5 知识库质量评估指标体系
| 指标 | 定义 | 计算方式 | 目标值 | 权重 |
|---|---|---|---|---|
| 完整性 | 条目必填字段填充率 | 必填字段已填数/必填字段总数 | ≥95% | 25% |
| 准确性 | 技术内容正确性 | 审核通过率 = 通过数/提交总数 | ≥90% | 25% |
| 时效性 | 条目与当前版本的一致性 | 近6个月未更新的条目占比 | ≤20% | 15% |
| 覆盖率 | 故障类型被知识库覆盖的比例 | 有对应案例的故障类型/总故障类型 | ≥80% | 15% |
| 检索率 | 搜索请求找到相关条目的比例 | 有结果的搜索/总搜索次数 | ≥85% | 10% |
| 使用率 | 知识条目的实际被引用频率 | 月均被引用次数/条目总数 | ≥0.5次/月 | 5% |
| 满意度 | 用户对知识条目的有用评价 | 点赞数/总浏览数 | ≥60% | 5% |
综合质量评分 = 完整性×25% + 准确性×25% + 时效性×15% + 覆盖率×15% + 检索率×10% + 使用率×5% + 满意度×5%
质量分级: - A级(≥90分):优秀,可作为标杆案例 - B级(75-89分):良好,持续使用 - C级(60-74分):一般,需要补充完善 - D级(<60分):差,建议重写或归档
4.6 案例沉淀全流程Mermaid图
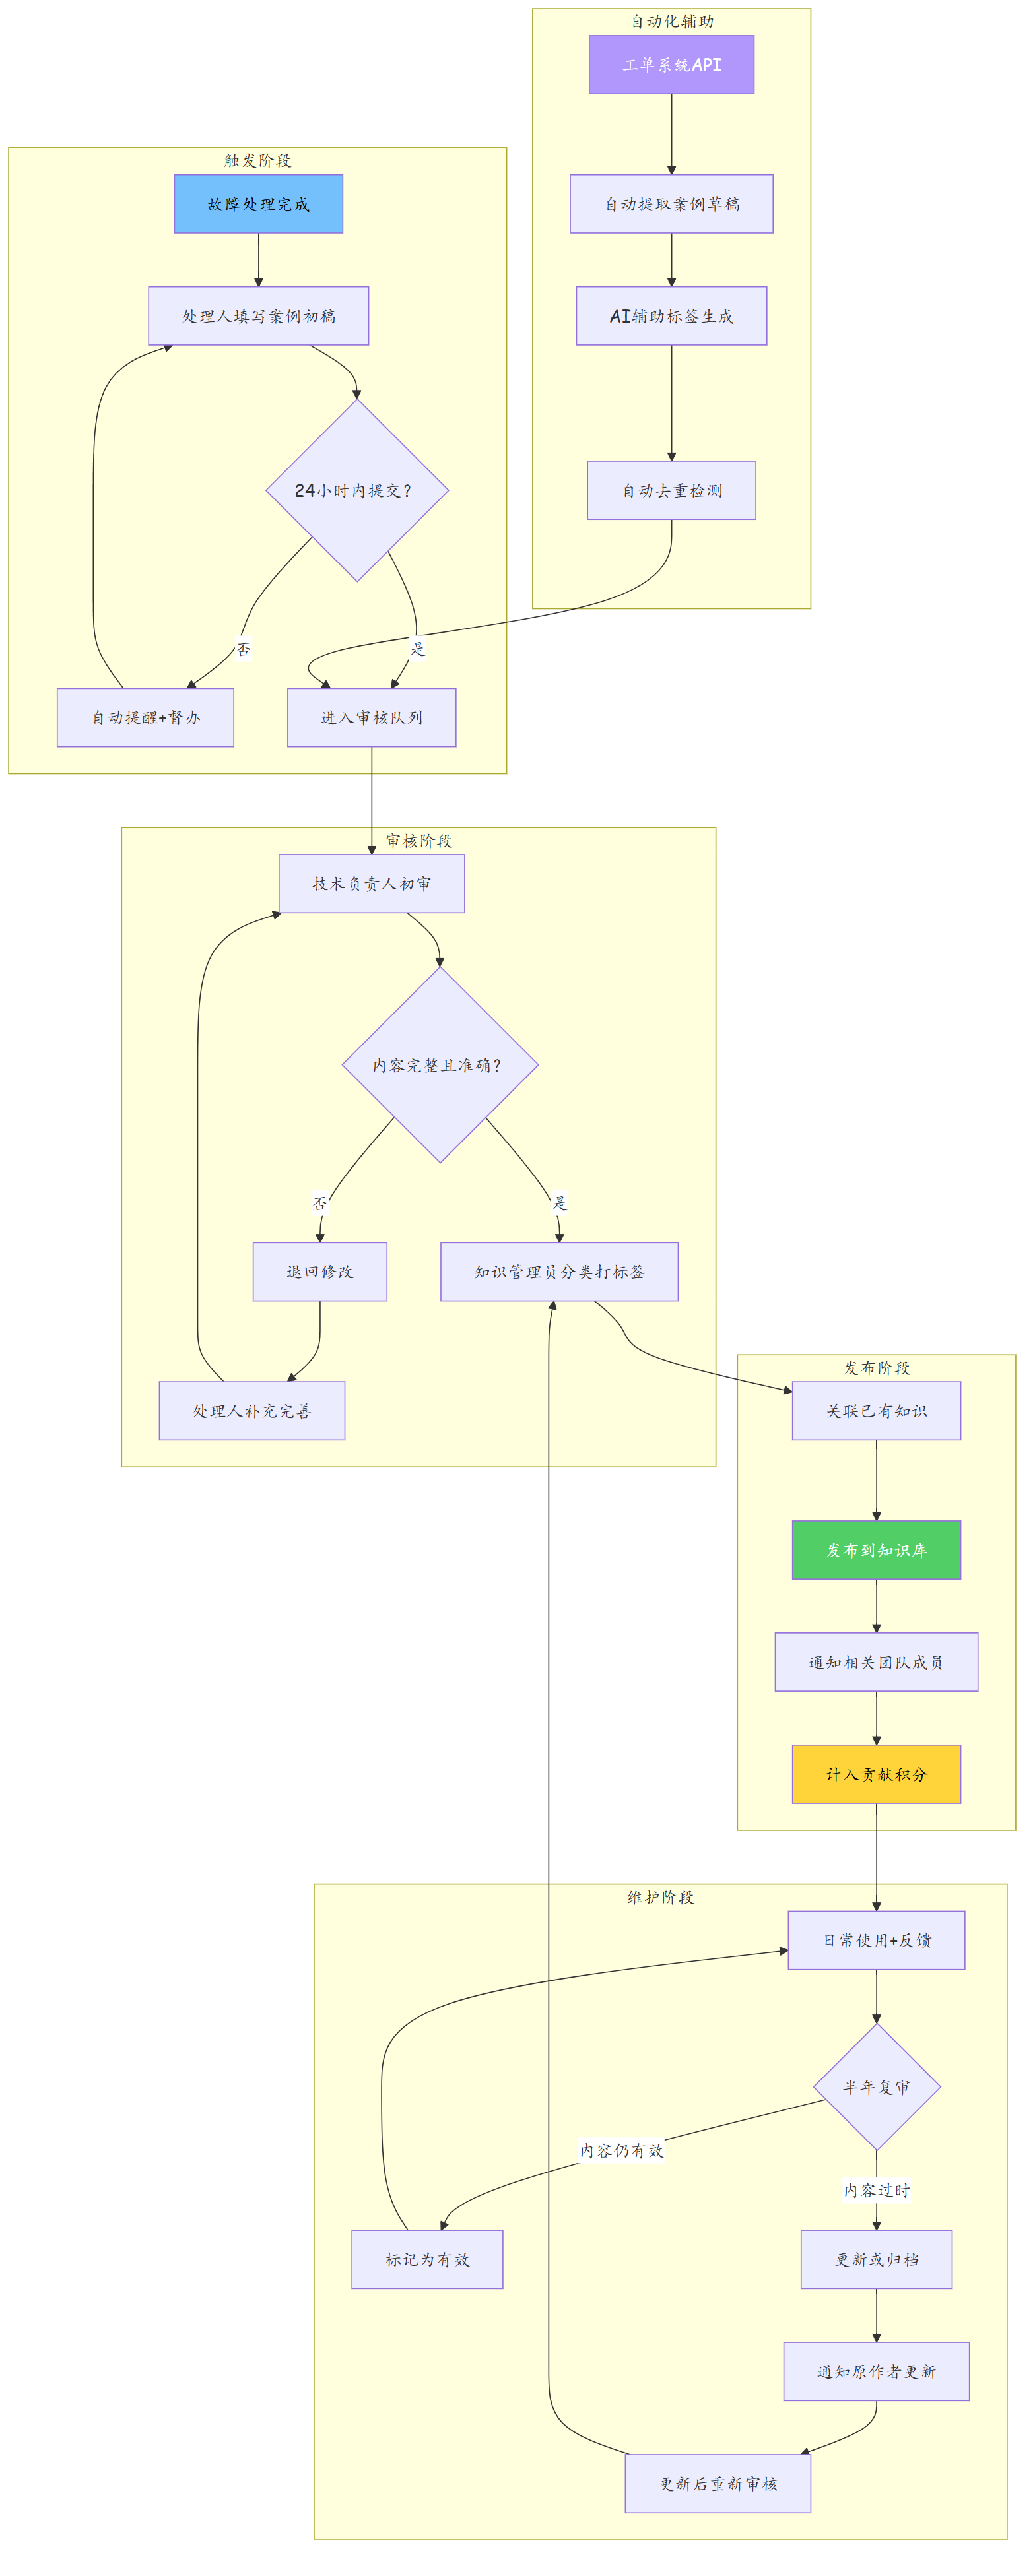
案例沉淀时效要求:
| 故障等级 | 提交时限 | 审核时限 | 发布时限 | 复审周期 |
|---|---|---|---|---|
| P0(灾难) | 24小时内 | 1个工作日 | 审核通过后即时 | 3个月 |
| P1(重大) | 48小时内 | 2个工作日 | 审核通过后即时 | 6个月 |
| P2(一般) | 1周内 | 3个工作日 | 批量发布(每周) | 12个月 |
| P3(轻微) | 2周内 | 5个工作日 | 批量发布(每月) | 12个月 |
五、经验总结
| 序号 | 经验类别 | 经验内容 | 适用场景 |
|---|---|---|---|
| 1 | 体系建设 | 知识管理不只是一个工具,更是一套管理体系 | 知识管理 |
| 2 | 模板化 | 标准化的模板是知识质量的基础保障 | 知识采集 |
| 3 | 激励机制 | 建立知识贡献的激励机制,鼓励全员参与 | 团队管理 |
| 4 | 审核机制 | 知识必须经过审核才能发布,保证准确性 | 质量控制 |
| 5 | 持续更新 | 知识必须定期更新,过时知识比没有知识更危险 | 知识维护 |
| 6 | 易用性 | 知识检索必须简单快捷,否则没人会用 | 用户体验 |
| 7 | 分类体系 | 科学的分类体系是知识检索的前提 | 知识组织 |
| 8 | 与流程结合 | 知识管理必须与故障处理、变更管理等流程结合 | 流程管理 |
| 9 | 培训推广 | 全员培训是知识管理体系成功的关键 | 变革管理 |
| 10 | 度量改进 | 通过指标度量知识管理的效果,持续改进 | 持续改进 |
思考
- 知识管理体系中,如何平衡"知识标准化"与"知识灵活性"?过于标准化是否会抑制创新?
- AI大模型能否替代传统的知识库检索?在什么场景下AI检索比关键词检索更有效?
- 如何设计知识贡献的激励机制,使工程师有动力主动分享知识和经验?
下篇预告:第361篇:新员工如何快速掌握网络排错方法论