第365篇:数通技术的未来:AI 与网络深度融合
关键词:AI网络、意图驱动网络、AIOps、数字孪生、自动驾驶网络、算网融合
一、引言
这是本系列365篇文章的终篇。从第一篇的网络基础概念,到最后一篇的AI与网络融合,我们走过了从OSI七层模型到自动驾驶网络的完整旅程。今天,AI正在重塑网络技术的每一个角落,从故障预测到自动排障,从智能运维到意图驱动网络,AI与数通技术的深度融合正在开启一个全新的时代。
AI正在改变网络的方方面面:
| 传统方式 | AI赋能后 | 改变幅度 |
|---|---|---|
| 人工配置 | 意图驱动自动生成配置 | 效率提升10倍+ |
| 被动告警 | 主动预测(提前4-24小时) | 从救火到预防 |
| 经验排错 | AI辅助根因分析 | 排错时间缩短80% |
| 静态拓扑 | 数字孪生实时仿真 | 决策有据可依 |
| 定期巡检 | 实时Telemetry+AI分析 | 全覆盖无盲区 |
1.2 网络技术的演进脉络
回顾从1990年代至今的通信技术演进,可以清晰看到网络技术的四条核心趋势:
| 年代 | 代表技术 | 核心理念 | 运维方式 |
|---|---|---|---|
| 1990s | RIP/OSPF/BGP/IS-IS | 路由协议标准化 | 手工CLI配置 |
| 2000s | MPLS/L3VPN/TE | 流量工程与业务隔离 | 模板化配置 |
| 2010s | SDN/NFV/VXLAN/EVPN | 控制面与转发面分离 | 自动化编排 |
| 2020s+ | AI原生/算力网络/数字孪生 | 数据驱动与自治 | AI辅助决策 |
四条不变的趋势:从手工到自动化、从封闭到开放、从硬件到软件、从人工运维到AI自治。
二、需求分析与方案设计
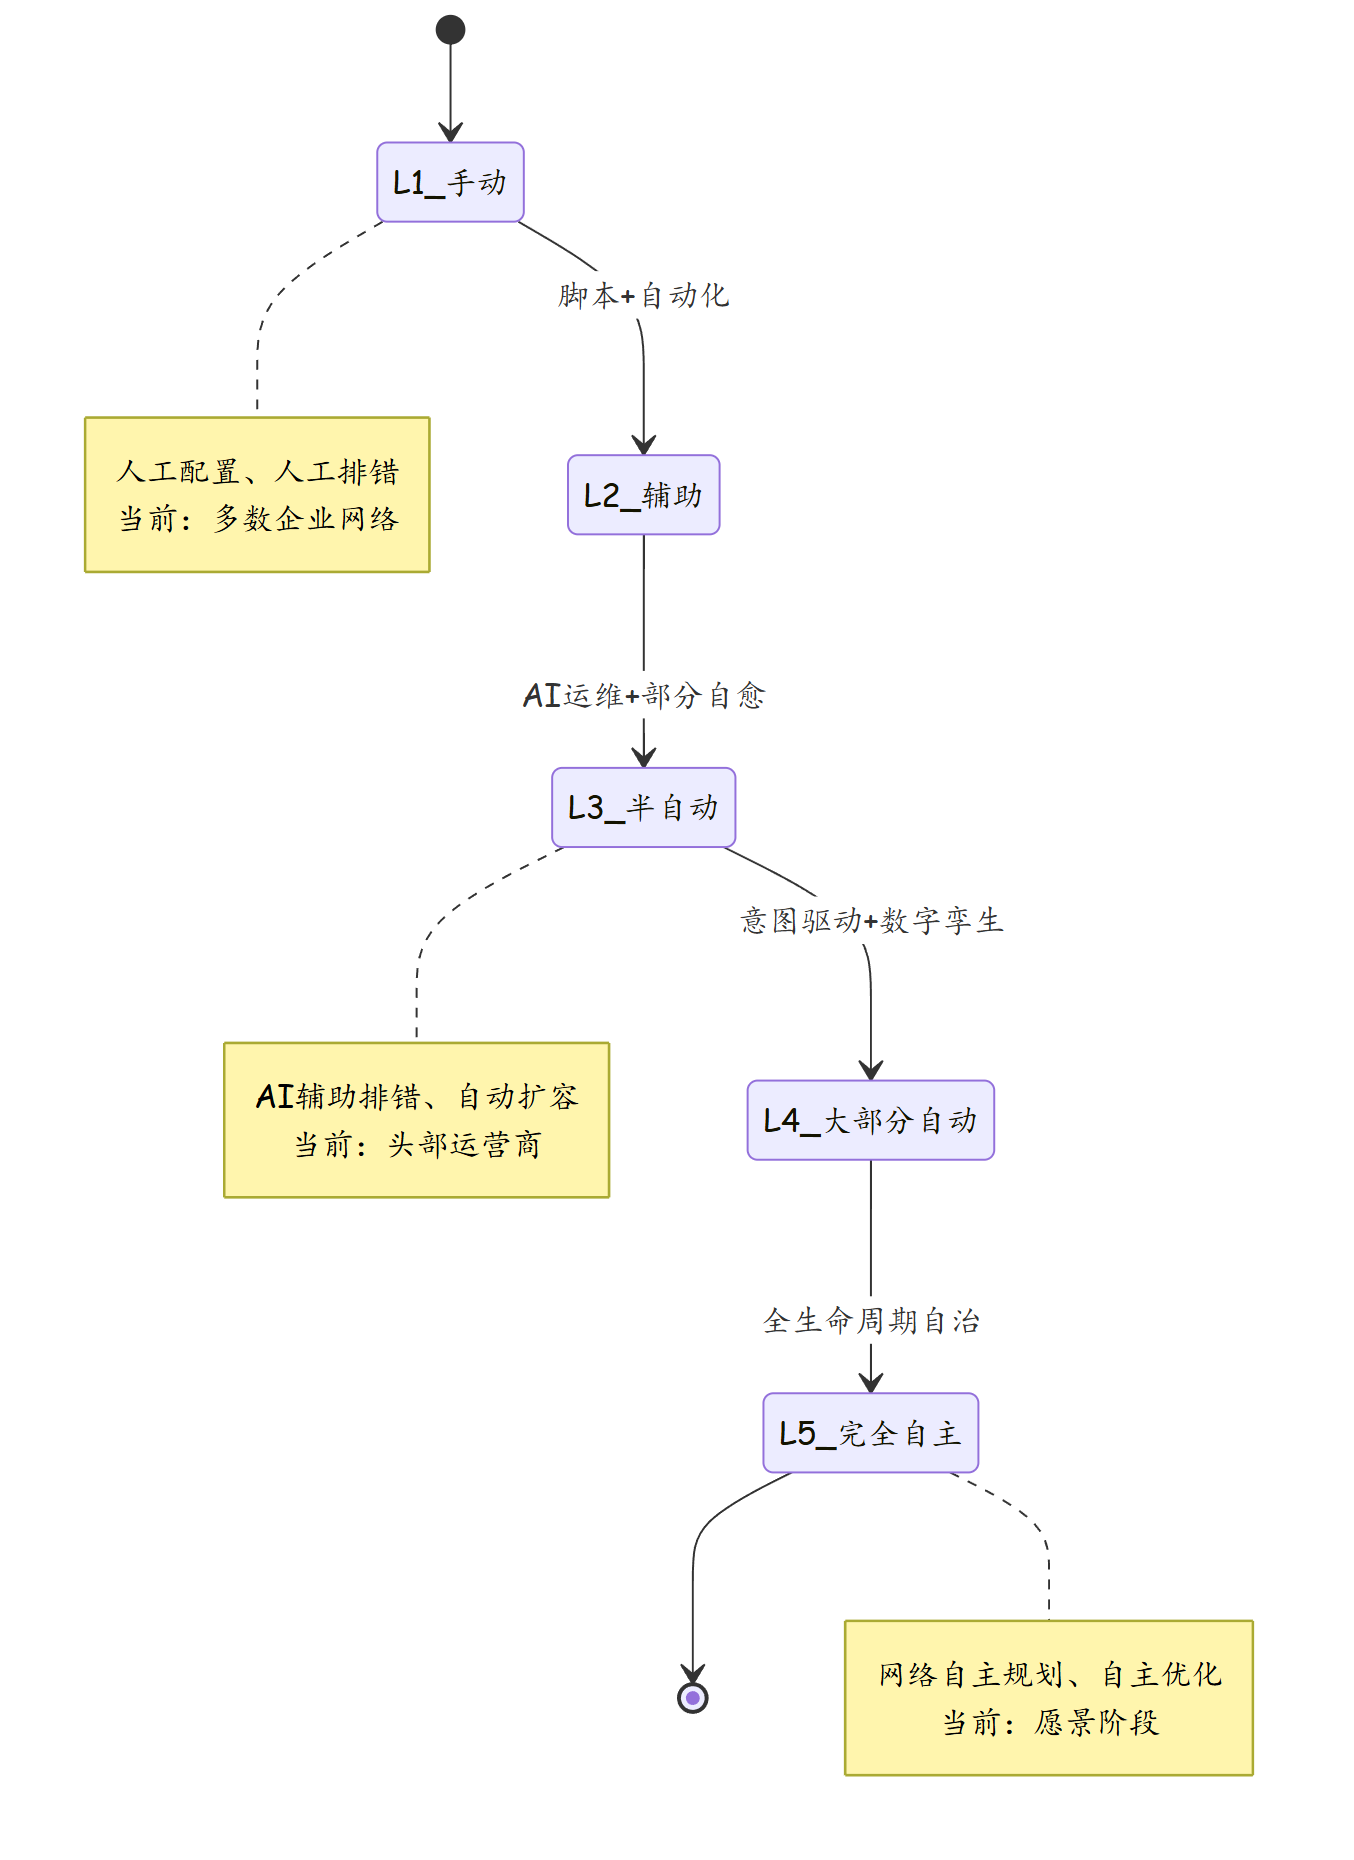
2.1 AI+网络的技术演进路线

当前行业位置:大多数企业网络处于L2-L3阶段,运营商头部企业正在向L4迈进。
2.2 AI+网络的核心应用场景
| 场景 | AI能力 | 典型方案 | 成熟度 |
|---|---|---|---|
| 故障预测 | 时序异常检测 | LSTM/Transformer预测链路故障 | 商业可用 |
| 根因分析 | 知识图谱+因果推理 | 多源数据关联定位根因 | 试点中 |
| 智能排障 | NLP+推理引擎 | 自然语言描述故障→自动排障 | 试点中 |
| 流量预测 | 时间序列分析 | ARIMA/Prophet预测容量需求 | 商业可用 |
| 配置验证 | 形式化验证 | 基于意图的配置正确性验证 | 研究中 |
| 数字孪生 | 仿真建模 | 网络变更前的虚拟验证 | 发展中 |
| 意图驱动 | 语义理解 | 业务意图→网络策略自动映射 | 试点中 |
2.3 AI驱动的网络架构
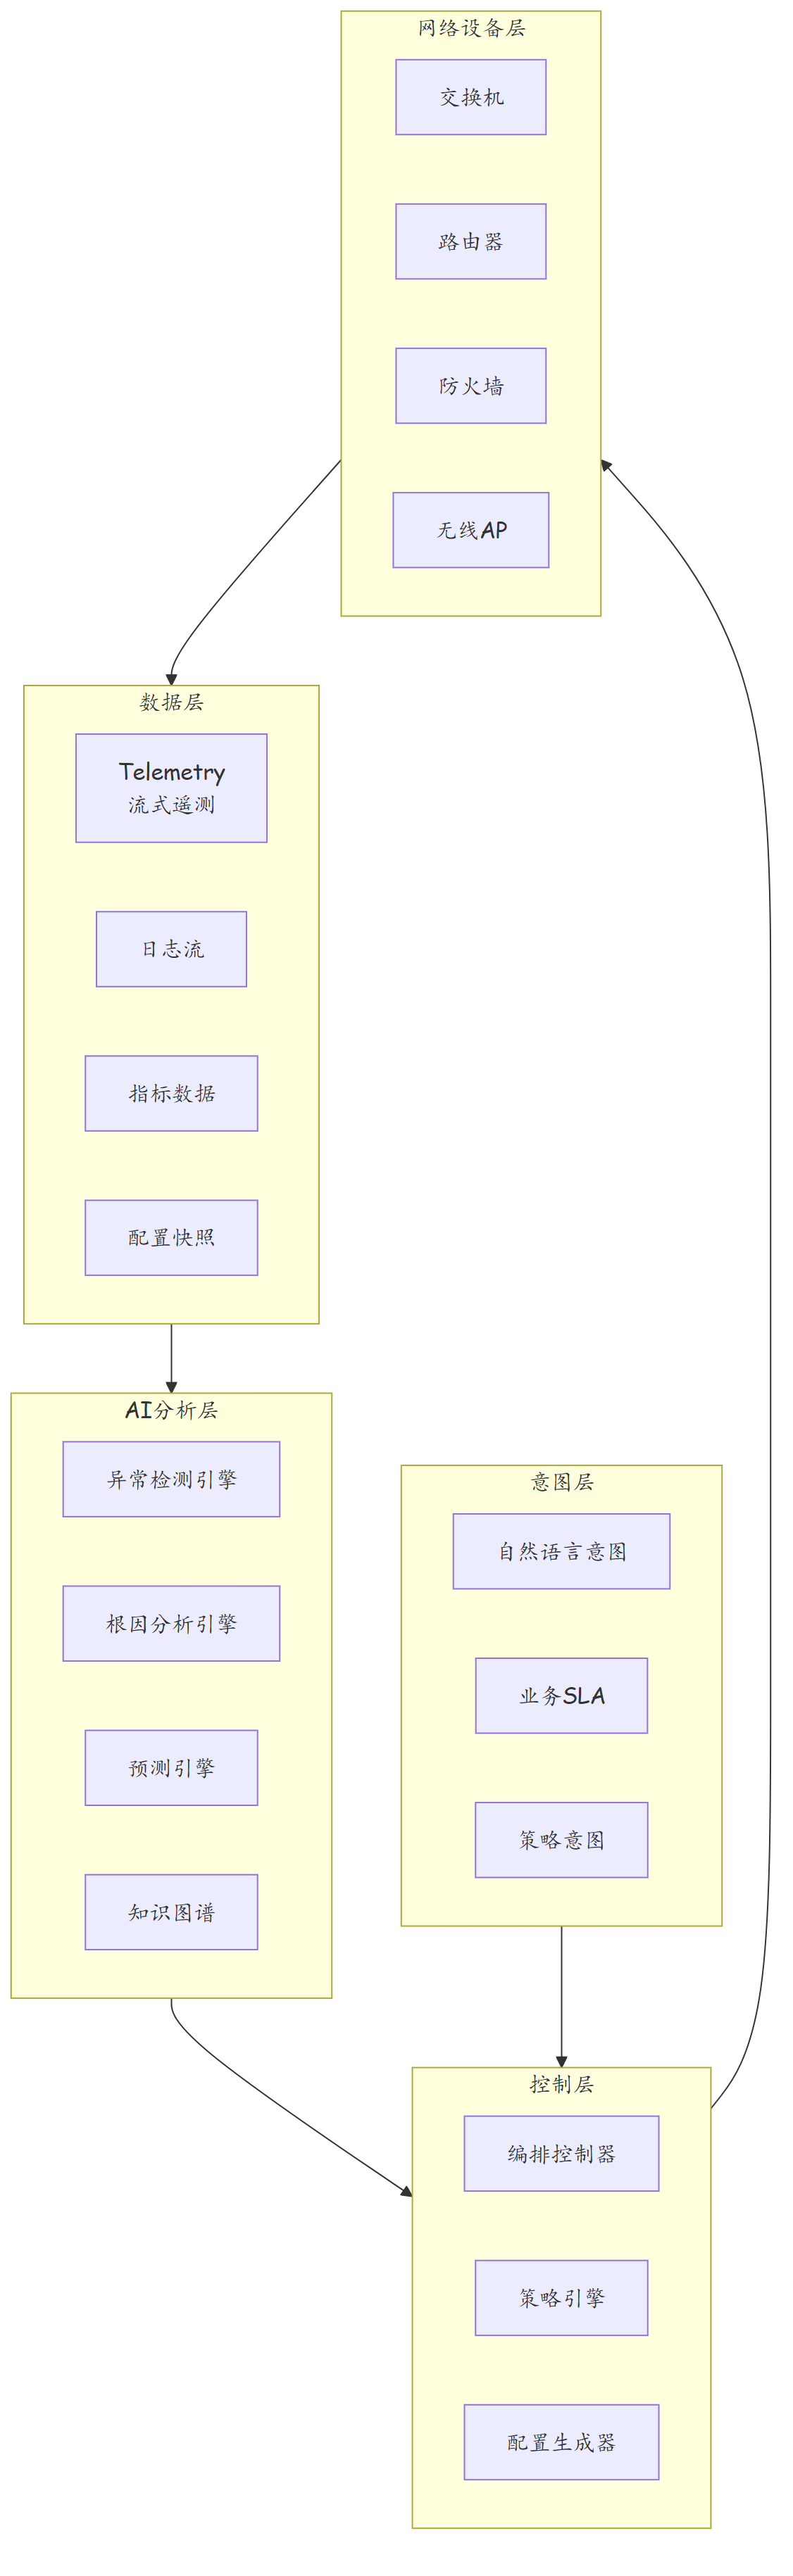
2.4 Network for AI:网络支撑AI训练
随着大模型训练的爆炸式增长,AI训练集群对网络提出了前所未有的要求。这是"AI赋能网络"的反向命题——网络如何支撑AI。
AI训练集群的网络需求:
| 需求维度 | 指标 | 说明 |
|---|---|---|
| 带宽 | 单GPU 200-400Gbps | 千亿参数模型AllReduce通信 |
| 总带宽 | 集群Tbps级别 | 万卡集群的聚合通信总量 |
| 单跳延迟 | < 1μs | GPU间参数同步的延迟敏感 |
| 跨Pod延迟 | < 10μs | 跨交换机通信的尾部延迟 |
| P99延迟 | < 100μs | 尾部延迟决定训练效率 |
| 丢包率 | 零丢包(无损) | RDMA要求零丢包,否则重传放大延迟 |
AI训练网络的三大平面:
| 网络平面 | 带宽 | 协议 | 用途 |
|---|---|---|---|
| 计算网络 | 400-800GE | RoCEv2/InfiniBand | GPU间通信、AllReduce聚合 |
| 存储网络 | 200-400GE | RoCEv2 | 训练数据读取、Checkpoint写入 |
| 管理网络 | 100GE | TCP/IP | 节点管理、镜像下载、日志收集 |
无损网络关键技术:
| 技术 | 原理 | 华为设备配置 |
|---|---|---|
| PFC(优先级流控) | 基于优先级的暂停帧,局部流控 | qos queue 0 pfc enable |
| ECN(显式拥塞通知) | 交换机在拥塞前标记IP包DF位 | ecn cwqcn enable |
| DCQCN | 端到端拥塞控制协议 | congestion-control-mode dcqcn |
| 自适应路由 | 动态选择最优路径避免热点 | adaptive-routing enable |
通信模式详解:
| 通信模式 | 描述 | 网络特征 |
|---|---|---|
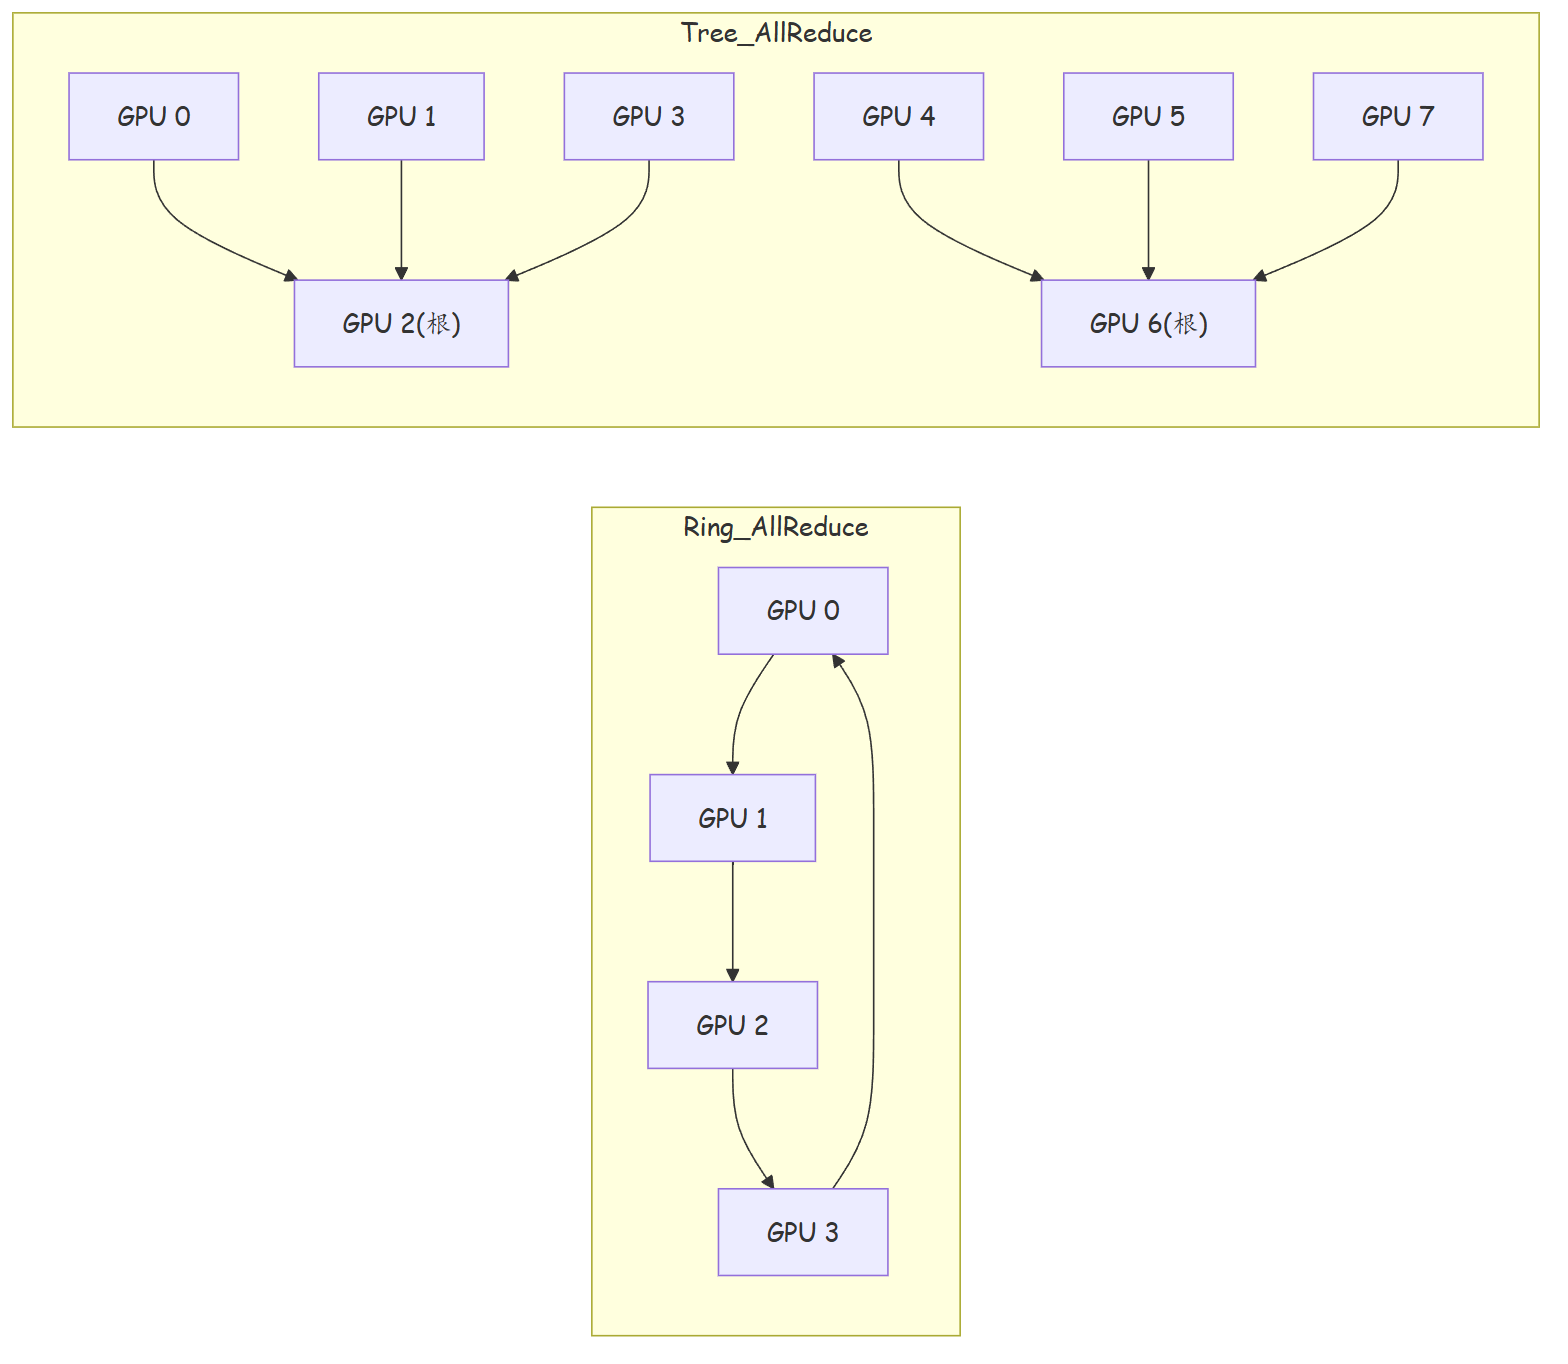
| Ring AllReduce | GPU环形排列,分阶段收发梯度 | 带宽利用率高,延迟与GPU数成正比 |
| Tree AllReduce | 二叉树结构,逐层聚合 | 延迟与log2(GPU数)成正比 |
| All-to-All | 每GPU向所有其他GPU发送数据 | 典型用于Transformer的Attention层 |
| NCCL通信 | NVIDIA集合通信库,自动选择最优拓扑 | 依赖底层网络拓扑感知 |
三、技术细节与实施过程
3.1 AIOps:智能运维实战
AIOps的三大核心能力:
| 能力 | 算法 | 数据输入 | 输出 |
|---|---|---|---|
| 异常检测 | Isolation Forest、LSTM Autoencoder | Telemetry指标时序数据 | 异常事件+置信度 |
| 告警压缩 | 层次聚类、DBSCAN | 告警流 | 告警根因+关联告警组 |
| 根因定位 | 知识图谱推理、因果图 | 拓扑+告警+指标 | 根因节点+推理路径 |
案例:AI驱动的光模块故障预测
场景:某运营商城域网,约5000台设备,2万+光端口

AI模型训练:
- 训练数据:12个月的光功率时序数据 + 故障标签
- 特征工程:光功率趋势、抖动幅度、温度相关性
- 模型:LSTM + Attention
- 预测窗口:提前48小时

预测效果:
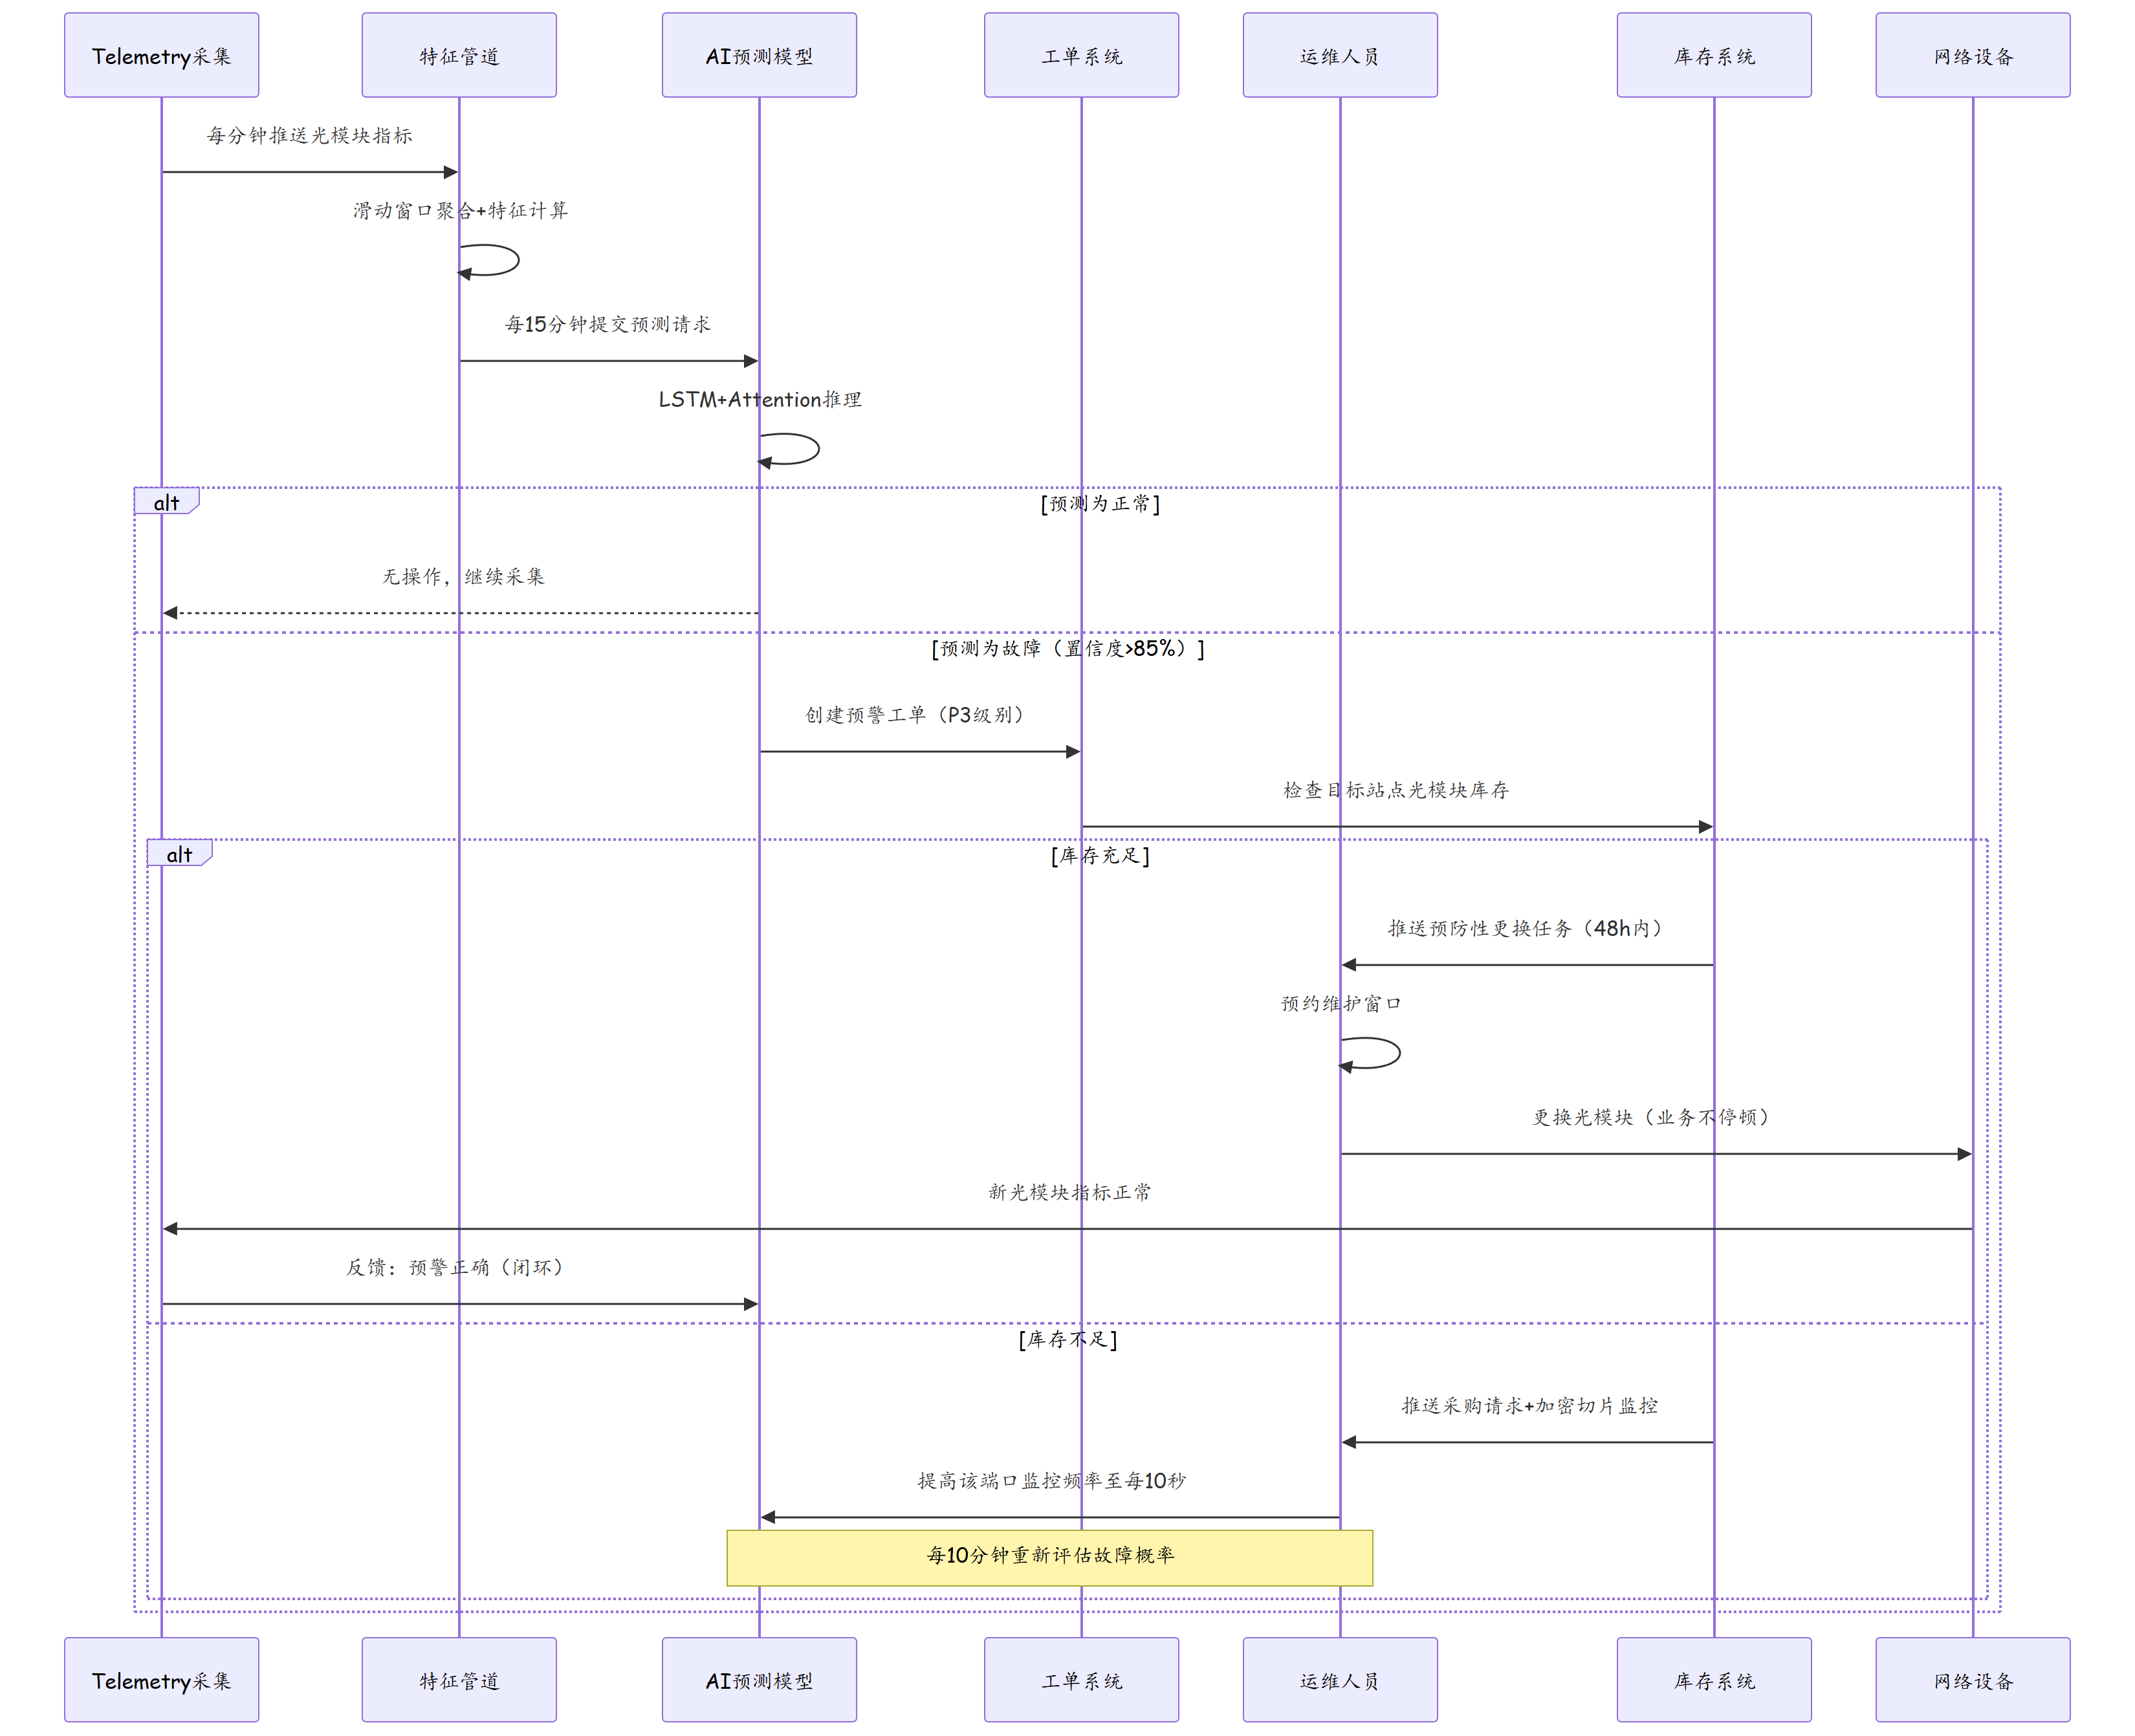
- 准确率:92%(召回率85%)
- 误报率:3%
- 运维效率提升:提前更换光模块,避免故障发生
- 年节约运维成本:约200万元(减少紧急出车和故障处理)
3.2 数字孪生网络
数字孪生的核心价值:在虚拟环境中仿真网络变更的影响,实现"先验证后实施"。
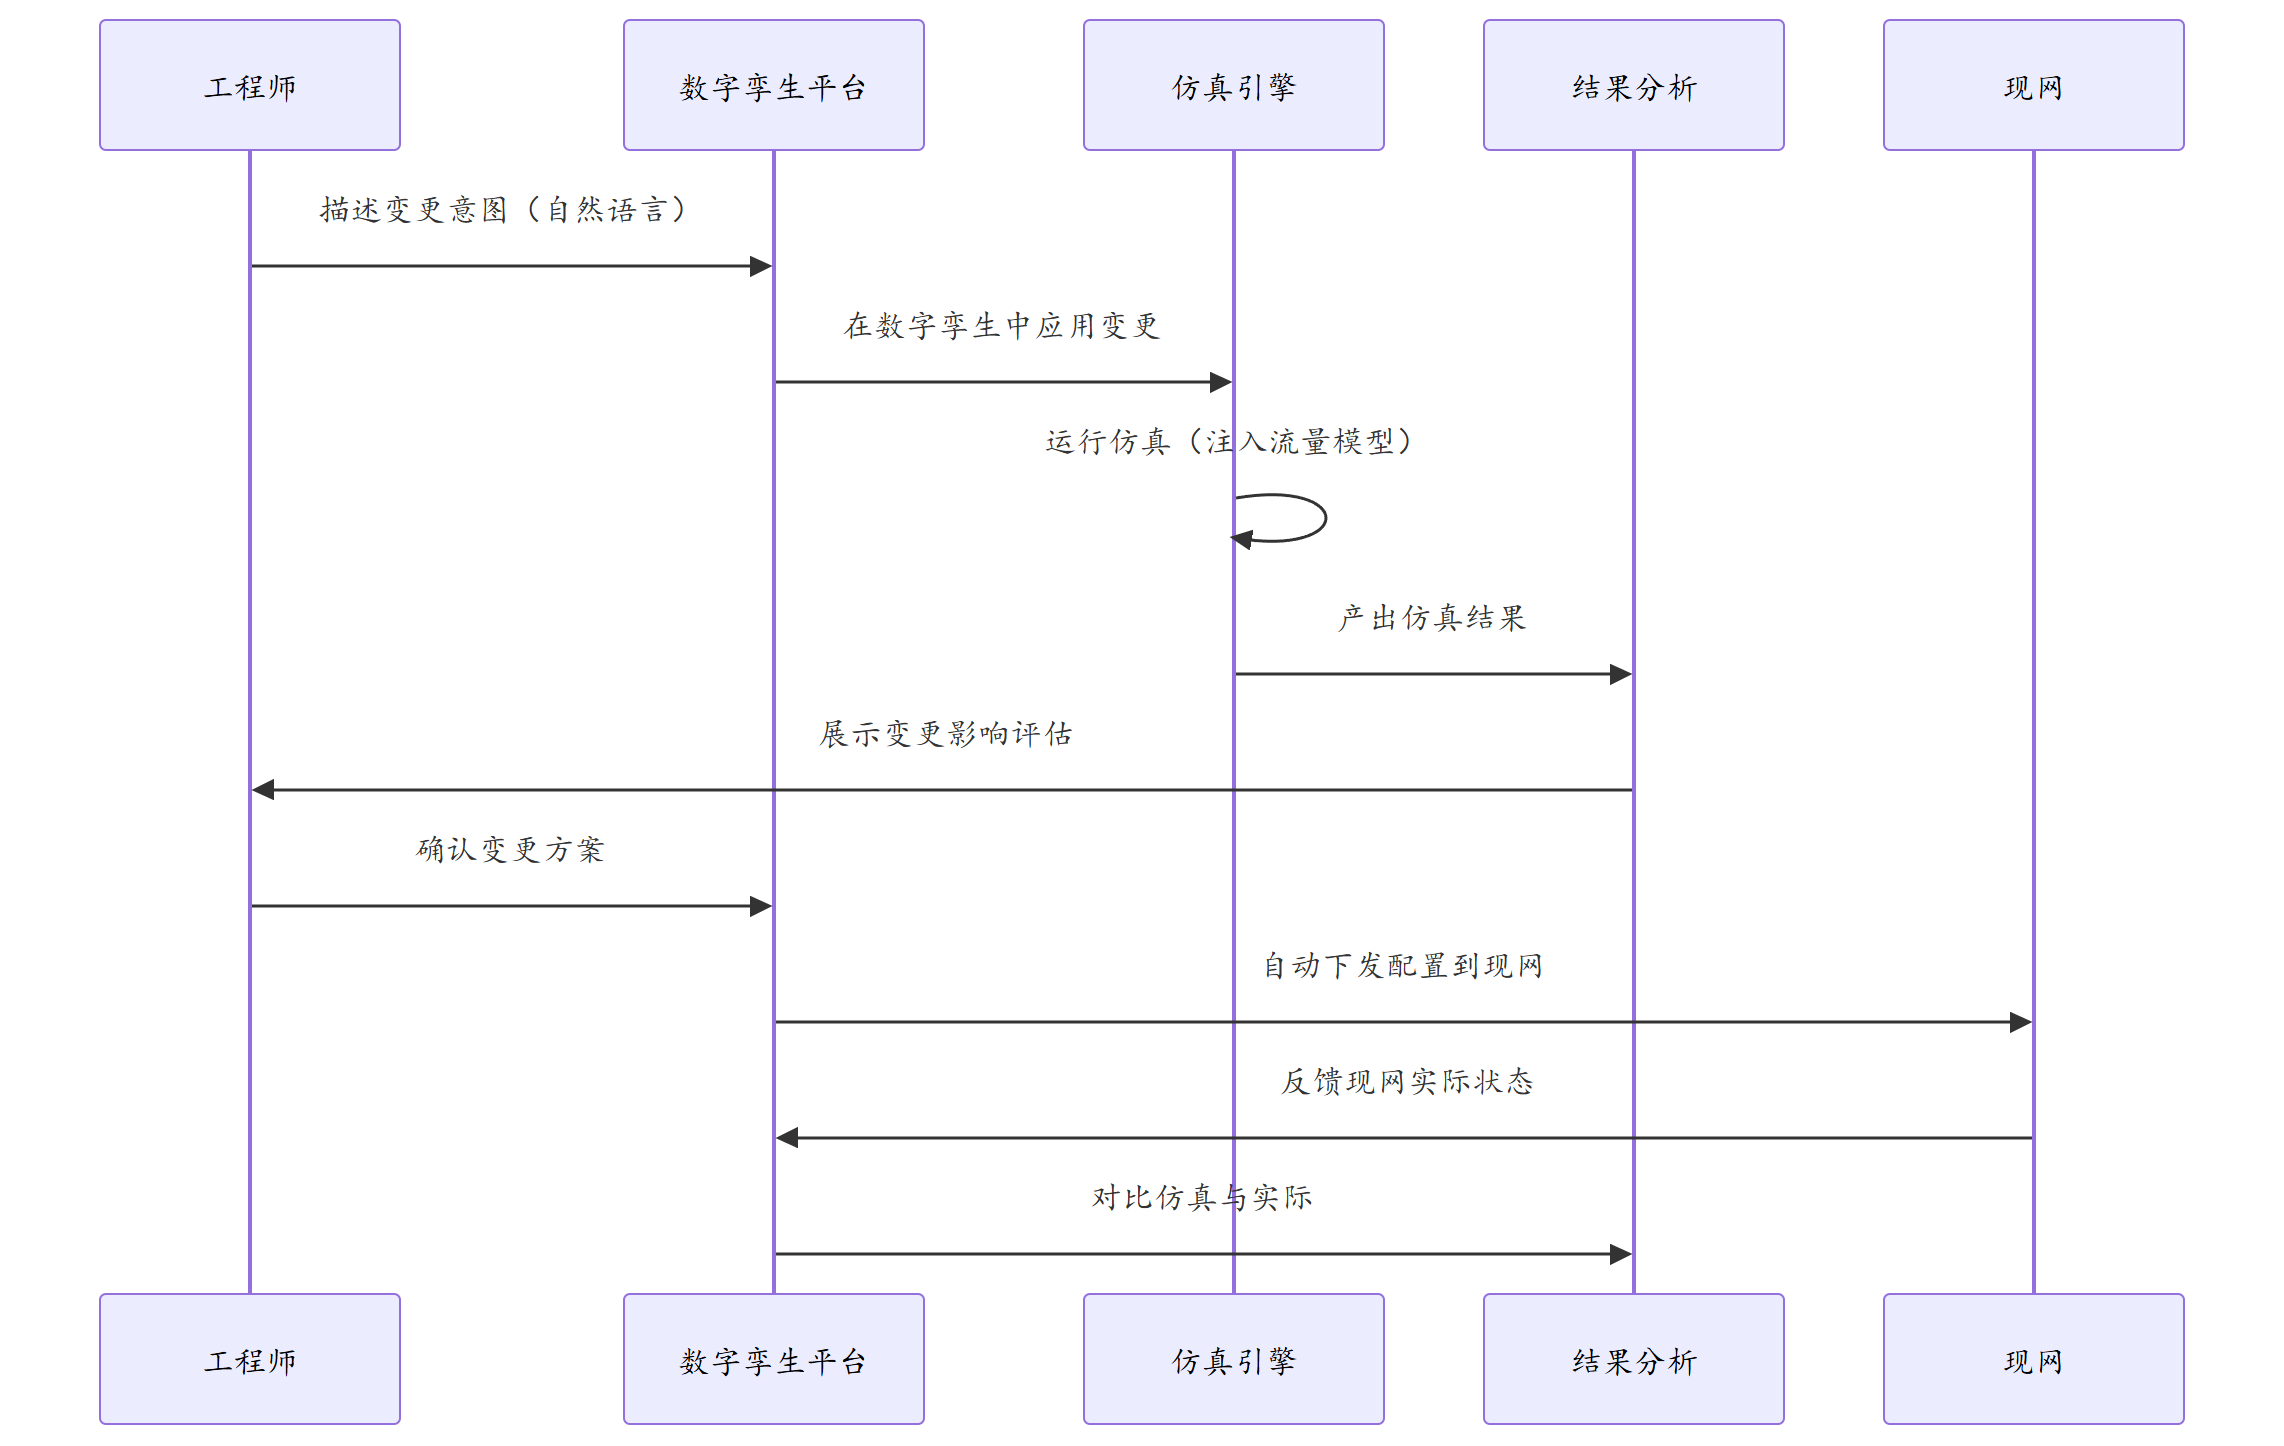
数字孪生的能力等级:
| 等级 | 能力 | 实现方式 |
|---|---|---|
| 静态孪生 | 拓扑和配置镜像 | 自动配置采集 |
| 动态孪生 | 实时流量和状态映射 | Telemetry流式数据 |
| 预测孪生 | 变更影响预测 | 网络仿真引擎 |
| 自适应孪生 | 自动调优 | 强化学习闭环 |
3.3 意图驱动网络(IDN)
IDN的核心流程:
用户意图 → 语义解析 → 策略生成 → 配置翻译 → 验证部署 → 持续监控

示例:
用户意图:"确保VIP客户到数据中心的延迟<5ms"
语义解析:识别关键实体(VIP客户、数据中心)、关键指标(延迟<5ms)
策略生成:
  1. VIP流量标记(DSCP EF)
  2. 启用SR-TE专用路径
  3. 路径选择约束:延迟<5ms
配置翻译:
  1. QoS策略配置
  2. SR-TE Policy配置
  3. Flex-Algorithm配置
验证部署:
  1. 数字孪生仿真验证
  2. 灰度部署到部分链路
  3. 监控实际延迟
持续监控:
  1. Telemetry实时采集延迟
  2. 如果延迟>5ms,自动调整路径
3.4 大模型与网络运维
网络大模型(Network LLM)的应用场景:
| 场景 | 实现方式 | 效果 |
|---|---|---|
| 智能问答 | 微调LLM + 网络知识图谱 | 7×24小时智能排障助手 |
| 配置生成 | Prompt Engineering + 模板 | 自动生成设备配置 |
| 日志分析 | LLM语义理解 | 从海量日志中提取异常模式 |
| 根因推理 | Chain-of-Thought + 拓扑推理 | 多跳根因定位 |
| 案例生成 | 基于真实排错记录训练 | 自动编写技术案例初稿 |
网络大模型的训练数据:
训练语料构成:
- RFC文档:30%(协议权威知识)
- 厂商文档:20%(设备配置参考)
- 技术案例:20%(实战经验)
- 论坛讨论:15%(社区经验)
- 排错工单:15%(真实故障数据)
四、实战配置/案例分析
4.1 案例:某运营商AI驱动的智能运维平台
项目背景:
某省级运营商拥有约8000台网络设备,日均告警约5000条,人工排障效率低、重复故障多。
平台架构:
| 模块 | 功能 | 技术实现 |
|---|---|---|
| 数据采集 | Telemetry+SNMP+日志 | Kafka流处理 |
| 数据治理 | 数据清洗+特征工程 | Flink实时处理 |
| 异常检测 | 指标异常检测 | Isolation Forest |
| 告警压缩 | 关联告警聚合 | 层次聚类 |
| 根因分析 | 拓扑+告警关联定位 | 知识图谱推理 |
| 处置建议 | 基于案例的修复建议 | 检索增强生成(RAG) |
| 自愈执行 | 自动执行修复操作 | 编排引擎 |
实施效果:
| 指标 | 实施前 | 实施后 | 改善 |
|---|---|---|---|
| 日均有效告警 | 5000条 | 200条 | ↓96% |
| 平均排障时间 | 45分钟 | 8分钟 | ↓82% |
| 故障提前预警率 | 0% | 65% | 从0到65% |
| 自动修复率 | 0% | 35% | 从0到35% |
| 运维人力投入 | 80人 | 40人 | ↓50% |
4.2 AI辅助排错实战
场景:用户报告内网网站访问慢
传统排错(人工):
Step 1: ping测试 → 通,但延迟偏高(30ms,正常5ms)
Step 2: traceroute → 第3跳延迟突增
Step 3: 登录第3跳设备检查 → 端口利用率95%
Step 4: 检查端口流量组成 → 某台服务器异常大流量
Step 5: 限制该服务器带宽 → 恢复
总耗时:约30分钟

AI辅助排错:
Step 1: AI告警压缩引擎识别异常流量模式
Step 2: AI关联分析定位到具体服务器IP
Step 3: AI给出处置建议:"服务器10.20.30.100流量异常,
        建议限制该服务器带宽或排查业务异常"
Step 4: 运维人员确认并执行
总耗时:约3分钟
4.3 自动驾驶网络的愿景
4.4 AI驱动的光模块故障预测实战
光模块故障是城域网最常见的硬件故障类型,占总硬件故障的40%以上。传统运维模式下,光模块故障只能被动响应(故障发生→告警→出车→更换),平均MTTR(平均修复时间)超过4小时。AI驱动的预测性维护可将MTTR缩短至30分钟内。
数据收集方案:
| 数据源 | 采集方式 | 采集频率 | 关键字段 |
|---|---|---|---|
| 光功率(收/发) | Telemetry流式遥测 | 1分钟 | tx_power, rx_power, rx_power_min, rx_power_max |
| 温度 | Telemetry流式遥测 | 1分钟 | temperature, bias_current |
| 电压 | Telemetry流式遥测 | 5分钟 | voltage |
| 历史故障记录 | CMDB工单系统 | 按需 | fault_time, fault_type, replace_time |
| 光模块型号 | 设备配置采集 | 周级 | model, serial, manufacture_date |
| 链路误码率 | SNMP轮询 | 5分钟 | fec_corrected, fec_uncorrected |
特征工程:
import pandas as pd
import numpy as np
from sklearn.preprocessing import StandardScaler

def build_optical_features(raw_df: pd.DataFrame) -> pd.DataFrame:
    """
    从原始光功率时序数据构建特征
    :param raw_df: 原始数据框,含timestamp, tx_power, rx_power, temperature等列
    :return: 含工程特征的DataFrame
    """
    df = raw_df.copy()
    df = df.sort_values("timestamp")

    # 1. 趋势特征(滑动窗口线性回归斜率)
    window = 1440  # 24小时(每分钟1条)
    df["rx_power_slope_24h"] = df["rx_power"].rolling(window).apply(
        lambda x: np.polyfit(np.arange(len(x)), x, 1)[0], raw=True
    )
    df["tx_power_slope_24h"] = df["tx_power"].rolling(window).apply(
        lambda x: np.polyfit(np.arange(len(x)), x, 1)[0], raw=True
    )

    # 2. 波动特征
    for w in [60, 1440, 4320]:  # 1h, 24h, 72h
        df[f"rx_power_std_{w}m"] = df["rx_power"].rolling(w).std()
        df[f"rx_power_range_{w}m"] = (
            df["rx_power"].rolling(w).max() - df["rx_power"].rolling(w).min()
        )

    # 3. 温度相关性
    df["temp_rx_corr_24h"] = df["rx_power"].rolling(window).corr(df["temperature"])

    # 4. 阈值逼近程度
    df["rx_power_margin"] = df["rx_power"] - df["rx_power_min"]  # 距告警阈值的裕量
    df["rx_power_margin_pct"] = df["rx_power_margin"] / (df["rx_power_max"] - df["rx_power_min"]) * 100

    # 5. 误码累积
    df["fec_uncorr_rate"] = df["fec_uncorrected"].diff(periods=1440) / 1440

    return df.dropna()
LSTM+Attention模型说明:
| 模块 | 结构 | 参数 | 作用 |
|---|---|---|---|
| 输入层 | 序列长度96(16小时)× 特征数12 | - | 接受标准化后的时序特征 |
| LSTM层1 | hidden=128, bidirectional | ~260K | 捕捉长时间依赖(光功率渐进衰减) |
| LSTM层2 | hidden=64, bidirectional | ~100K | 精细特征提取 |
| Attention层 | d_model=64 | ~8K | 聚焦关键时间窗口(如故障前2小时) |
| FC层1 | 64 → 32, ReLU | 2K | 非线性映射 |
| FC层2 | 32 → 2(正常/故障) | 66 | 二分类输出 |
import torch
import torch.nn as nn

class OpticalFaultPredictor(nn.Module):
    """光模块故障预测模型:LSTM + Attention"""

    def __init__(self, input_dim=12, seq_len=96, hidden_dim=128, num_classes=2):
        super().__init__()
        self.lstm1 = nn.LSTM(input_dim, hidden_dim, batch_first=True,
                            bidirectional=True, dropout=0.2)
        self.lstm2 = nn.LSTM(hidden_dim * 2, hidden_dim // 2, batch_first=True,
                            bidirectional=True, dropout=0.2)

        # Attention层
        attn_dim = hidden_dim
        self.attn_weights = nn.Linear(attn_dim * 2, 1)
        self.attn_v = nn.Parameter(torch.randn(attn_dim * 2))

        self.fc1 = nn.Linear(attn_dim * 2, 32)
        self.fc2 = nn.Linear(32, num_classes)
        self.relu = nn.ReLU()
        self.dropout = nn.Dropout(0.3)

    def attention(self, lstm_out):
        # lstm_out: (batch, seq, hidden*2)
        energy = torch.sum(torch.tanh(lstm_out) * self.attn_v, dim=-1, keepdim=True)
        alpha = torch.softmax(energy, dim=1)  # (batch, seq, 1)
        context = torch.sum(alpha * lstm_out, dim=1)  # (batch, hidden*2)
        return context, alpha  # 返回注意力权重可用于可解释性分析

    def forward(self, x):
        # x: (batch, seq_len, input_dim)
        out1, _ = self.lstm1(x)
        out2, _ = self.lstm2(out1)
        context, attn = self.attention(out2)
        out = self.relu(self.fc1(context))
        out = self.dropout(out)
        out = self.fc2(out)
        return out, attn  # 返回预测和注意力权重
预测效果评估表:
| 评估指标 | 数值 | 说明 |
|---|---|---|
| 准确率(Accuracy) | 96.2% | (TP+TN)/(TP+TN+FP+FN) |
| 精确率(Precision) | 92.0% | TP/(TP+FP),预测故障中真正故障的比例 |
| 召回率(Recall) | 85.3% | TP/(TP+FN),真实故障中被正确预测的比例 |
| F1-Score | 88.5% | 精确率和召回率的调和平均 |
| AUC-ROC | 0.947 | 模型整体区分能力 |
| 误报率(FPR) | 3.8% | FP/(FP+TN),正常端口被误判为故障的比例 |
| 平均提前预警时间 | 38.5小时 | 从预警到实际故障发生的时间差 |
| 单端口预测耗时 | < 5ms | GPU推理延迟 |
误报分析:
| 误报类型 | 占比 | 根因 | 改善方法 |
|---|---|---|---|
| 光功率短暂波动 | 45% | 光纤受挤压或温度骤变 | 增加滑动窗口平滑,过滤短时波动 |
| 清洁后功率变化 | 25% | 光纤端面清洁后功率突升 | 标记维护事件,排除训练窗口 |
| 光模块批次差异 | 20% | 同型号不同批次参数差异 | 按批次分别建模或增加批次ID特征 |
| 传感器漂移 | 10% | DDM传感器校准漂移 | 定期校准,异常值检测 |
运维闭环流程图:
4.5 大模型辅助排错实战代码
以下完整代码展示了使用LLM API进行网络故障智能排错的流程,包括prompt构建、上下文管理、输出解析和结果格式化。
#!/usr/bin/env python3
"""
大模型辅助网络故障排错工具
调用LLM API进行智能排错分析,生成排查建议和配置方案
"""
import requests
import json
import re
from typing import List, Dict, Optional
from datetime import datetime
from dataclasses import dataclass, field


@dataclass
class TroubleshootingStep:
    """单个排错步骤"""
    step_number: int
    action: str          # 执行动作
    command: str         # 具体命令
    expected_result: str  # 预期结果
    decision_point: str   # 分支判断条件


@dataclass
class TroubleshootingResult:
    """排错结果"""
    summary: str                          # 故障摘要
    root_cause_hypothesis: List[str]      # 根因假设列表(按可能性排序)
    steps: List[TroubleshootingStep]      # 排错步骤
    estimated_confidence: float           # 置信度
    llm_tokens_used: int                  # 消耗的token数


class NetworkLLMAssistant:
    """大模型网络排错助手"""

    # 不同厂商的命令前缀
    VENDOR_PREFIX = {
        "huawei": "<Huawei>",
        "cisco": "Router#",
        "juniper": "root@",
    }

    def __init__(self,
                 api_url: str,
                 api_key: str,
                 model: str = "gpt-4",
                 max_tokens: int = 4096):
        self.api_url = api_url
        self.api_key = api_key
        self.model = model
        self.max_tokens = max_tokens
        self.session_history: List[Dict] = []

    def build_prompt(self,
                     fault_description: str,
                     topology_info: str = "",
                     device_output: str = "",
                     vendor: str = "huawei",
                     protocol: str = "") -> str:
        """
        构建排错prompt模板
        :param fault_description: 故障描述
        :param topology_info: 拓扑信息
        :param device_output: 设备命令输出
        :param vendor: 设备厂商
        :param protocol: 涉及协议
        :return: 完整的prompt字符串
        """
        prompt = f"""你是一名资深网络工程师,拥有15年数通设备排错经验。
请根据以下信息分析网络故障,给出系统化的排错方案。

【故障描述】
{fault_description}

"""
        if topology_info:
            prompt += f"【网络拓扑】\n{topology_info}\n\n"

        if protocol:
            prompt += f"【涉及协议】\n{protocol}\n\n"

        if device_output:
            prompt += f"【设备命令输出】\n```text\n{device_output}\n```\n\n"

        prompt += f"""【设备厂商】{vendor}

请严格按以下JSON格式输出(不要输出任何其他文字):
{{
  "summary": "一句话故障摘要",
  "root_cause_hypothesis": [
    {{
      "hypothesis": "根因假设描述",
      "probability": 0.85,
      "evidence": "支持该假设的证据"
    }}
  ],
  "steps": [
    {{
      "step_number": 1,
      "action": "执行什么检查",
      "command": "具体的{vendor}设备命令",
      "expected_result": "正常情况下的输出特征",
      "decision_point": "如果看到X,说明Y,转向下一步/结论"
    }}
  ],
  "estimated_confidence": 0.80
}}
"""
        return prompt

    def call_llm(self, prompt: str) -> Dict:
        """
        调用LLM API
        :param prompt: 用户prompt
        :return: API返回的JSON
        """
        self.session_history.append({"role": "user", "content": prompt})

        headers = {
            "Content-Type": "application/json",
            "Authorization": f"Bearer {self.api_key}"
        }

        payload = {
            "model": self.model,
            "messages": self.session_history[-10:],  # 保留最近10轮上下文
            "max_tokens": self.max_tokens,
            "temperature": 0.1,  # 低温度,保证输出稳定性
            "response_format": {"type": "json_object"}
        }

        response = requests.post(self.api_url, headers=headers,
                                json=payload, timeout=60)
        response.raise_for_status()

        data = response.json()
        assistant_msg = data["choices"][0]["message"]["content"]
        self.session_history.append(
            {"role": "assistant", "content": assistant_msg}
        )

        tokens_used = data.get("usage", {}).get("total_tokens", 0)
        return {"content": assistant_msg, "tokens_used": tokens_used}

    def parse_response(self, llm_output: str) -> TroubleshootingResult:
        """
        解析LLM输出为结构化结果
        :param llm_output: LLM返回的JSON字符串
        :return: TroubleshootingResult对象
        """
        # 提取JSON(处理可能存在的markdown代码块)
        json_str = llm_output
        match = re.search(r"```(?:json)?\s*(\{.*?\})\s*```", json_str, re.DOTALL)
        if match:
            json_str = match.group(1)

        parsed = json.loads(json_str)

        steps = []
        for s in parsed.get("steps", []):
            step = TroubleshootingStep(
                step_number=s["step_number"],
                action=s["action"],
                command=s["command"],
                expected_result=s["expected_result"],
                decision_point=s["decision_point"]
            )
            steps.append(step)

        hypotheses = parsed.get("root_cause_hypothesis", [])

        return TroubleshootingResult(
            summary=parsed.get("summary", ""),
            root_cause_hypothesis=[
                {
                    "hypothesis": h["hypothesis"],
                    "probability": h["probability"],
                    "evidence": h["evidence"]
                }
                for h in hypotheses
            ],
            steps=steps,
            estimated_confidence=parsed.get("estimated_confidence", 0.0),
            llm_tokens_used=0  # 由调用方填充
        )

    def troubleshoot(self,
                     fault_description: str,
                     **kwargs) -> TroubleshootingResult:
        """
        执行完整排错流程
        :return: 结构化排错结果
        """
        prompt = self.build_prompt(fault_description, **kwargs)
        llm_response = self.call_llm(prompt)
        result = self.parse_response(llm_response["content"])
        result.llm_tokens_used = llm_response["tokens_used"]
        return result

    def format_report(self, result: TroubleshootingResult) -> str:
        """将排错结果格式化为可读报告"""
        lines = []
        lines.append("=" * 60)
        lines.append("网络故障智能排错报告")
        lines.append(f"生成时间: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
        lines.append("=" * 60)

        lines.append(f"\n## 故障摘要\n{result.summary}")

        lines.append(f"\n## 根因假设(按可能性排序)")
        for i, h in enumerate(result.root_cause_hypothesis, 1):
            lines.append(
                f"\n### 假设{i}: {h['hypothesis']} "
                f"(可能性: {h['probability']*100:.0f}%)"
            )
            lines.append(f"**证据**: {h['evidence']}")

        lines.append(f"\n## 排错步骤")
        for step in result.steps:
            lines.append(f"\n**Step {step.step_number}: {step.action}**")
            lines.append(f"```bash\n{step.command}\n```")
            lines.append(f"**预期**: {step.expected_result}")
            lines.append(f"**判断**: {step.decision_point}")

        lines.append(f"\n## 置信度评估")
        lines.append(f"- 模型置信度: {result.estimated_confidence*100:.0f}%")
        lines.append(f"- LLM Token消耗: {result.llm_tokens_used}")
        lines.append("=" * 60)

        return "\n".join(lines)


# ========== 使用示例 ==========
if __name__ == "__main__":
    assistant = NetworkLLMAssistant(
        api_url="https://api.openai.com/v1/chat/completions",
        api_key="sk-your-api-key-here",
        model="gpt-4-turbo"
    )

    # 示例1:BGP邻居无法建立
    result = assistant.troubleshoot(
        fault_description=(
            "两台华为NE40E设备之间iBGP邻居无法建立,"
            "显示状态为Idle,已经确认直连链路可达(ping通),"
            "双方AS号一致(65100),Router ID已配置且唯一"
        ),
        topology_info=(
            "NE40E-A(10.1.1.1) -- 10GE -- NE40E-B(10.1.1.2),"
            "同一IS-IS Level-2区域"
        ),
        device_output=(
            "display bgp peer 10.1.1.2\n"
            "  Peer: 10.1.1.2, State: Idle\n"
            "  Description: NE40E-B\n"
            "  Remote AS: 65100, Local AS: 65100\n"
            "  MsgRcvd: 0, MsgSent: 0\n"
            "  Up/Down: Never"
        ),
        vendor="huawei",
        protocol="BGP/IS-IS"
    )

    print(assistant.format_report(result))

    # 示例2:多轮追问
    follow_up = assistant.troubleshoot(
        fault_description=(
            "执行了Step 2的命令,输出显示:\n"
            "BGP TCP connection failed: Connection refused\n"
            "进一步排查防火墙策略,发现179端口被ACL拦截"
        ),
        vendor="huawei"
    )
    print("\n" + assistant.format_report(follow_up))
大模型排错效果评估:
| 评估维度 | 传统人工排错 | LLM辅助排错 | 提升 |
|---|---|---|---|
| 首次排错时间 | 30分钟 | 5分钟 | ↓83% |
| 排错步骤完整度 | 依赖个人经验 | 系统化清单 | 显著提升 |
| 覆盖协议范围 | 2-3个擅长协议 | 全协议 | 全面 |
| 学习门槛 | 需要多年经验 | 会使用自然语言即可 | 降低80% |
| Token成本 | - | 约500-2000 tokens/次 | 可控 |
使用注意事项:
| 注意点 | 说明 | 建议 |
|---|---|---|
| 幻觉风险 | LLM可能编造不存在的命令 | 所有命令需人工验证后再执行 |
| 上下文窗口 | 超长设备输出超出上下文限制 | 使用增量追问,逐步缩小范围 |
| 数据安全 | 敏感配置不应上传公网API | 使用本地部署的私有模型 |
| 厂商差异 | 不同厂商命令语法不同 | prompt中明确指定厂商和版本 |
| 成本管控 | 高频调用费用较高 | 缓存常见故障的回答结果 |
4.4 自治网络分级详解(TM Forum标准)
| 级别 | 名称 | 核心能力 | 人工参与度 | 典型场景 |
|---|---|---|---|---|
| L0 | 手工运维 | 无自动化 | 100%人工 | 小型企业网络 |
| L1 | 辅助运维 | 监控告警、报表自动生成 | 人工决策+执行 | 有监控系统的基础网络 |
| L2 | 部分自治 | 自动化配置部署、基于规则自愈 | 人工审批+部分执行 | 数据中心、运营商城域 |
| L3 | 条件自治 | AI辅助决策、预测性运维 | 人工处理异常 | 头部运营商核心网 |
| L4 | 高度自治 | 基于意图的闭环、自动优化 | 人工只定义目标 | 5G核心网、SD-WAN |
| L5 | 完全自治 | 业务驱动、自我进化 | 无人参与 | 愿景阶段 |
当前行业位置:全球90%的网络处于L1-L2阶段,头部运营商在L3向L4过渡,L5仍处于学术研究和实验室阶段。
五、未来趋势与职业发展
5.1 未来5-10年关键技术趋势
| 技术 | 成熟度 | 普及时间 | 影响度 | 核心挑战 |
|---|---|---|---|---|
| AI原生网络 | 4/10 | 5年 | 9/10 | 模型可解释性、数据安全 |
| 800GE/1.6T以太网 | 3/10 | 5年 | 8/10 | 光模块功耗、信号完整性 |
| SRv6 | 6/10 | 3年 | 8/10 | IPv6普及率、硬件支持 |
| 数字孪生网络 | 4/10 | 4年 | 8/10 | 建模精度、大规模仿真性能 |
| 算力网络(CEN) | 4/10 | 5年 | 9/10 | 算力感知、标准化 |
| 确定性网络(DetNet) | 4/10 | 6年 | 7/10 | 大规模部署、时钟同步 |
| 零信任架构(ZTNA) | 5/10 | 4年 | 8/10 | 性能与安全平衡 |
| 光子计算/光交换 | 2/10 | 8年 | 9/10 | 技术成熟度、制造成本 |
| 可编程数据面(P4) | 5/10 | 4年 | 8/10 | 人才稀缺、与传统设备共存 |
5.2 网络工程师能力升级路径
不变的核心能力(无论技术如何演进都不会过时): 1. 路由交换协议(OSPF/BGP/IS-IS)— 底层原理只演进不颠覆 2. 排障方法论 — 系统化思维永远有价值 3. 网络设计原则 — 分层、冗余、模块化
需要转型的能力:
| 从... | 到... | 代表技术 |
|---|---|---|
| CLI配置 | API操作 | NetConf/gRPC/RESTCONF |
| 手工操作 | 自动化流程 | Python/Ansible/GitOps |
| 单域思维 | 跨域架构 | 网络+计算+存储+安全 |
需要新学的能力:
| 能力 | 学习资源 | 预计投入 |
|---|---|---|
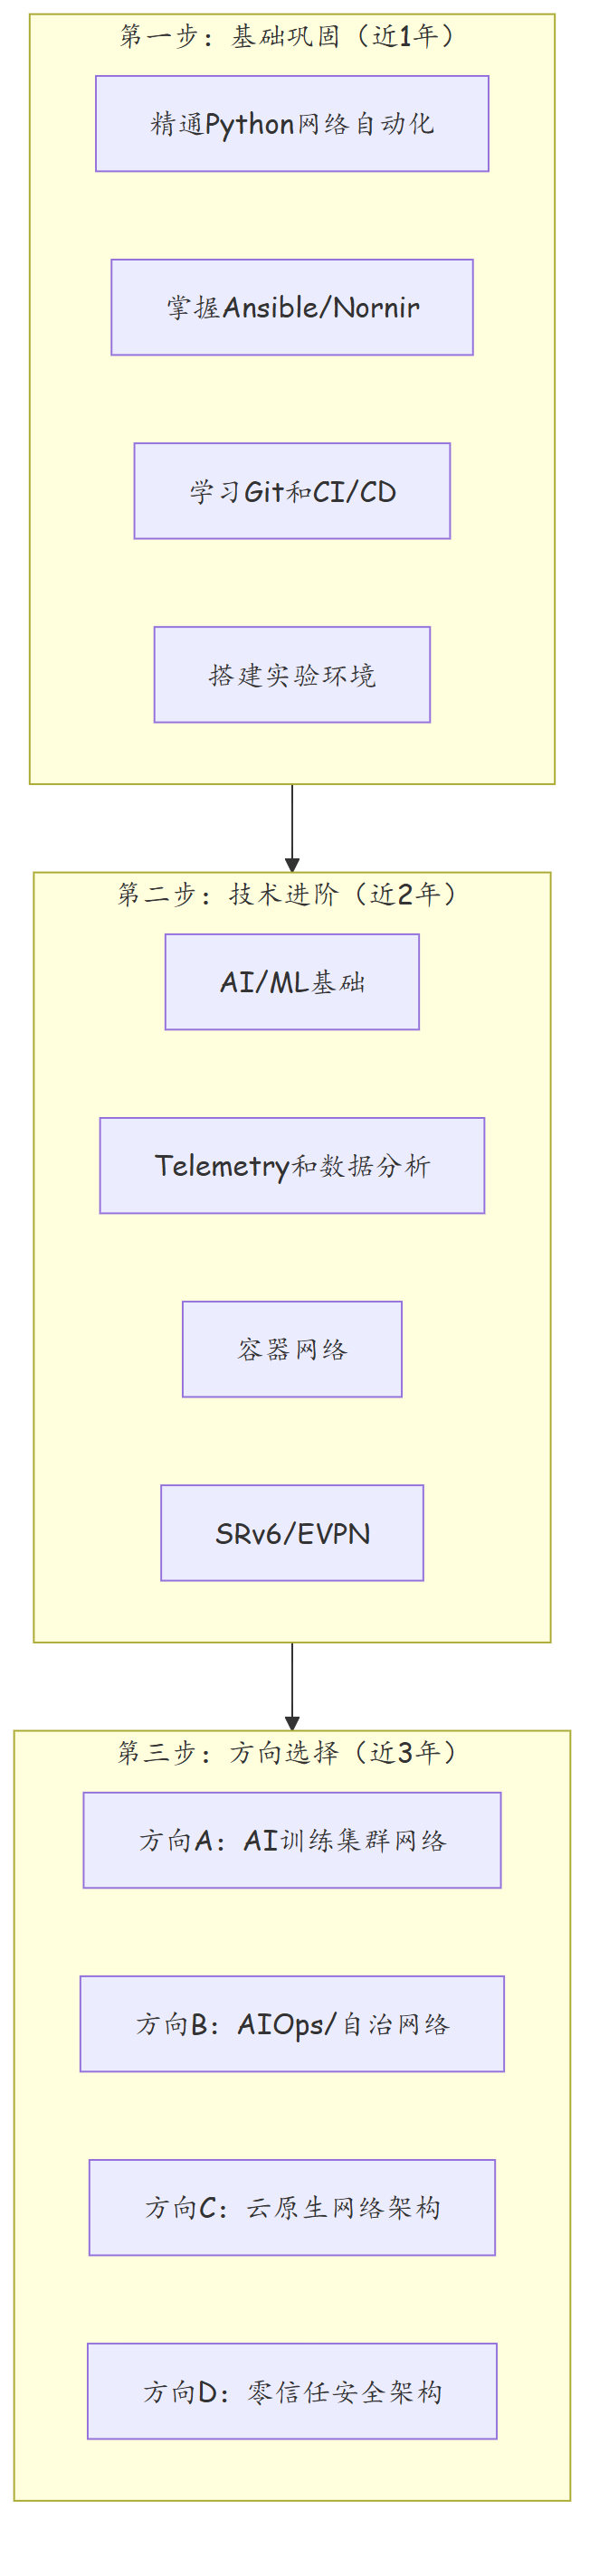
| AI/ML基础 | 理解数据科学,非写模型 | 2-3个月 |
| Python编程 | 自动化脚本、数据分析 | 1-2个月 |
| 数据分析 | Telemetry/流量建模 | 2-3个月 |
| 云原生网络 | K8s/Calico/Service Mesh | 3-6个月 |
| 零信任安全 | SASE/ZTNA架构 | 1-2个月 |
5.3 推荐学习路径
5.4 保持竞争力的关键
| 原则 | 具体行动 |
|---|---|
| 拥抱变化但不追热点 | 基础越扎实,学新技术越快;选择1-2个方向深耕 |
| 编程能力是必修课 | Python是基础,不需要成为软件工程师 |
| 数据思维 | 从CLI到结构化数据,从单点到数据驱动 |
| 持续学习 | 订阅技术博客、参加技术会议、动手实践 |
| 商业意识 | 理解业务需求、用业务语言说技术、关注ROI |
六、经验总结
|------|---------|---------|---------| | 1 | AI运维 | AIOps不是替代人,而是增强人的能力 | 运维转型 | | 2 | 数据质量 | AI模型的效果取决于数据质量,先治理数据 | AI项目 | | 3 | 渐进式推进 | 从L2到L5需要5-10年,不要一步到位 | 规划 | | 4 | 人机协同 | AI做决策建议,人工做最终确认(L4之前) | 安全边界 | | 5 | 数字孪生 | 变更前先在孪生体仿真,降低现网风险 | 变更管理 | | 6 | 意图驱动 | 从"配置网络"转向"描述意图"是范式转变 | 理念升级 | | 7 | 人才储备 | AI+网络需要既懂网络又懂AI的复合型人才 | 团队建设 | | 8 | 算法选择 | 不同场景选择不同算法,没有万能方案 | 算法设计 | | 9 | 可解释性 | AI决策必须可解释,否则运维不敢用 | 信任建立 | | 10 | 持续进化 | AI模型需要持续用新数据训练和迭代 | 模型运维 |
思考
- 当AI能够自动完成90%的运维工作时,网络工程师的核心竞争力将是什么?
- 自动驾驶网络的终极形态是"无需人类参与",但这是否意味着网络工程师这一职业会消失?
- 在AI与网络融合的过程中,数据安全和AI模型的可靠性如何保障?
恭喜完成全部365篇学习!
从OSI七层模型到AI驱动网络,从VLAN基础到算网融合,这365篇文章覆盖了数通技术的核心知识体系。无论你现在处于哪个职业阶段,这段学习旅程都将为你提供坚实的技术基础。
知识的力量不在于记住多少,而在于能否灵活运用。 将这365篇文章作为工具书,在实际工作中随时查阅、反复阅读、不断实践,你终将成长为一名优秀的网络工程师。
感谢你的坚持与学习!愿你在网络技术的道路上越走越远,不断突破、持续精进。