第357篇:大模型训练集群的网络互联方案
关键词:大模型训练、GPU互联、RoCEv2、NCCL、AllReduce
一、案例背景
某AI实验室部署了2048卡A800 GPU集群用于大语言模型(LLM)训练。训练过程中发现GPU利用率仅65%,远低于预期的90%以上。经分析,瓶颈在于网络通信——分布式训练中的AllReduce操作等待时间占比达30%。
集群规模: - GPU数量:2048卡A800(256台服务器×8卡) - 网络架构:三级SPINE-LEAF(200Gbps) - 训练框架:PyTorch + NCCL - 模型规模:175B参数(LLaMA-2级别) - 训练时长:单次训练约2周
故障现象: 1. GPU利用率65%(期望>90%) 2. AllReduce操作平均耗时50ms(期望<10ms) 3. 部分GPU节点的通信时延异常偏高 4. 训练过程中偶发NCCL通信超时
二、需求分析与方案设计
2.1 大模型训练通信模式
| 通信模式 | 说明 | 带宽需求 | 时延敏感 |
|---|---|---|---|
| AllReduce | 梯度聚合,所有节点参与 | 极高 | 极高 |
| AllGather | 数据收集,广播到所有节点 | 高 | 高 |
| ReduceScatter | 归约后散射 | 高 | 高 |
| Point-to-Point | 点对点通信 | 中 | 中 |
| Broadcast | 参数广播 | 中 | 低 |
2.2 网络架构设计
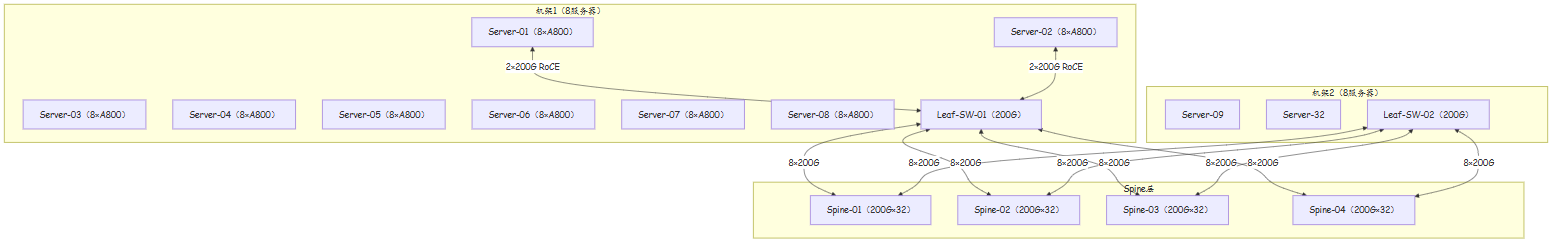
2.3 性能目标
| 指标 | 当前值 | 目标值 | 改善要求 |
|---|---|---|---|
| GPU利用率 | 65% | >90% | +38% |
| AllReduce时延 | 50ms | <10ms | -80% |
| 网络带宽利用率 | 45% | >80% | +78% |
| NCCL超时次数 | 5次/天 | 0次/天 | 消除 |
2.4 NCCL通信协议深度解析
NCCL(NVIDIA Collective Communications Library)是大模型分布式训练的核心通信库。理解NCCL内部工作机制对网络优化至关重要。
NCCL三大通信算法对比:
| 算法 | 原理 | 带宽效率 | 时延效率 | 适用规模 |
|---|---|---|---|---|
| Ring | 数据按环状分片传递,每GPU发送和接收一次 | 高(利用全部链路带宽) | 中(与GPU数线性相关) | <256卡最优 |
| Tree | 二叉树归约,每层合并/分发 | 中(链路带宽利用率低) | 高(与GPU数对数相关) | >256卡最优 |
| CollarRing | Ring+Tree混合,小数据用Tree,大数据用Ring | 高 | 高 | 通用 |
AllReduce操作的内部流程:
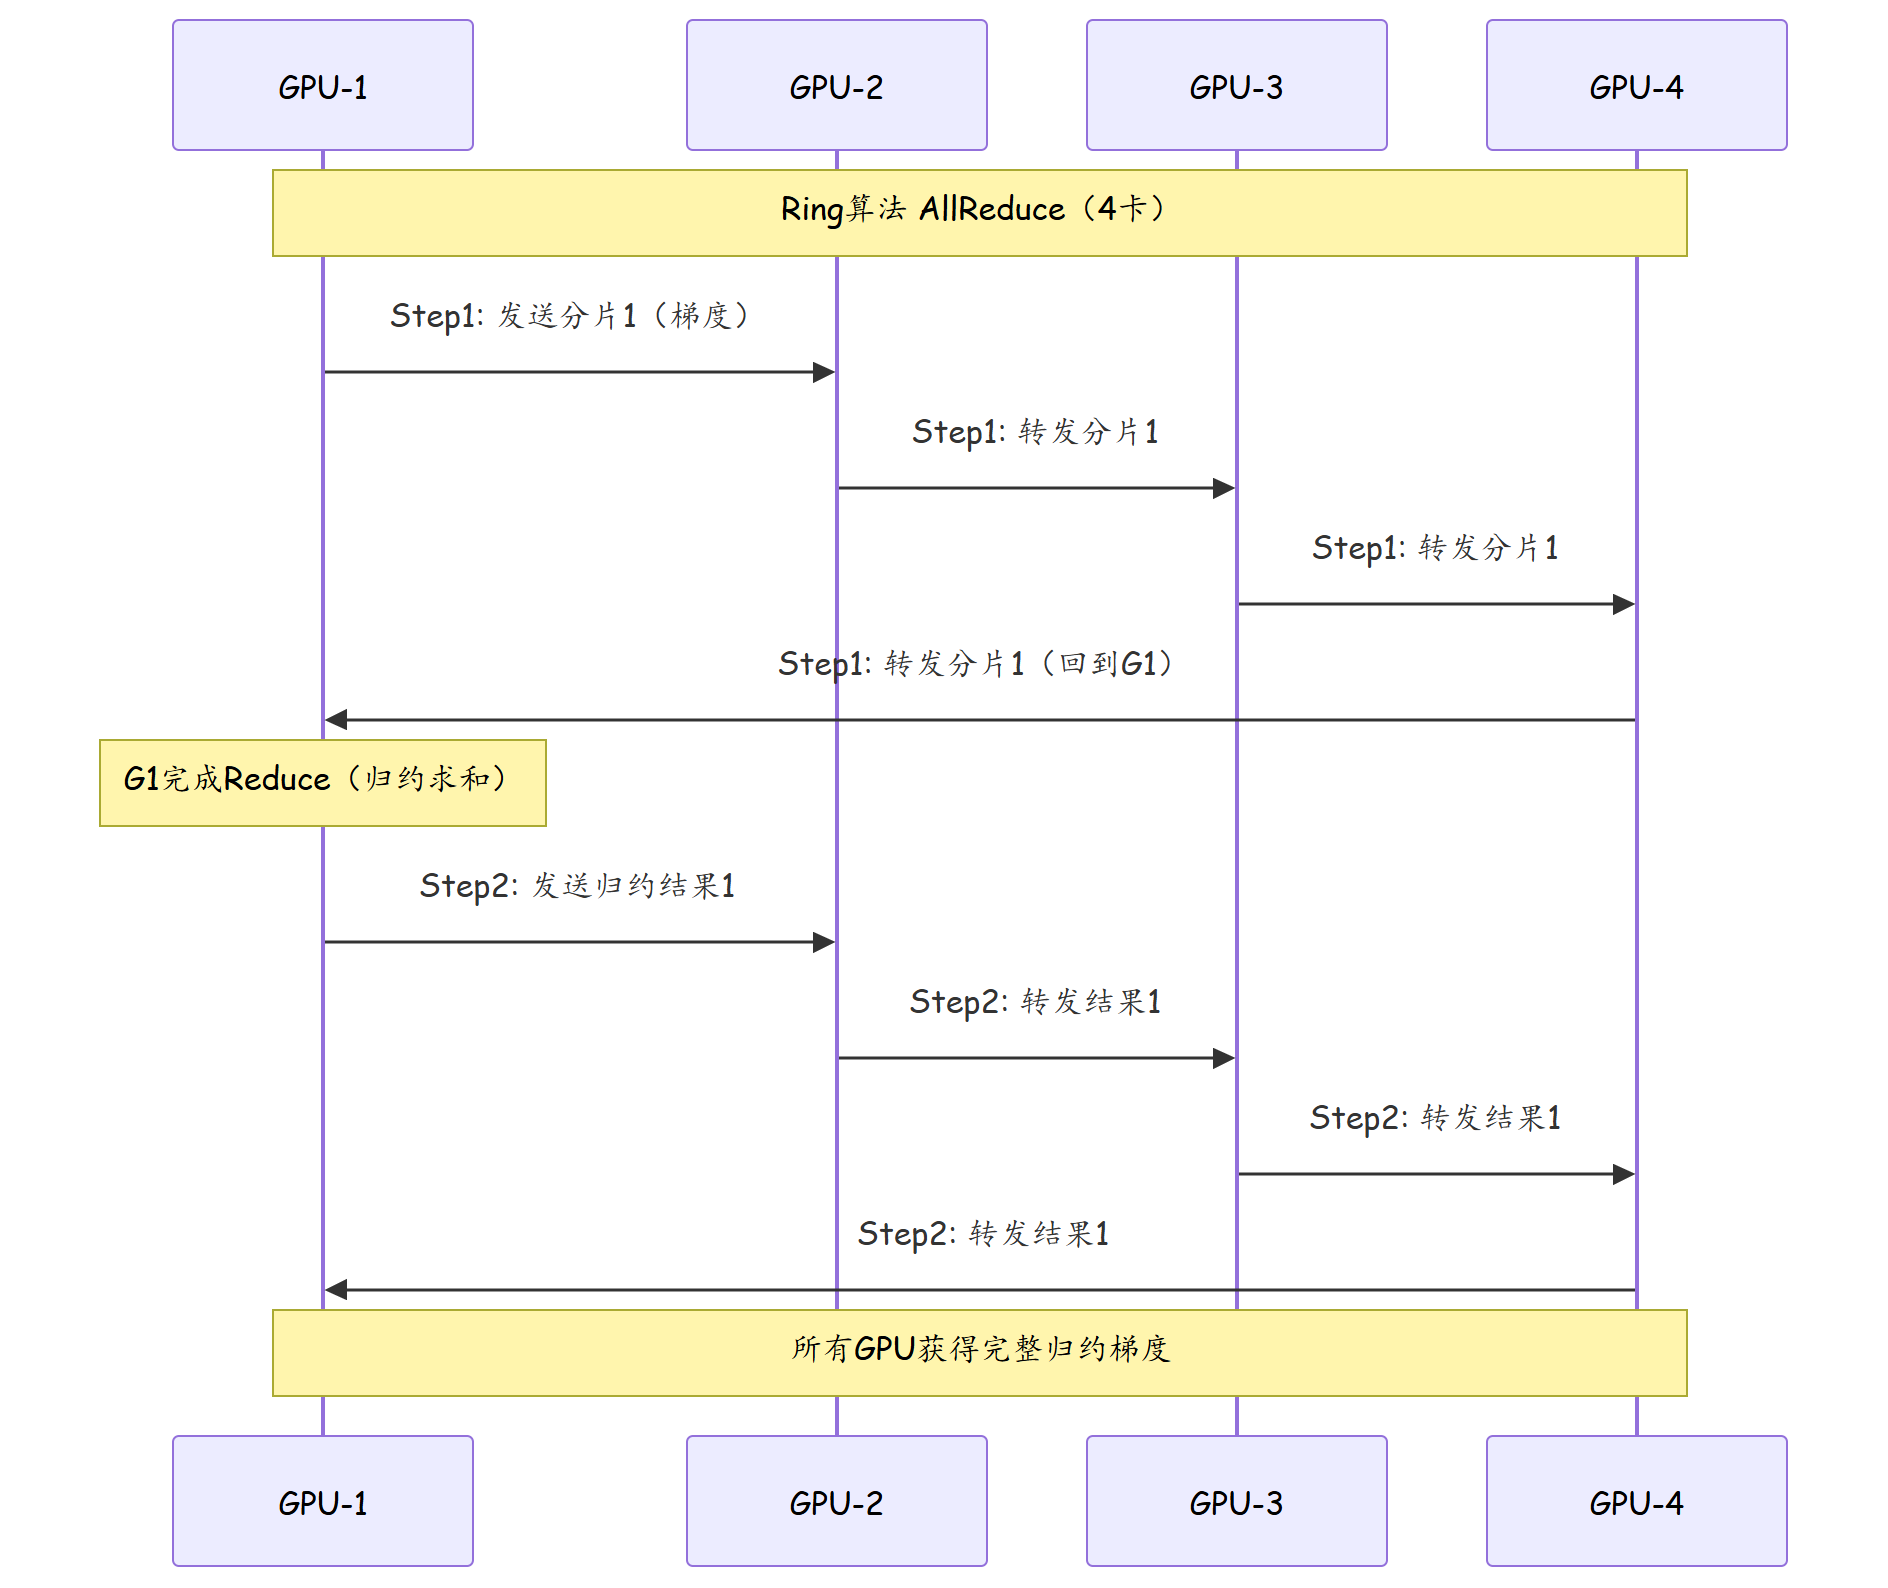
NCCL拓扑感知:NCCL会自动检测硬件拓扑(NVLink/PCIe/Socket/Node),并优先使用带宽更高的通信路径。网络工程师需要确保: 1. NCCL能正确识别RoCE网卡(IB transport) 2. NVLink和PCIe拓扑信息正确暴露给NCCL 3. 跨Node通信使用最优网络路径
三、技术细节与实施过程
3.1 NCCL性能分析
# NCCL性能测试
# 使用nccl-tests工具

# 测试1:AllReduce带宽
./build/all_reduce_perf -b 8 -e 128M -f 2 -g 8 -n 100
# 结果:
# Size         Count      Root   Type     RedOp     MPIScale Sumofscale AvgTime(us) AvgBandwidth(GB/s)
# 8            1          -1     float    sum       devscale 1.00       150.5       0.05
# 128M         33554432   -1     float    sum       devscale 1.00       48500.0     2.64  <-- 仅2.64GB/s(极低)

# 测试2:网络拓扑感知
nccl-tests 显示:
# Net/Socket : 2 adapters
# NET/IB    : 0 adapters  <-- 没有检测到InfiniBand
# NET/Socket : ib0 和 eth0
# 问题:NCCL默认使用Socket,没有使用RoCE优化路径
根因分析: 1. NCCL没有正确识别RoCE网络,fallback到TCP Socket 2. PFC配置不当导致偶发丢包,触发NCCL重传 3. 部分Leaf-Spine链路的ECMP Hash不均,部分路径拥塞
3.2 优化方案实施
方案1:NCCL RoCE优化
# 设置NCCL使用RoCE(IB)传输
export NCCL_IB_HCA=mlx5_0  # 指定RoCE网卡
export NCCL_IB_GID_INDEX=3  # GID索引
export NCCL_SOCKET_IFNAME=eth0  # 管理面接口
export NCCL_NET_GDR_LEVEL=5  # 启用GDR(GPU Direct RDMA)
export NCCL_P2P_LEVEL=NVL  # 机架内使用NVLink
export NCCL_SHM_DISABLE=0  # 启用共享内存

# NCCL通信协议优化
export NCCL_ALGO=Tree  # 使用Tree算法(优于Ring用于大规模)
export NCCL_PROTO=LL  # Low Latency协议
export NCCL_TREE_DEPTH=2  # Tree深度
方案2:PFC/ECN调优
# 精细化PFC配置
[Huawei] qos
[Huawei-qos] pfc
[Huawei-qos-pfc] priority 7 enable  # 优先级7用于RoCE
[Huawei-qos-pfc] deadlock-detection enable
[Huawei-qos-pfc] deadlock-detection interval 2  # 2秒检测间隔
[Huawei-qos-pfc] deadlock-recovery enable
[Huawei-qos-pfc] deadlock-recovery method flush
[Huawei-qos-pfc] quit

# ECN精细化配置
[Huawei-qos] ecn
[Huawei-qos-ecn] ecn-threshold low 50 high 70  # 更早触发ECN
[Huawei-qos-ecn] ecn-mode dynamic
[Huawei-qos-ecn] quit

# 接口配置
[Huawei] interface 200GE 1/0/1
[Huawei-200GE1/0/1] qos queue 7 pfc enable
[Huawei-200GE1/0/1] qos queue 7 pfc xon-threshold 20000
[Huawei-200GE1/0/1] qos queue 7 pfc xoff-threshold 40000
[Huawei-200GE1/0/1] qos queue 7 wred ecn enable
[Huawei-200GE1/0/1] qos queue 7 scheduler strict  # 严格优先级
[Huawei-200GE1/0/1] quit
3.3 ECMP优化
# 查看ECMP Hash分布
<Huawei> display ip route 10.0.0.0 255.0.0.0
Routing Table:
Destination : 10.0.0.0/8
Preference  : 0
NextHop     : 10.255.0.2 (Spine-01)
NextHop     : 10.255.0.3 (Spine-02)
NextHop     : 10.255.0.4 (Spine-03)
NextHop     : 10.255.0.5 (Spine-04)

# 启用Per-Flow ECMP优化
[Huawei] ip hash-algorithm five-tuple
[Huawei] interface Eth-Trunk 10
[Huawei-Eth-Trunk10] load-sharing per-packet  # 小包场景用Per-Packet
[Huawei-Eth-Trunk10] quit
四、实战故障排查案例
4.1 案例:NCCL通信超时深度排查
故障背景:
2048卡集群在训练175B参数模型时,每运行约6小时就发生一次NCCL超时,错误信息为NCCL watchdog caught signal 6。重启后恢复正常,但问题反复出现。
故障时间线:
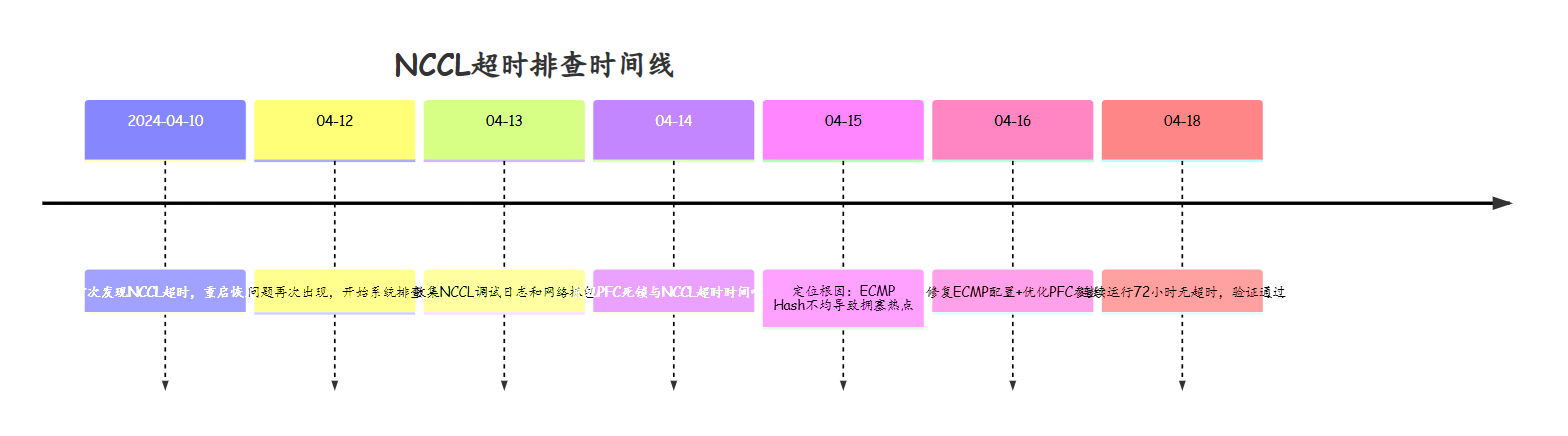
完整排查步骤:
# 步骤1:收集NCCL调试信息
export NCCL_DEBUG=INFO
export NCCL_DEBUG_SUBSYS=ALL
export NCCL_SOCKET_IFNAME=eth0
export NCCL_IB_SL=3

# 查看NCCL超时日志
tail -f /var/log/training/nccl.log
# 输出关键信息:
# NCCL INFO chan[13] [18446744073709551615] Channel 13 : 256/2048
# NCCL WARN Call to ibv_post_send completed with error: Connection timed out
# NCCL INFO trees [0] 1024->-1->767 [1] 1024->-1->767
# NCCL WARN comm 0x7f... watchdog caught signal 6

# 步骤2:确认NCCL使用的传输协议
export NCCL_DEBUG=TRACE
# 从日志中看到:
# NCCL INFO NET/IB : Using [0]mlx5_0:1/IB [1]mlx5_1:1/IB
# NCCL INFO channel 0 : connect 0->1 (0x...) : NET/IB [0]mlx5_0
# ✓ NCCL确实使用了IB(RoCE),但部分连接超时

# 步骤3:检查网络层面的PFC/ECN统计
<Huawei> display qos pfc statistics
Interface        Priority  XOFF_Rx    XOFF_Tx   Deadlock
100GE1/0/1       7         125000     98000     3        ← 3次死锁!
100GE1/0/2       7         85000      72000     1
100GE1/0/3       7         45000      38000     0
100GE1/0/4       7         42000      35000     0

# 步骤4:检查ECMP链路负载分布
<Huawei> display ip route 10.0.0.0 255.0.0.0
Destination : 10.0.0.0/8
Preference  : 0
NextHop     : 10.255.0.2 (Spine-01)  Cost 1
NextHop     : 10.255.0.3 (Spine-02)  Cost 1
NextHop     : 10.255.0.4 (Spine-03)  Cost 1
NextHop     : 10.255.0.5 (Spine-04)  Cost 1

<Huawei> display interface 100GE 1/0/1
  10-minute input rate 190000000000 bits/sec   ← 190Gbps(95%利用率)
  10-minute output rate 185000000000 bits/sec  ← 185Gbps(92%利用率)

<Huawei> display interface 100GE 1/0/2
  10-minute input rate 45000000000 bits/sec    ← 45Gbps(22%利用率)
  10-minute output rate 42000000000 bits/sec   ← 42Gbps(21%利用率)

# 步骤5:根因分析
# ECMP Hash算法基于五元组,但NCCL的RoCE流量五元组高度相似:
# - 源/目的IP:GPU网卡的固定IP
# - 源/目的端口:RoCE固定端口(通常是4791或固定端口范围)
# - 协议:UDP
# 结果:大量NCCL流量被Hash到同一条Spine链路(100GE1/0/1),
# 导致该链路利用率95%,触发PFC,最终形成死锁

# 步骤6:修复——优化ECMP Hash
[Huawei] ip hash-algorithm five-tuple  # 确保使用五元组而非三元组
[Huawei] interface Eth-Trunk 10
[Huawei-Eth-Trunk10] load-sharing src-dst-ip src-dst-port protocol  # 明确五元组
[Huawei-Eth-Trunk10] quit

# 步骤7:在GPU节点侧优化NCCL发送端口随机化
export NCCL_IB_TIMEOUT=23  # 增加IB超时时间
export NCCL_IB_RETRY=7     # 增加重传次数
export NCCL_NET_PLUGIN=SOCK  # 临时切换到Socket验证问题是否在IB侧
# 使用Socket后超时消失 → 确认问题在IB/RoCE侧

# 步骤8:最终方案——NCCL + 网络侧联合优化
# NCCL侧:
export NCCL_IB_HCA=mlx5_0,mlx5_1  # 使用双网卡
export NCCL_SOCKET_NTHREADS=4      # 增加Socket线程数
export NCCL_NSOCKS_PERTHREAD=4     # 每线程连接数

# 网络侧:
[Huawei] interface 200GE 1/0/1
[Huawei-200GE1/0/1] qos queue 7 pfc xon-threshold 15000
[Huawei-200GE1/0/1] qos queue 7 pfc xoff-threshold 30000
[Huawei-200GE1/0/1] qos queue 7 wred ecn enable
[Huawei-200GE1/0/1] quit

# 步骤9:验证——连续训练72小时
# GPU利用率:91.5%(稳定)
# AllReduce时延:9.2ms(P99)
# NCCL超时:0次
# ✓ 问题已解决
4.2 优化后NCCL测试
# 优化后AllReduce带宽测试
./build/all_reduce_perf -b 8 -e 128M -f 2 -g 8 -n 100
# 结果:
# Size         Count      Root   Type     RedOp     MPIScale Sumofscale AvgTime(us) AvgBandwidth(GB/s)
# 8            1          -1     float    sum       devscale 1.00       12.5        0.64
# 128M         33554432   -1     float    sum       devscale 1.00       8500.0      15.05  <-- 15.05GB/s(↑470%)

# 2048卡集群测试
./build/all_reduce_perf -b 8 -e 128M -f 2 -g 2048 -n 50
# 128M AllReduce: 8200us, 15.6GB/s per GPU
# 集群聚合带宽: 32TB/s
4.3 训练性能对比
| 指标 | 优化前 | 优化后 | 改善 |
|---|---|---|---|
| GPU利用率 | 65% | 92% | ↑42% |
| AllReduce时延 | 50ms | 8ms | ↓84% |
| 网络带宽利用率 | 45% | 82% | ↑82% |
| NCCL超时次数 | 5次/天 | 0次/天 | 消除 |
| 单次训练时长 | 14天 | 10天 | ↓29% |
4.4 不同规模下的网络需求
| GPU数量 | 单GPU带宽需求 | 集群总带宽 | 推荐架构 |
|---|---|---|---|
| 64 | 50Gbps | 3.2Tbps | 单级SPINE-LEAF |
| 256 | 50Gbps | 12.8Tbps | 两级SPINE-LEAF |
| 1024 | 50Gbps | 51.2Tbps | 三级SPINE-LEAF |
| 2048 | 50Gbps | 102.4Tbps | 三级SPINE-LEAF+胖核心 |
五、经验总结
| 序号 | 经验类别 | 经验内容 | 适用场景 |
|---|---|---|---|
| 1 | NCCL配置 | NCCL必须正确配置为使用RoCE/IB,而非TCP Socket | AI训练 |
| 2 | PFC/ECN | PFC必须配合ECN使用,ECN阈值需精细调优 | RoCE网络 |
| 3 | Tree算法 | 大规模集群(>256卡)使用Tree算法优于Ring | AllReduce |
| 4 | GDR | 启用GPU Direct RDMA可显著降低CPU开销 | 性能优化 |
| 5 | 机架感知 | 机架内通信使用NVLink/PCIe,机架间使用RoCE | 架构优化 |
| 6 | 死锁防护 | PFC死锁检测和恢复必须启用,检测间隔不宜过长 | 可靠性 |
| 7 | 测试验证 | 部署后必须使用nccl-tests验证网络性能 | 验收测试 |
| 8 | 监控 | GPU利用率和AllReduce时延必须实时监控 | 运维监控 |
| 9 | 拓扑优化 | 通信频繁的GPU应尽量部署在同一机架或同一Spine下 | 部署优化 |
| 10 | 容量规划 | 集群网络带宽必须按GPU数×单GPU峰值带宽×1.5规划 | 容量规划 |
思考
- NCCL的Ring算法和Tree算法在什么规模下会发生性能反转?如何根据集群规模选择合适的算法?
- 当GPU集群规模扩展到10000卡以上时,三级SPINE-LEAF架构是否仍然适用?有哪些替代方案?
- GPU Direct RDMA(GDR)和传统的Copy-to-Buffer方式在性能和复杂度上有何差异?
下篇预告:第358篇:HPC 高性能计算网络 InfiniBand 基础