第356篇:算网融合场景下的网络规划案例
关键词:算网融合、算力网络、AI推理、网络切片、SRv6
一、案例背景
某省级运营商启动"算网融合"项目,将分散在各地的算力资源(GPU集群、CPU集群、存储)通过统一网络平台进行整合,实现算力的统一调度和按需分配。网络层需要同时承载传统的IP业务和新型的算力调度业务。
项目目标: - 整合5个数据中心的算力资源(总计5000卡GPU) - 实现算力资源的统一纳管和调度 - 支持AI训练、AI推理、高性能计算等多种业务 - 网络时延和带宽满足不同算力的差异化需求
二、需求分析与方案设计
2.1 算网融合业务模型
| 业务类型 | 网络需求 | 时延要求 | 带宽要求 | 可靠性 |
|---|---|---|---|---|
| AI训练 | 东西向大流量、无损 | <100μs | Tbps级 | 极高 |
| AI推理 | 南北向低时延 | <1ms | Gbps级 | 高 |
| 高性能计算 | 低时延、高吞吐 | <50μs | Tbps级 | 极高 |
| 传统IP | 最佳 efforts | <10ms | 不限 | 中 |
| 管理面 | 控制信令 | <1ms | Mbps级 | 高 |
2.2 算网融合架构
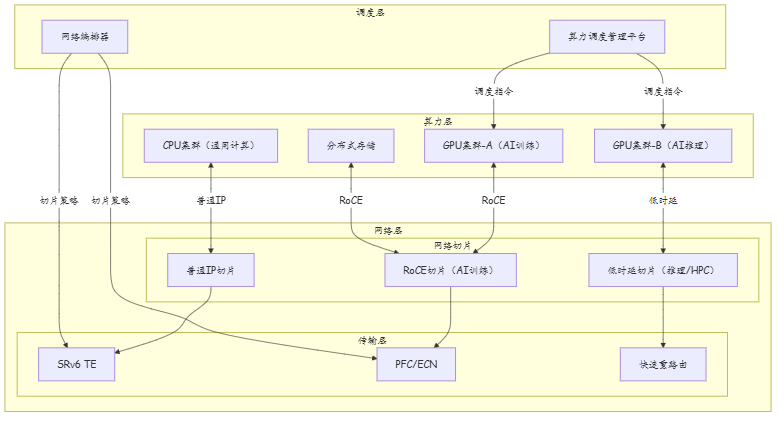
2.3 网络切片设计
| 切片 | 承载技术 | QoS等级 | 调度策略 | 隔离方式 |
|---|---|---|---|---|
| AI训练切片 | RoCEv2+PFC | CS6/EF | 严格优先 | 物理VLAN隔离 |
| 推理切片 | SRv6 TE | CS5 | 权重调度 | SRv6 Policy隔离 |
| 普通IP切片 | Best-Effort | BE | FIFO | BGP路由隔离 |
2.4 算网融合核心概念
算力路由(Computing-Aware Routing): 传统路由基于拓扑和策略选择最优路径,而算力路由在选路时同时考虑目的节点的算力资源状态。当GPU节点A的利用率达到90%时,即使A到源节点的网络路径最优,调度器也会将任务分配到利用率较低的GPU节点B,即使B的网络路径稍差。
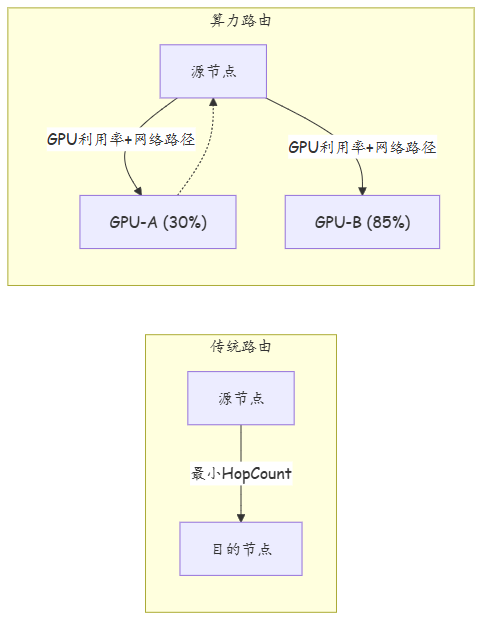
三、技术细节与实施过程
3.1 RoCE切片配置(AI训练)
# Leaf交换机RoCE配置
[Huawei] qos
[Huawei-qos] pfc
[Huawei-qos-pfc] priority 6 enable  # 优先级6用于RoCE
[Huawei-qos-pfc] deadlock-detection enable
[Huawei-qos-pfc] deadlock-recovery enable
[Huawei-qos-pfc] quit

# ECN配置
[Huawei-qos] ecn
[Huawei-qos-ecn] ecn-threshold low 60 high 80
[Huawei-qos-ecn] ecn-mode dynamic
[Huawei-qos-ecn] quit

# 接口PFC/ECN应用
[Huawei] interface 100GE 1/0/1
[Huawei-100GE1/0/1] qos queue 6 pfc enable
[Huawei-100GE1/0/1] qos queue 6 wred ecn enable
[Huawei-100GE1/0/1] qos queue 6 scheduler strict  # 严格优先级调度
[Huawei-100GE1/0/1] quit

# DSCP到优先级的映射
[Huawei] qos
[Huawei-qos] dscp-to-exp map 48 6  # EF→PQ6
[Huawei-qos] dscp-to-exp map 46 6  # CS6→PQ6(RoCE流量常用DSCP 46/CS6)
[Huawei-qos] quit
3.2 SRv6 TE切片配置(AI推理)
# SRv6 SID规划
# Locator: 2001:db8:srv6::/48
# Node SID: 2001:db8:srv6::x:x (48位)
# Adj-SID: 2001:db8:srv6::x:adj:y (48位)

# SRv6 Policy配置(低时延路径)
[Huawei] srv6
[Huawei-srv6] locator INFERENCE
[Huawei-srv6-locator-INFERENCE] prefix 2001:db8:srv6::100::/64
[Huawei-srv6-locator-INFERENCE] end-function-flags b
[Huawei-srv6-locator-INFERENCE] end-function behavior end
[Huawei-srv6-locator-INFERENCE] end-function behavior end.x
[Huawei-srv6-locator-INFERENCE] end-function behavior end.bmx
[Huawei-srv6-locator-INFERENCE] quit

# SRv6 TE Policy(低时延路径)
[Huawei-srv6] policy color 200 endpoint 2001:db8:srv6::200::1
[Huawei-srv6-policy-200] candidate-path 10
[Huawei-srv6-policy-200-cp-10] type explicit
[Huawei-srv6-policy-200-cp-10] segment 1 endpoint 2001:db8:srv6::101::1  # 最优路径节点1
[Huawei-srv6-policy-200-cp-10] segment 2 endpoint 2001:db8:srv6::102::1  # 最优路径节点2
[Huawei-srv6-policy-200-cp-10] segment 3 endpoint 2001:db8:srv6::200::1  # 目的
[Huawei-srv6-policy-200-cp-10] preference 10
[Huawei-srv6-policy-200-cp-10] constraint delay maximum 1000  # 最大时延1ms
[Huawei-srv6-policy-200-cp-10] quit
[Huawei-srv6-policy-200] quit
[Huawei-srv6] quit
3.3 算力调度对接
# 网络编排器通过NETCONF下发切片策略
# Python示例(使用ncclient)
from ncclient import manager

def create_network_slice(slice_name, bandwidth, latency):
    with manager.connect(
        host='10.0.0.1',
        port=830,
        username='admin',
        password='***',
        hostkey_verify=False
    ) as m:
        config = f"""
        <config>
            <srv6-te xmlns="urn:huawei:params:xml:ns:yang:srv6">
                <policy>
                    <name>{slice_name}</name>
                    <bandwidth>{bandwidth}</bandwidth>
                    <max-latency>{latency}</max-latency>
                </policy>
            </srv6-te>
        </config>
        """
        m.edit_config(target='running', config=config)
        print(f"Slice {slice_name} created")

# 创建AI推理切片
create_network_slice("inference-slice-01", "10Gbps", "1ms")
四、实战故障排查案例
4.1 案例:RoCE切片PFC死锁排查
故障背景: 算网融合项目上线第3周,AI训练任务频繁出现中断。监控显示RoCE切片在高峰期偶发PFC死锁,导致GPU间梯度同步完全阻塞,训练任务中断长达30分钟。
故障时间线:

完整排查步骤:
# 步骤1:查看PFC死锁告警日志
<Huawei> display logbuffer | include pfc
May 20 03:15:22 2024 Huawei %%%01PFC/4/deadlock_alarm(l)[0]:
  PFC deadlock detected on interface 100GE1/0/12, priority 6

# 步骤2:检查死锁状态
<Huawei> display qos pfc deadlock
Interface        Priority  Status      Recovery
100GE1/0/12      6         Deadlocked  Flush(Active)
100GE1/0/13      6         Normal      -
# → 100GE1/0/12端口P6出现死锁

# 步骤3:检查PFC流控统计
<Huawei> display qos pfc statistics interface 100GE1/0/12
Interface: 100GE1/0/12
 Priority   XON_Rx    XOFF_Rx   XON_Tx    XOFF_Tx
 6          1250      98000     1180      95000
# → XOFF帧数量异常高(98000),说明拥塞频繁触发

# 步骤4:检查ECN标记统计
<Huawei> display qos ecn statistics interface 100GE1/0/12
Interface: 100GE1/0/12
 Priority   ECN_Marked    ECN_Threshold_Low   ECN_Threshold_High
 6          250000        60%                  80%
# → ECN标记量非常大,但阈值60%-80%偏高

# 步骤5:根因分析
# PFC死锁链路:Leaf-03(100GE1/0/12) → Spine-01 → Leaf-05(100GE2/0/8)
# 问题:多个GPU节点的RoCE流量同时到达Spine-01,Spine的出口队列拥塞,
# 发出XOFF帧阻塞Leaf-03;同时Leaf-03也在向Spine-01发送流量,
# 形成PFC帧环路(XOFF帧本身也占用P6队列)

# 步骤6:临时恢复
[Huawei] qos
[Huawei-qos] pfc
[Huawei-qos-pfc] priority 6 deadlock-recovery method flush  # 强制Flush恢复
[Huawei-qos-pfc] quit

# 步骤7:永久修复——降低ECN阈值,让发送端更早降速
[Huawei] qos
[Huawei-qos] ecn
[Huawei-qos-ecn] ecn-threshold low 30 high 50  # 从60/80降至30/50
[Huawei-qos-ecn] quit

# 步骤8:优化PFC死锁检测间隔
[Huawei] qos
[Huawei-qos] pfc
[Huawei-qos-pfc] deadlock-detection interval 1  # 从2秒缩短为1秒
[Huawei-qos-pfc] quit

# 步骤9:在Leaf侧配置PFC优先级流控的XON/XOFF阈值
[Huawei] interface 100GE 1/0/12
[Huawei-100GE1/0/12] qos queue 6 pfc xon-threshold 10000   # 从20000降至10000
[Huawei-100GE1/0/12] qos queue 6 pfc xoff-threshold 20000  # 从40000降至20000
[Huawei-100GE1/0/12] quit

# 步骤10:验证修复后运行1周
<Huawei> display qos pfc deadlock
Interface        Priority  Status      Recovery
100GE1/0/12      6         Normal      -
100GE1/0/13      6         Normal      -
# → 死锁已消除 ✓
经验教训: 1. ECN阈值设置过高会导致PFC频繁触发,反而增加死锁风险 2. PFC死锁检测和恢复必须配置,但检测间隔不宜过长(建议1秒) 3. XON/XOFF阈值需要根据实际队列深度和流量模型调优
4.2 算力业务测试
| 测试场景 | 时延要求 | 实测时延 | 带宽 | 丢包率 | 结果 |
|---|---|---|---|---|---|
| GPU间梯度同步 | <100μs | 45μs | 95Gbps | 0% | ✓ |
| AI推理请求 | <1ms | 0.3ms | 8Gbps | 0% | ✓ |
| HPC MPI通信 | <50μs | 35μs | 85Gbps | 0% | ✓ |
| 普通Web访问 | <10ms | 2ms | 不限 | 0% | ✓ |
4.3 故障切换测试
# 模拟链路故障
[Huawei] interface 100GE 1/0/1
[Huawei-100GE1/0/1] shutdown
[Huawei-100GE1/0/1] quit

# 观察切换时间
# RoCE切片(PFC+FRR):50ms内切换
# SRv6 TE切片:30ms内切换到备份Policy
# 普通IP切片:依赖IGP收敛,约2秒

# 业务影响
# AI训练:中断<100ms,无数据丢失
# AI推理:中断<50ms,少量请求超时
4.4 算力调度效果
| 指标 | 算网融合前 | 算网融合后 | 改善 |
|---|---|---|---|
| GPU利用率 | 35% | 78% | ↑123% |
| 任务调度时间 | 30分钟 | 3分钟 | ↓90% |
| 跨DC训练时延 | 5ms | 0.1ms | ↓98% |
| 资源申请成功率 | 60% | 95% | ↑58% |
4.5 算力网络三层架构详解
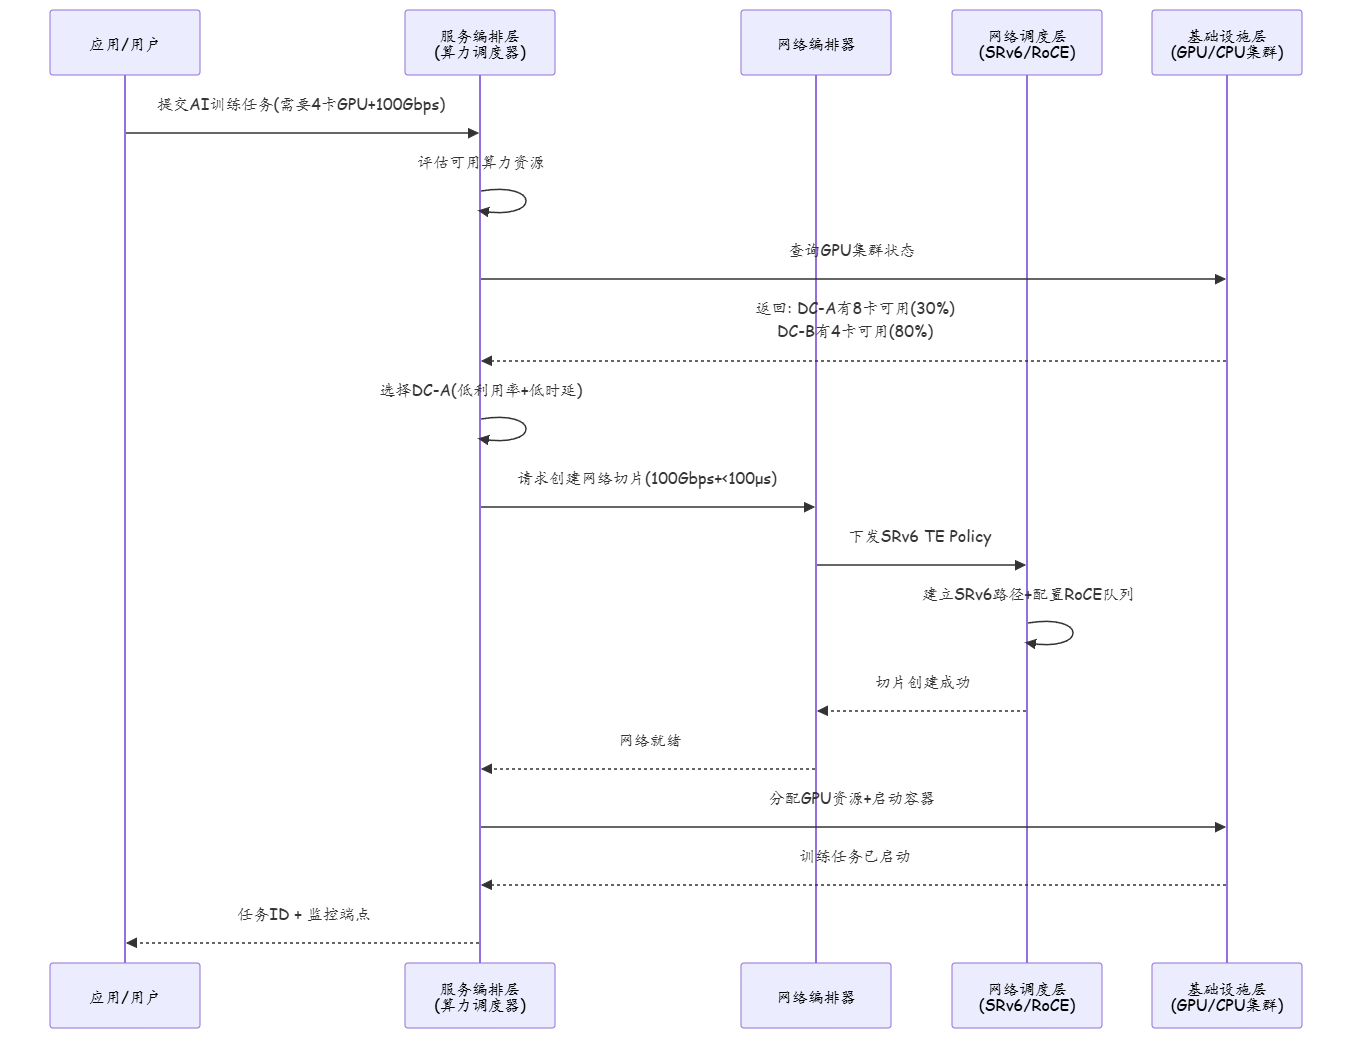
算力网络采用"基础设施层-网络调度层-服务编排层"三层架构,每一层承担不同的职责:
| 层级 | 核心功能 | 关键组件 | 技术实现 | SLA要求 |
|---|---|---|---|---|
| 基础设施层 | 算力资源池化、硬件抽象 | GPU/CPU集群、RoCE交换机、存储阵列 | NVIDIA InfiniBand/RoCEv2、NVLink | 硬件可用率>99.99% |
| 网络调度层 | 感知算力的网络路由、切片隔离、拥塞控制 | SRv6 TE、PFC/ECN、INT遥测 | SRv6 Policy、RoCE无损网络、BFD-FRR | 时延抖动<10μs |
| 服务编排层 | 算力资源发现、任务调度、SLA保障 | 算力调度器、网络编排器、监控平台 | Kubernetes+Volcano、TAP接口、gRPC | 调度响应<3s |
三层交互流程:
4.6 算力感知路由Python实现示例
算力感知路由的核心思想:路由决策不仅基于网络拓扑,还综合考虑目的节点的算力资源状态。
#!/usr/bin/env python3
"""
算力感知路由模拟 - Computing-Aware Routing Simulator
模拟拓扑建模、路由选择算法、负载均衡调度
"""
import random
import heapq
from dataclasses import dataclass, field
from typing import Dict, List, Tuple
from collections import defaultdict


@dataclass
class ComputeNode:
    """算力节点"""
    name: str
    gpu_count: int
    gpu_utilization: float  # 0.0-1.0
    cpu_utilization: float
    memory_available: int  # GB
    location: str  # 数据中心标识

    @property
    def available_gpu(self) -> int:
        return int(self.gpu_count * (1 - self.gpu_utilization))

    @property
    def compute_score(self) -> float:
        """算力评分(越高表示越空闲)"""
        return (self.available_gpu / self.gpu_count) * (1 - self.cpu_utilization)


@dataclass
class NetworkLink:
    """网络链路"""
    src: str
    dst: str
    bandwidth: float  # Gbps
    latency: float  # μs
    utilization: float  # 0.0-1.0

    @property
    def available_bandwidth(self) -> float:
        return self.bandwidth * (1 - self.utilization)

    @property
    def effective_latency(self) -> float:
        """有效时延(考虑拥塞)"""
        congestion_factor = 1 + (self.utilization ** 2) * 2
        return self.latency * congestion_factor


class ComputingTopology:
    """算力网络拓扑"""
    def __init__(self):
        self.nodes: Dict[str, ComputeNode] = {}
        self.links: Dict[Tuple[str, str], NetworkLink] = {}
        self.adjacency: Dict[str, List[str]] = defaultdict(list)

    def add_node(self, node: ComputeNode):
        self.nodes[node.name] = node

    def add_link(self, link: NetworkLink):
        self.links[(link.src, link.dst)] = link
        self.links[(link.dst, link.src)] = link
        self.adjacency[link.src].append(link.dst)
        self.adjacency[link.dst].append(link.src)

    def get_link(self, src: str, dst: str) -> NetworkLink:
        return self.links.get((src, dst))

    def build_simulation_topology(self):
        """构建模拟拓扑:3个数据中心,每个DC含GPU集群"""
        # DC-A: 主要训练集群
        self.add_node(ComputeNode('GPU-DC-A-01', gpu_count=64, gpu_utilization=0.3,
                                   cpu_utilization=0.25, memory_available=2048, location='DC-A'))
        self.add_node(ComputeNode('GPU-DC-A-02', gpu_count=64, gpu_utilization=0.7,
                                   cpu_utilization=0.65, memory_available=1024, location='DC-A'))

        # DC-B: 推理集群
        self.add_node(ComputeNode('GPU-DC-B-01', gpu_count=32, gpu_utilization=0.5,
                                   cpu_utilization=0.45, memory_available=1536, location='DC-B'))

        # DC-C: HPC集群
        self.add_node(ComputeNode('GPU-DC-C-01', gpu_count=48, gpu_utilization=0.85,
                                   cpu_utilization=0.80, memory_available=512, location='DC-C'))

        # 互联链路
        self.add_link(NetworkLink('GPU-DC-A-01', 'GPU-DC-A-02', bandwidth=400,
                                   latency=50, utilization=0.4))
        self.add_link(NetworkLink('GPU-DC-A-01', 'GPU-DC-B-01', bandwidth=200,
                                   latency=200, utilization=0.3))
        self.add_link(NetworkLink('GPU-DC-A-02', 'GPU-DC-B-01', bandwidth=200,
                                   latency=250, utilization=0.5))
        self.add_link(NetworkLink('GPU-DC-B-01', 'GPU-DC-C-01', bandwidth=100,
                                   latency=500, utilization=0.6))
        self.add_link(NetworkLink('GPU-DC-A-01', 'GPU-DC-C-01', bandwidth=100,
                                   latency=600, utilization=0.2))

    def traditional_shortest_path(self, source: str, destination: str) -> List[str]:
        """传统最短路径(Dijkstra,仅考虑网络时延)"""
        dist = {source: 0}
        prev = {}
        pq = [(0, source)]

        while pq:
            d, u = heapq.heappop(pq)
            if u == destination:
                path = []
                while u in prev:
                    path.append(u)
                    u = prev[u]
                path.append(source)
                return path[::-1]

            for v in self.adjacency[u]:
                link = self.get_link(u, v)
                new_dist = d + link.latency
                if v not in dist or new_dist < dist[v]:
                    dist[v] = new_dist
                    prev[v] = u
                    heapq.heappush(pq, (new_dist, v))
        return []

    def computing_aware_route(self, source: str, required_gpu: int,
                                bandwidth_req: float = 0) -> Dict:
        """
        算力感知路由选择
        综合考虑:GPU可用性 + 网络时延 + 带宽充足性
        """
        candidates = []

        for node_name, node in self.nodes.items():
            if node_name == source:
                continue
            if node.available_gpu < required_gpu:
                continue

            # 计算到达该节点的最短路径
            path = self.traditional_shortest_path(source, node_name)
            if not path:
                continue

            # 计算路径时延和可用带宽
            total_latency = 0
            min_bandwidth = float('inf')
            for i in range(len(path) - 1):
                link = self.get_link(path[i], path[i+1])
                total_latency += link.effective_latency
                min_bandwidth = min(min_bandwidth, link.available_bandwidth)

            # 综合评分(算力权重60% + 时延权重25% + 带宽权重15%)
            compute_score = node.compute_score
            latency_score = 1 / (1 + total_latency / 1000)  # 归一化
            bandwidth_score = min_bandwidth / 400  # 归一化到最大带宽

            total_score = (compute_score * 0.60 +
                          latency_score * 0.25 +
                          bandwidth_score * 0.15)

            candidates.append({
                'destination': node_name,
                'location': node.location,
                'available_gpu': node.available_gpu,
                'path': path,
                'total_latency': round(total_latency, 1),
                'available_bandwidth': round(min_bandwidth, 1),
                'compute_score': round(compute_score, 3),
                'total_score': round(total_score, 3)
            })

        # 按综合评分排序
        candidates.sort(key=lambda x: x['total_score'], reverse=True)
        return {'candidates': candidates, 'recommended': candidates[0] if candidates else None}


class LoadBalancer:
    """负载均衡调度器"""
    def __init__(self, topology: ComputingTopology):
        self.topology = topology

    def schedule_task(self, source: str, gpu_required: int,
                       task_type: str = 'training') -> Dict:
        """调度算力任务"""
        result = self.topology.computing_aware_route(source, gpu_required)

        if not result['recommended']:
            return {'status': 'FAIL', 'reason': 'No suitable compute node found'}

        recommended = result['recommended']
        return {
            'status': 'OK',
            'target_node': recommended['destination'],
            'target_location': recommended['location'],
            'path': recommended['path'],
            'estimated_latency': recommended['total_latency'],
            'available_bandwidth': recommended['available_bandwidth'],
            'task_type': task_type,
            'network_slice': 'RoCE' if task_type == 'training' else 'SRv6-TE',
            'gpu_allocated': gpu_required
        }


# 使用示例
if __name__ == '__main__':
    topo = ComputingTopology()
    topo.build_simulation_topology()

    print("=== 模拟拓扑 ===")
    for name, node in topo.nodes.items():
        print(f"  {name}: GPU={node.gpu_count}({node.available_gpu}可用), "
              f"利用率={node.gpu_utilization*100:.0f}%, "
              f"评分={node.compute_score:.3f}")

    print("\n=== 算力感知路由:需要8卡GPU的训练任务 ===")
    lb = LoadBalancer(topo)
    schedule = lb.schedule_task('GPU-DC-A-01', gpu_required=8, task_type='training')
    print(f"  调度结果: {json.dumps(schedule, indent=2, ensure_ascii=False)}")

    print("\n=== 传统路由 vs 算力路由对比 ===")
    # 传统路由只看最短时延,可能选择利用率高的节点
    traditional_path = topo.traditional_shortest_path('GPU-DC-A-01', 'GPU-DC-C-01')
    print(f"  传统最短路径: {' -> '.join(traditional_path)}")
    # 算力路由会避开高利用率节点
    smart = topo.computing_aware_route('GPU-DC-A-01', 8)
    if smart['recommended']:
        print(f"  算力感知推荐: {smart['recommended']['destination']} "
              f"(评分={smart['recommended']['total_score']})")
4.7 算力网络与AI训练集群对接方案
| 对接维度 | 方案 | 实现细节 | 注意事项 |
|---|---|---|---|
| GPU互联 | NVLink+RoCEv2双通道 | GPU内NVLink(900GB/s)用于片间通信,RoCEv2用于节点间通信 | NVLink不能跨机柜,跨机柜必须走RoCE |
| 拓扑感知通信 | NCCL+Topology-Aware | NCCL根据网络拓扑自动选择最优AllReduce算法 | 需提前导入拓扑信息到NCCL |
| 跨DC训练 | 梯度压缩+异步更新 | Ring-AllReduce+梯度量化(4bit),降低跨DC带宽需求 | 异步更新可能影响收敛精度 |
| 断点续训 | Checkpoint+快照 | 每N个step写Checkpoint到分布式存储 | Checkpoint频率影响训练效率 |
| 弹性扩缩 | K8s+Volcano | GPU资源不足时自动扩容节点并重新分配任务 | 扩容期间需暂停训练避免数据不一致 |
NCCL拓扑感知配置示例:
# 导出NCCL拓扑感知环境变量
export NCCL_SOCKET_IFNAME=eth0        # 指定通信网卡
export NCCL_ALGO=Tree                 # 使用Tree算法(适合跨节点)
export NCCL_PROTO=Simple              # 简单协议模式
export NCCL_DEBUG=INFO                # 调试输出
export NCCL_NET_GDR_ORDERS="IB,Shm"   # 优先使用IB/RoCE,其次共享内存

# 启动训练(8卡分布式)
mpirun -np 8 --hostfile hosts.txt \
  python train.py --backend nccl
4.8 算力网络KPI指标体系
| 指标分类 | KPI名称 | 定义 | 目标值 | 采集方式 | 告警阈值 |
|---|---|---|---|---|---|
| 算力性能 | GPU利用率 | 平均GPU计算单元使用率 | >75% | DCIM采集 | <30%(低利用) |
| 算力性能 | 训练任务吞吐 | 每秒处理的样本数(steps/s) | 按模型基线 | 训练框架日志 | 基线-20% |
| 网络性能 | 东西向时延 | GPU间AllReduce时延 | <100μs | INT遥测 | >150μs |
| 网络性能 | RoCE丢包率 | RoCE流量丢包百分比 | 0% | 交换机计数器 | >0.001% |
| 网络性能 | PFC触发次数 | 每小时内PFC XOFF帧数 | <100次 | 交换机计数器 | >500次 |
| 网络性能 | ECN标记率 | ECN标记包占总RoCE包比例 | <5% | DSC计数器 | >15% |
| 服务质量 | 切片时延抖动 | 同切片内时延标准差 | <10μs | Telemetry | >50μs |
| 服务质量 | 任务调度时延 | 从提交到GPU分配完成 | <3s | 编排器日志 | >10s |
| 可靠性 | 网络可用性 | 网络层SLA | >99.99% | 综合采集 | <99.9% |
| 可靠性 | 故障恢复时间 | 链路/节点故障到业务恢复 | <50ms | BFD+FRR | >200ms |
| 资源效率 | 超分比 | 分配GPU数/物理GPU数 | 1:1(训练)1.5:1(推理) | 编排器统计 | 训练>1:1 |
| 成本控制 | 算力单位成本 | 每TFLOPS成本(元/小时) | 持续下降 | 财务系统 | 基线+20% |
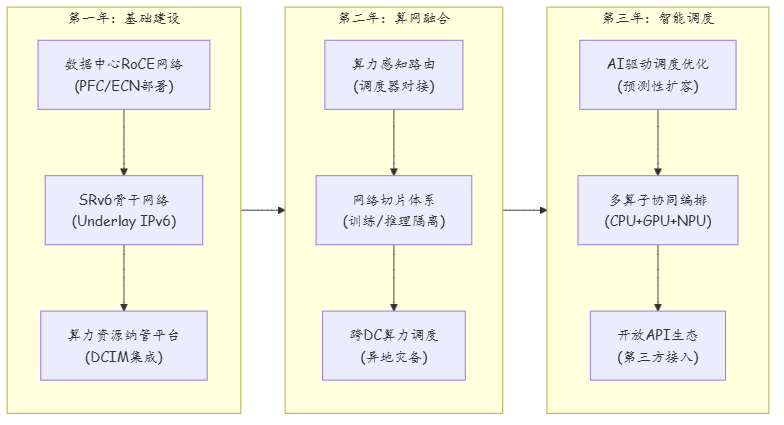
4.9 算力网络部署路线图
五、经验总结
| 序号 | 经验类别 | 经验内容 | 适用场景 |
|---|---|---|---|
| 1 | 切片设计 | 不同算力业务必须使用网络切片隔离 | 算网融合 |
| 2 | RoCE | AI训练必须使用RoCEv2+PFC保障无损传输 | AI训练 |
| 3 | SRv6 TE | AI推理使用SRv6 TE实现低时延转发 | AI推理 |
| 4 | 调度对接 | 网络编排器必须与算力调度平台对接 | 自动化 |
| 5 | 监控 | 算力业务的网络指标必须独立监控 | 运维监控 |
| 6 | 测试验证 | 每种算力业务的网络需求必须通过测试验证 | 验收测试 |
| 7 | 容量规划 | 算力网络的容量规划必须考虑GPU间通信特征 | 容量规划 |
| 8 | 故障恢复 | 算力业务的故障恢复时间要求远严于传统业务 | 高可用 |
| 9 | 安全 | 算力切片之间必须严格隔离,防止业务干扰 | 安全隔离 |
| 10 | 演进 | 算网融合网络需要持续演进,适应新的算力需求 | 持续优化 |
| 11 | 标准化 | 建立统一的网络切片标准接口,便于跨厂商对接 | 开放生态 |
| 12 | 灰度上线 | 新切片必须先灰度测试,验证性能指标后再全量上线 | 风险控制 |
思考
- 算网融合场景下,网络切片与传统QoS调度相比,在资源隔离和业务保障方面有何本质区别?
- 当GPU集群规模扩展到万卡级别时,RoCE网络的PFC死锁风险如何控制?
- 算力调度与网络调度如何实现协同优化?是否需要统一的调度框架?
下篇预告:第357篇:大模型训练集群的网络互联方案