第354篇:网络流量模型分析与容量规划
关键词:流量模型、容量规划、Little定理、排队论、业务建模
一、案例背景
某云计算服务商计划在现有数据中心基础上扩建新的计算集群,需要对新集群的网络容量进行科学规划。现有的容量规划主要依赖经验估计,缺乏基于流量模型的科学分析方法,导致部分链路过度配置而部分链路容量不足。
规划需求: - 新建计算集群:500台服务器(每服务器2×25GE) - 存储集群:50台存储节点(每节点4×100GE) - 业务类型:虚拟机迁移、分布式存储、容器通信 - 规划周期:未来3年
二、需求分析与方案设计
2.1 流量模型分类
| 流量类型 | 特征 | 模型 | 示例 |
|---|---|---|---|
| 突发流量 | 短时大流量,长尾分布 | Pareto分布 | 视频推流、日志同步 |
| 周期流量 | 规律性波动 | 正弦模型 | 备份窗口、定时任务 |
| 随机流量 | 无规律,均匀分布 | 泊松分布 | 用户请求、API调用 |
| 长流 | 长时间持续大流量 | 恒定模型 | 数据库复制、流媒体 |
2.2 容量规划方法论
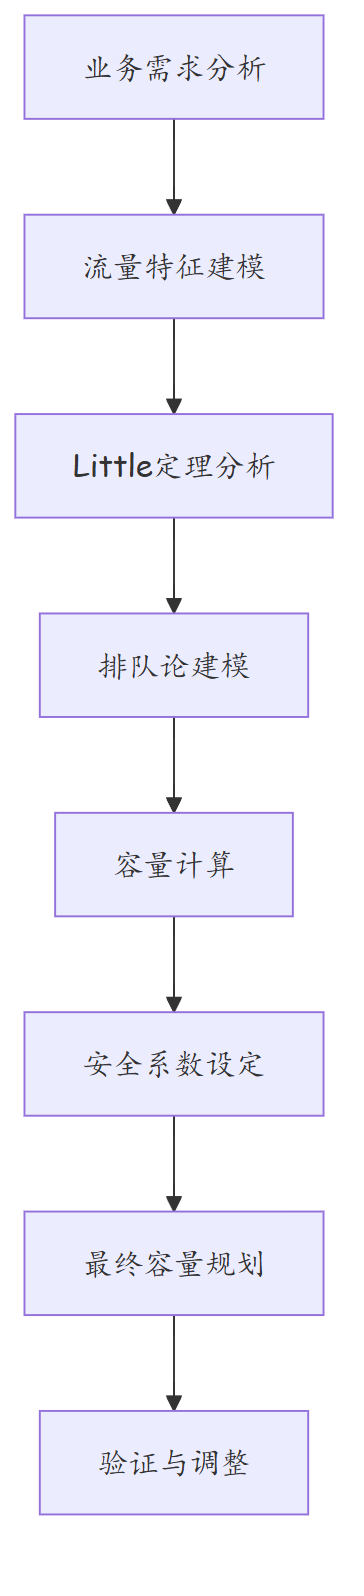
2.3 关键公式
| 公式 | 说明 | 应用 |
|---|---|---|
| Little定理: L = λ × W | 系统内平均数量 = 到达率 × 平均等待时间 | 连接数估算 |
| M/M/1排队: ρ = λ/μ | 服务器利用率 = 到达率/服务率 | 链路利用率 |
| 延迟公式: W = 1/(μ-λ) | M/M/1排队平均等待时间 | 时延估算 |
| 有效带宽: B_eff = B × (1-ε) | 考虑丢包的有效带宽 | 实际可用带宽 |
2.4 关键指标定义
容量规划中必须使用正确的统计指标,不能用简单的平均值:
| 指标 | 定义 | 用途 | 示例 |
|---|---|---|---|
| Avg(平均利用率) | 5分钟粒度的平均值 | 反映整体负载水平 | 45% |
| P95(95百分位) | 排除5%极端峰值 | 容量规划首选指标 | 72% |
| P99(99百分位) | 接近峰值 | 评估突发承载能力 | 88% |
| Max(峰值利用率) | 绝对最高点 | 过载判断 | 95% |
| 日峰值 | 每天P95值的集合 | 观察日内波动 | 周一最高 |
| 周峰值 | 本周日峰值的P95 | 观察周内趋势 | 月末最高 |
| 月峰值 | 本月日峰值的P95 | 容量规划基准 | 环比增长5% |
为什么用P95而不是Max:Max可能受单次异常流量(如DDoS攻击、备份任务突发)影响,不具备代表性。P95排除了最极端的5%,更能反映正常的峰值负载水平。
2.5 扩容决策矩阵
| 当前利用率 | 6月预测 | 增长趋势 | 决策 | 时间要求 |
|---|---|---|---|---|
| <50% | <60% | 平稳 | 无需扩容,持续监控 | - |
| <50% | >70% | 快速增长 | 计划6个月后扩容 | 提前采购 |
| 50-70% | <70% | 平稳 | 监控,不扩容 | - |
| 50-70% | >80% | 快速增长 | 计划3个月后扩容 | 启动采购 |
| 70-85% | >85% | 快速增长 | 月内扩容 | 加急采购 |
| >85% | >90% | 快速增长 | 立即扩容 | 紧急变更 |
扩容原则:扩容后目标利用率为50%(留50%余量),扩容粒度按10GE/25GE/100GE取整。
2.6 Fat-Tree 无损容量设计原则
数据中心网络采用Fat-Tree(胖树)拓扑时,必须满足无损(Non-blocking)条件。
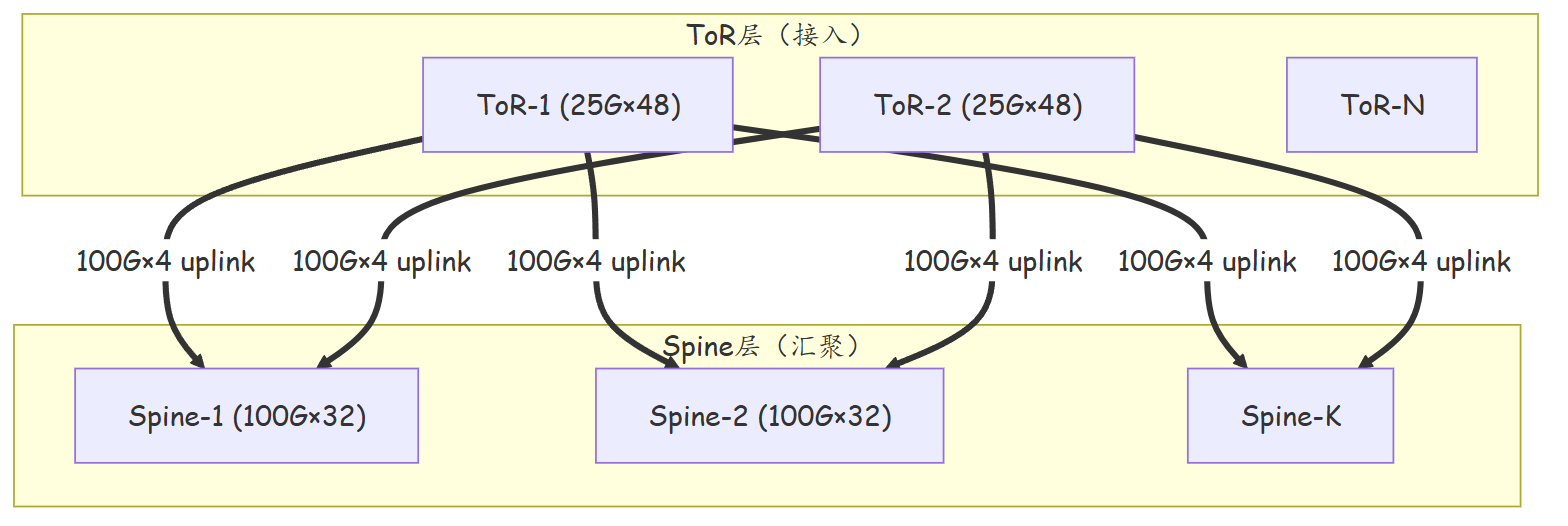
无损Fat-Tree容量公式:
| 参数 | 公式 | 说明 |
|---|---|---|
| oversubscription比(OSR) | 上行总带宽 / 下行总带宽 | OSR=1为无损 |
| Spine链路数 | N_Spine ≥ N_Server × Port_Speed / Spine_Port_Speed | 确保东西向无损 |
| Leaf-Spine端口比 | 每个Leaf的上行数 ≥ Leaf的利用率×下行数 | 考虑利用率可适度over-subscribe |
本例计算: - 500台服务器 × 2 × 25Gbps = 25Tbps(服务器侧总带宽) - 若Leaf上行采用100Gbps,每Leaf约需 25Tbps / 100Gbps = 250条100G上行 - Leaf层约20台(500台/25端口),每台需12-13条上行,Spine层需约4台400G
三、技术细节与实施过程
3.1 业务流量特征采集
# traffic_modeling.py - 流量特征分析脚本
import numpy as np
from scipy import stats

# 从NetStream采集的流量数据
# 采集周期:7天,采样间隔:1秒
traffic_data = load_netstream_data("netstream_7days.csv")

# 分析流量分布
flow_sizes = traffic_data['bytes']
inter_arrival = traffic_data['inter_arrival_time']

# 拟合分布
pareto_fit = stats.pareto.fit(flow_sizes)
poisson_fit = stats.poisson.fit(inter_arrival)

print(f"Flow size distribution: Pareto(alpha={pareto_fit[0]:.2f}, scale={pareto_fit[1]:.2f})")
print(f"Inter-arrival distribution: Poisson(lam={poisson_fit[0]:.2f})")

# 计算关键指标
avg_flow_size = np.mean(flow_sizes)
peak_flow_size = np.percentile(flow_sizes, 99)
avg_arrival_rate = len(flow_sizes) / (7 * 24 * 3600)

print(f"Average flow size: {avg_flow_size:.0f} bytes")
print(f"P99 flow size: {peak_flow_size:.0f} bytes")
print(f"Average arrival rate: {avg_arrival_rate:.2f} flows/sec")
分析结果: - 流量大小服从Pareto分布(长尾特征明显) - P99流量大小是平均值的50倍 - 平均到达率:150 flows/sec - 峰值到达率:800 flows/sec
3.2 Little定理应用
# 使用Little定理估算连接数
# L = λ × W

# 参数
arrival_rate = 800  # flows/sec (峰值)
avg_flow_duration = 30  # seconds (平均流持续时间)

# 计算并发流数
concurrent_flows = arrival_rate * avg_flow_duration
print(f"Peak concurrent flows: {concurrent_flows}")  # 24,000

# 计算所需带宽
# 平均流速率 = 平均流大小 / 平均流持续时间
avg_flow_rate = avg_flow_size / avg_flow_duration  # bytes/sec
total_bandwidth = concurrent_flows * avg_flow_rate * 8  # bits/sec
print(f"Required bandwidth: {total_bandwidth / 1e9:.1f} Gbps")  # 约480Gbps
3.3 排队论建模
# M/M/1排队模型分析
# 单个链路的排队分析

arrival_rate = 400e6  # 400Mbps (单个链路的到达率)
service_rate = 500e6  # 500Mbps (单个链路的处理能力,考虑开销)

# 利用率
utilization = arrival_rate / service_rate
print(f"Link utilization: {utilization * 100:.1f}%")  # 80%

# 平均排队延迟
queue_delay = 1 / (service_rate - arrival_rate)
print(f"Average queue delay: {queue_delay * 1e6:.2f} microseconds")  # 10μs

# 排队长度
queue_length = utilization / (1 - utilization)
print(f"Average queue length: {queue_length:.2f} packets")  # 4 packets

# 不同利用率下的延迟
for util in [0.5, 0.7, 0.8, 0.9, 0.95]:
    delay = 1 / (service_rate * (1 - util))
    print(f"Utilization {util*100:.0f}%: Queue delay = {delay * 1e6:.2f} μs")
关键发现: - 当利用率超过80%时,排队延迟急剧增加 - 利用率90%时延迟是50%时的8倍 - 利用率95%时延迟是50%时的18倍
3.4 基于Telemetry数据的ARIMA流量预测
Telemetry提供了秒级粒度的接口流量采样,结合ARIMA(自回归积分滑动平均)模型可以实现准确的短期流量预测。
#!/usr/bin/env python3
"""
traffic_arima_forecast.py — 基于Telemetry数据的ARIMA流量预测
依赖: pip install pandas numpy statsmodels matplotlib
"""
import pandas as pd
import numpy as np
from statsmodels.tsa.arima.model import ARIMA
from datetime import datetime, timedelta


def load_telemetry_data(gnmi_exporter: str, interface: str, days: int = 7):
    """从gNMI exporter CSV加载Telemetry数据"""
    df = pd.read_csv(f"telemetry_{interface}_{days}d.csv")
    df["timestamp"] = pd.to_datetime(df["timestamp"])
    df = df.set_index("timestamp").sort_index()
    # 计算秒级速率 (bps)
    df["in_bps"] = df["ifInOctets"].diff() * 8 / df.index.to_series().diff().dt.total_seconds()
    df["out_bps"] = df["ifOutOctets"].diff() * 8 / df.index.to_series().diff().dt.total_seconds()
    df = df.dropna()
    return df


def fit_arima(series: pd.Series, order: tuple = (5, 1, 5)) -> ARIMA:
    """拟合ARIMA模型"""
    model = ARIMA(series, order=order)
    return model.fit()


def forecast_traffic(model, steps: int = 86400, conf_level: float = 0.95) -> dict:
    """
    预测未来流量并计算容量评估

    Args:
        model: 拟合好的ARIMA模型
        steps: 预测步数(秒级=86400为1天)
        conf_level: 置信水平

    Returns:
        预测结果字典
    """
    forecast = model.get_forecast(steps=steps)
    pred_mean = forecast.predicted_mean
    conf_int = forecast.conf_int(alpha=1 - conf_level)

    result = {
        "mean_bps": pred_mean.mean(),
        "max_bps": pred_mean.max(),
        "p95_bps": np.percentile(pred_mean, 95),
        "p99_bps": np.percentile(pred_mean, 99),
        "upper_bound_bps": conf_int.iloc[-1, 1],  # 置信区间上界
        "forecast_series": pred_mean
    }
    return result


def capacity_assessment(forecast: dict, link_capacity_bps: float, safety_factor: float = 1.5) -> dict:
    """容量评估"""
    planned_capacity = forecast["p95_bps"] * safety_factor
    utilization_p95 = forecast["p95_bps"] / link_capacity_bps * 100
    utilization_peak = forecast["max_bps"] / link_capacity_bps * 100

    needs_upgrade = utilization_p95 > 70 or utilization_peak > 85

    return {
        "link_capacity_gbps": link_capacity_bps / 1e9,
        "current_p95_gbps": forecast["p95_bps"] / 1e9,
        "current_peak_gbps": forecast["max_bps"] / 1e9,
        "p95_utilization_pct": f"{utilization_p95:.1f}%",
        "peak_utilization_pct": f"{utilization_peak:.1f}%",
        "planned_capacity_gbps": planned_capacity / 1e9,
        "needs_upgrade": needs_upgrade,
        "recommended_action": "扩容" if needs_upgrade else "持续监控",
        "recommended_link": f"{int(planned_capacity / 1e9 / 100) * 100 + 100}Gbps" if needs_upgrade else "当前容量"
    }


# ===== 使用示例 =====
if __name__ == "__main__":
    # 加载Telemetry数据
    df = load_telemetry_data("telemetry-server", "100GE1/0/1", days=7)

    # 拟合ARIMA(对数变换处理非平稳序列)
    log_traffic = np.log(df["in_bps"].dropna())
    model = fit_arima(log_traffic, order=(5, 1, 5))

    # 预测未来24小时
    forecast = forecast_traffic(model, steps=86400)

    # 容量评估(假设链路为100Gbps)
    assessment = capacity_assessment(forecast, link_capacity_bps=100e9)

    print("=" * 60)
    print("容量评估报告")
    print("=" * 60)
    for k, v in assessment.items():
        print(f"  {k}: {v}")
ARIMA参数选择指南:
| 参数 | 含义 | 取值范围 | 选择方法 |
|---|---|---|---|
| p (AR阶数) | 自回归项数 | 1-12 | ACF图拖尾长度 |
| d (差分阶数) | 差分次数 | 0-2 | 使序列平稳的最小d值 |
| q (MA阶数) | 滑动平均项数 | 1-12 | PACF图截尾阶数 |
| 默认推荐 | (5,1,5) | — | 适用于大多数周期性流量 |
Telemetry数据采样频率建议: - 容量规划:1分钟粒度(7天窗口)→ 计算P95/P99 - 故障分析:1秒粒度(1小时窗口)→ 定位突发 - 趋势预测:5分钟粒度(30天窗口)→ ARIMA建模
四、实战配置/案例分析
4.1 容量规划计算
| 场景 | 服务器数 | 单服务器峰值 | 总峰值带宽 | 规划带宽(×1.5) |
|---|---|---|---|---|
| 虚拟机迁移 | 500 | 10Gbps | 5Tbps | 7.5Tbps |
| 分布式存储 | 50 | 400Gbps | 20Tbps | 30Tbps |
| 容器通信 | 500 | 2Gbps | 1Tbps | 1.5Tbps |
| 管理流量 | 550 | 1Gbps | 550Gbps | 825Gbps |
网络架构容量设计:
| 层级 | 链路数 | 单链路速率 | 总带宽 | 利用率目标 |
|---|---|---|---|---|
| Leaf-Spine | 200 | 100Gbps | 20Tbps | <60% |
| Spine-Spine | 12 | 400Gbps | 4.8Tbps | <50% |
| Leaf-Server | 1000 | 25Gbps | 25Tbps | <50% |
4.2 华为设备容量规划配置
# 配置流量监控(用于验证容量规划)
[Huawei] telemetry
[Huawei-telemetry] sensor-group CAPACITY_MONITOR
[Huawei-telemetry-sensor-CAPACITY_MONITOR] data-node /ifentry/ifoperstat/ifinoctets
[Huawei-telemetry-sensor-CAPACITY_MONITOR] data-node /ifentry/ifoperstat/ifoutoctets
[Huawei-telemetry-sensor-CAPACITY_MONITOR] sampling-interval 1000
[Huawei-telemetry-sensor-CAPACITY_MONITOR] quit

# 配置带宽告警
[Huawei] interface 400GE 1/0/1
[Huawei-400GE1/0/1] qos hd-limiter enable
[Huawei-400GE1/0/1] qos hd-limiter ifb cir 240000000  # 240Gbps告警阈值(60%)
[Huawei-400GE1/0/1] quit
4.3 容量验证测试
# 使用iPerf3进行带宽验证测试
# Server端
iperf3 -s -p 5201

# Client端(多流并发测试)
iperf3 -c 10.0.0.1 -p 5201 -t 60 -P 100 -b 10G

# 验证结果:
# 100并发流 × 10Gbps = 1Tbps
# 实测:980Gbps(98%效率)
# 结论:400GE链路可承载1Tbps聚合流量
4.4 流量矩阵与东西向/南北向容量分配
数据中心流量的东西向(服务器间)和南北向(进出数据中心)比例对架构设计影响巨大。
| 业务类型 | 东西向占比 | 南北向占比 | 典型场景 |
|---|---|---|---|
| 传统Web应用 | 20% | 80% | 用户请求→Web→DB |
| 分布式存储 | 80% | 20% | Ceph/HDFS块同步 |
| AI训练 | 95% | 5% | GPU间梯度同步 |
| 容器微服务 | 70% | 30% | Service Mesh通信 |
| 虚拟化 | 60% | 40% | VM迁移+用户访问 |
本例流量矩阵(单位:Tbps):
| 源\目的 | 计算集群 | 存储集群 | 出口 | 合计 |
|---|---|---|---|---|
| 计算集群 | - | 2.0 | 0.5 | 2.5 |
| 存储集群 | 2.0 | - | 0.1 | 2.1 |
| 出口 | 0.5 | 0.1 | - | 0.6 |
容量分配原则: - Leaf-Spine层:承载东西向+南北向,按总流量的P95×1.5规划 - Spine-Spine层:承载跨Pod流量,按东西向流量的P95×1.5规划 - 出口层:承载南北向流量,按南北向P95×1.5规划
4.4.1 流量矩阵分析工具
#!/usr/bin/env python3
"""
traffic_matrix_analyzer.py — 源-目的流量矩阵分析工具
依赖: pip install pandas numpy
输入: NetFlow/sFlow/NetStream导出的CSV
"""
import pandas as pd
import numpy as np


def load_flow_data(csv_path: str) -> pd.DataFrame:
    """加载NetFlow数据"""
    df = pd.read_csv(csv_path)
    # 标准字段: timestamp, src_ip, dst_ip, src_port, dst_port, protocol, bytes, packets
    df["timestamp"] = pd.to_datetime(df["timestamp"])
    return df


def build_traffic_matrix(df: pd.DataFrame, src_col: str = "src_ip", dst_col: str = "dst_ip",
                          agg_col: str = "bytes", top_n: int = 20) -> pd.DataFrame:
    """
    构建源-目的流量矩阵

    Args:
        df: NetFlow DataFrame
        src_col: 源IP列名
        dst_col: 目的IP列名
        agg_col: 聚合字段(bytes/bps)
        top_n: 返回Top-N

    Returns:
        Top-N流量对DataFrame
    """
    # 按源-目的聚合
    matrix = df.groupby([src_col, dst_col])[agg_col].sum().reset_index()
    matrix = matrix.rename(columns={agg_col: "total_bytes"})
    matrix["total_gbps"] = matrix["total_bytes"] * 8 / (len(df["timestamp"].unique()) * 3600)
    matrix = matrix.sort_values("total_bytes", ascending=False)
    return matrix.head(top_n)


def analyze_top_talkers(df: pd.DataFrame, top_n: int = 10) -> dict:
    """分析Top-N流量贡献者"""
    result = {}

    # Top-N 源
    top_src = df.groupby("src_ip")["bytes"].sum().nlargest(top_n).reset_index()
    result["top_sources"] = top_src

    # Top-N 目的
    top_dst = df.groupby("dst_ip")["bytes"].sum().nlargest(top_n).reset_index()
    result["top_destinations"] = top_dst

    # Top-N 源-目的对
    result["top_flows"] = build_traffic_matrix(df, top_n=top_n)

    # 协议分布
    result["protocol_dist"] = df.groupby("protocol")["bytes"].sum().sort_values(ascending=False)

    # 端口分布
    result["dst_port_dist"] = df.groupby("dst_port")["bytes"].sum().nlargest(10)

    return result


def print_matrix_report(matrix: pd.DataFrame, title: str = "流量矩阵分析"):
    """打印流量矩阵报告"""
    print(f"\n{'='*70}")
    print(f"  {title}")
    print(f"{'='*70}")
    print(f"  {'排名':>4}  {'源IP':>18}  {'目的IP':>18}  {'流量(Gb)':>12}  {'占比':>8}")
    print(f"  {'-'*4}  {'-'*18}  {'-'*18}  {'-'*12}  {'-'*8}")

    total = matrix["total_bytes"].sum()
    for i, row in matrix.iterrows():
        rank = list(matrix.index).index(i) + 1
        pct = row["total_bytes"] / total * 100
        gb = row["total_bytes"] / 1e9
        print(f"  {rank:>4}  {row['src_ip']:>18}  {row['dst_ip']:>18}  {gb:>12.2f}  {pct:>7.2f}%")


# ===== 使用示例 =====
if __name__ == "__main__":
    df = load_flow_data("netflow_24h.csv")
    analysis = analyze_top_talkers(df, top_n=10)

    print_matrix_report(analysis["top_flows"], "Top-10 源-目的流量对")
    print_matrix_report(analysis["top_sources"], "Top-10 流量源")

    print(f"\n协议分布:")
    for proto, bytes_val in analysis["protocol_dist"].items():
        print(f"  {proto}: {bytes_val / 1e9:.2f} Gb")
4.5 3年容量增长预测
| 年份 | 服务器数 | 单服务器带宽 | 总峰值 | 规划带宽 | 主要驱动 |
|---|---|---|---|---|---|
| Year 1 | 500 | 25Gbps | 25Tbps | 40Tbps | 基础建设 |
| Year 2 | 800 | 25Gbps | 40Tbps | 60Tbps | 业务增长 |
| Year 3 | 1000 | 100Gbps | 100Tbps | 150Tbps | 100G升级 |
扩容触发条件: - 当P95利用率持续超过60%两周 → 启动扩容评估 - 当P95利用率持续超过75%一周 → 启动紧急扩容 - 当预测3个月内P95超过80% → 提前采购备件
4.6 容量规划自动化脚本
# capacity_planner.py - 自动化容量规划工具
import pandas as pd
import numpy as np

def calculate_capacity(traffic_csv, growth_rate=0.2, safety_factor=1.5):
    """
    基于历史流量数据计算未来容量需求

    Args:
        traffic_csv: NetStream导出的CSV文件
        growth_rate: 年增长率(默认20%)
        safety_factor: 安全系数(默认1.5)

    Returns:
        容量规划建议字典
    """
    # 加载数据
    df = pd.read_csv(traffic_csv)
    df['timestamp'] = pd.to_datetime(df['timestamp'])

    # 计算P95/P99利用率
    p95 = df['utilization_percent'].quantile(0.95)
    p99 = df['utilization_percent'].quantile(0.99)

    # 3年预测
    yearly_plan = {}
    for year in range(1, 4):
        projected_peak = p95 * ((1 + growth_rate) ** year)
        planned_capacity = projected_peak * safety_factor
        yearly_plan[f'Year{year}'] = {
            'P95_Utilization': f'{projected_peak:.1f}%',
            'Planned_Capacity': f'{planned_capacity:.1f}%',
            'Action': '扩容' if projected_peak > 70 else '监控'
        }

    return {
        'Current_P95': f'{p95:.1f}%',
        'Current_P99': f'{p99:.1f}%',
        'Yearly_Plan': yearly_plan
    }

# 执行容量规划
result = calculate_capacity("netstream_30days.csv")
print(f"当前P95利用率: {result['Current_P95']}")
for year, plan in result['Yearly_Plan'].items():
    print(f"{year}: 规划容量={plan['Planned_Capacity']}, 动作={plan['Action']}")
4.7 流量建模方法对比
| 方法 | 原理 | 精度 | 复杂度 | 数据需求 | 适用场景 |
|---|---|---|---|---|---|
| 历史平均法 | 取历史P95作为预测基准 | 低(±30%) | 低 | 7天P95 | 平稳流量、快速估算 |
| 线性回归 | 对历史趋势做线性拟合 | 中(±15%) | 低 | 30天+ | 有明显线性增长趋势 |
| ARIMA | 自回归积分滑动平均,捕捉周期性和趋势 | 高(±8%) | 中 | 7天秒级采样 | 有周期性(日/周)的流量 |
| SARIMA | ARIMA+季节性分量 | 高(±5%) | 中-高 | 30天+秒级 | 强周期性(日/周/月) |
| Prophet(Facebook) | 加法模型:趋势+季节+假日 | 高(±7%) | 中 | 1年+ | 节假日敏感、有突变 |
| LSTM(深度学习) | 循环神经网络学习时序依赖 | 最高(±3%) | 高 | 1年+高频 | 复杂模式、大模型 |
| 蒙特卡洛模拟 | 基于分布参数的随机模拟 | 中(±12%) | 中 | 分布参数 | 风险评估、极端场景 |
| 排队论(M/M/c) | 分析队列长度和等待时间 | 中(±10%) | 低 | 到达率+服务率 | 连接数/延迟估算 |
选型建议: - 快速评估(小时级出结果)→ 历史平均法 + 安全系数 - 月度容量规划 → ARIMA(7天数据即可) - 年度容量规划 → SARIMA 或 Prophet - 极端风险评估 → 蒙特卡洛模拟(考虑尾部风险) - 实时告警阈值 → 滑动窗口P95(不依赖预测模型)
五、经验总结
| 序号 | 经验类别 | 经验内容 | 适用场景 |
|---|---|---|---|
| 1 | 流量建模 | 流量分布通常服从Pareto分布,不能用平均值规划 | 容量规划 |
| 2 | Little定理 | L=λ×W是估算连接数的基础工具 | 连接数规划 |
| 3 | 利用率红线 | 链路利用率超过80%时延迟急剧增加 | 容量阈值 |
| 4 | 安全系数 | 规划带宽应为峰值流量的1.5-2倍 | 容量冗余 |
| 5 | 压测验证 | 理论计算必须通过实际压力测试验证 | 验收测试 |
| 6 | 动态调整 | 容量规划不是一次性的,需要持续调整 | 持续优化 |
| 7 | 多维度 | 容量规划需考虑带宽、连接数、队列深度等多维度 | 全面规划 |
| 8 | 业务差异 | 不同业务的流量特征差异巨大,需分别建模 | 业务建模 |
| 9 | 监控验证 | 部署后通过Telemetry验证实际流量与模型的一致性 | 验证 |
| 10 | 工具辅助 | 使用Python+NumPy/SciPy进行流量分析和建模 | 分析工具 |
思考
- Little定理在什么条件下成立?当流量不满足平稳性假设时,如何修正?
- 对于突发流量(如Flash Crowd),传统的基于历史数据的容量规划方法有何局限性?
- AI/ML能否用于流量预测和容量规划?相比传统统计方法有何优势?
下篇预告:第355篇:多云互联网络架构设计与实施