第347篇:Telemetry 发现现网隐藏拥塞点
关键词:Telemetry、gRPC、流式遥测、拥塞检测、华为iMaster NCE
一、案例背景
某省级运营商骨干网运行稳定,SNMP监控未告警,网管报表各项指标均正常。但部分客户投诉业务时延偶发增高(从5ms增至50ms),传统监控手段未能定位问题。引入Telemetry流式遥测后,发现了隐藏的拥塞点。
网络架构: - 骨干网:30台NE40E/NE8000 - 监控方式:SNMP(5分钟采集间隔)+ NetStream - 新增Telemetry:gRPC流式遥测(秒级采集) - 采集平台:iMaster NCE-IP
故障现象: 1. 部分客户业务时延周期性增高(每天上午9-11点) 2. 传统SNMP监控显示链路利用率正常(<60%) 3. NetStream未发现异常大流 4. Ping测试显示平均时延正常,但P99时延异常高
二、需求分析与方案设计
2.1 SNMP与Telemetry对比
| 维度 | SNMP | Telemetry |
|---|---|---|
| 采集频率 | 5-15分钟 | 秒级/亚秒级 |
| 数据采集 | 轮询(Polling) | 推送(Push) |
| 数据粒度 | 粗粒度(接口级) | 细粒度(队列/子接口级) |
| 数据格式 | MIB(ASN.1) | JSON/GPB(Protocol Buffers) |
| 传输协议 | SNMP over UDP | gRPC(HTTP/2 + TLS) |
| 设备开销 | 低 | 中(可配置) |
| 实时性 | 差 | 好 |
2.2 Telemetry架构
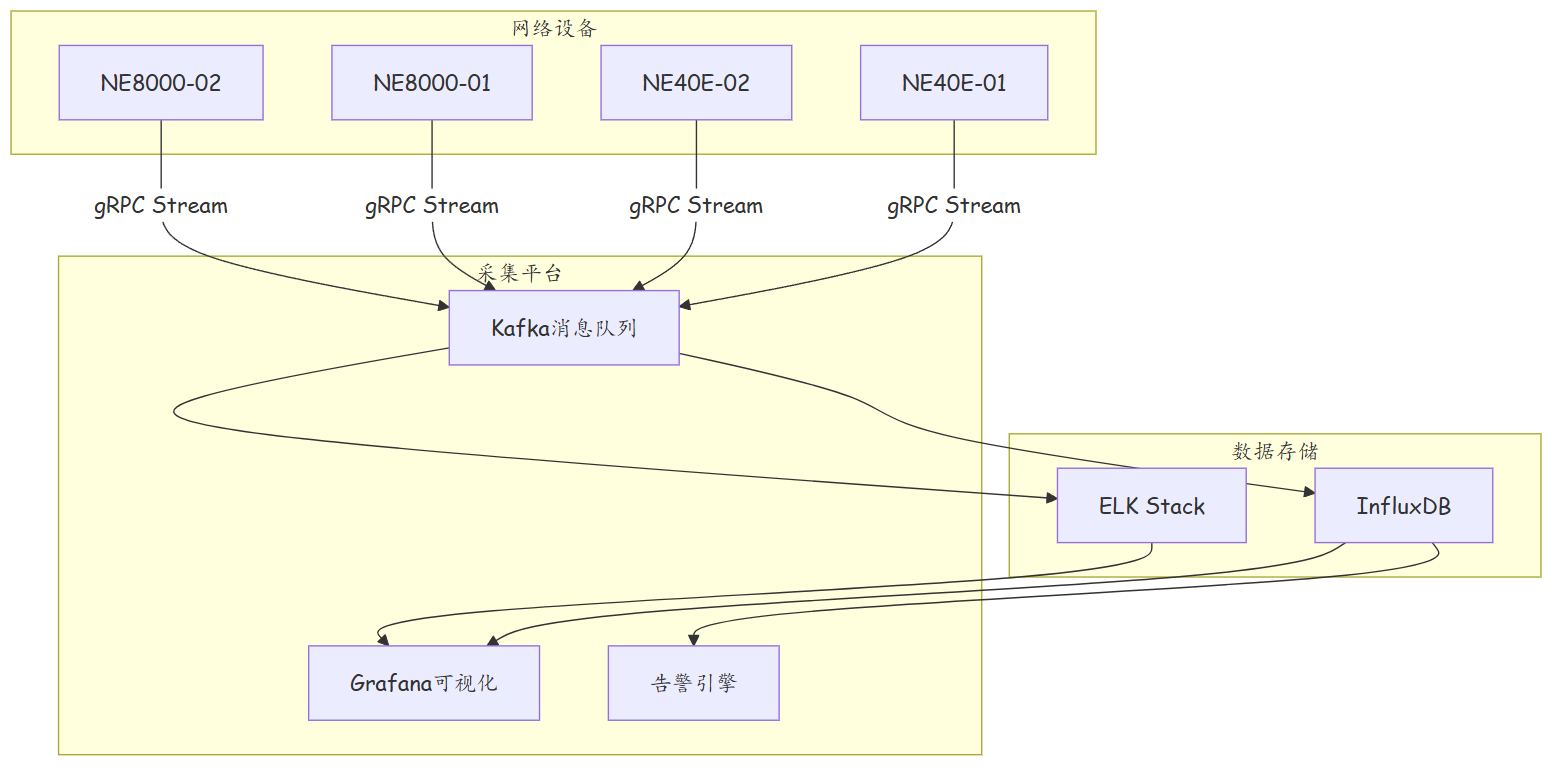
2.2.1 Telemetry工作原理
Telemetry的核心思想是由设备主动推送而非由网管被动轮询。工作流程如下:
1. 采集器(Collector)下发采集配置到设备
   - 采集路径(Yang Path)
   - 采集频率
   - 编码格式(JSON/gPB)
   - 传输方式(gRPC/DIPIR)

2. 设备内部定时采集指定数据
   - 直接从硬件寄存器或内存读取,无需CLI解析
   - 采集效率远高于CLI方式

3. 设备封装并推送数据到采集器
   - gPB编码压缩数据,节省带宽
   - gRPC Stream保持长连接,减少握手开销

4. 采集器接收、解码、存储数据
   - 高吞吐写入时序数据库(InfluxDB)
   - 实时流处理(Flink/Spark Streaming)

5. 可视化展示和告警分析
   - Grafana展示实时趋势
   - 规则引擎触发告警
2.3 采集模型设计
| 采集项 | 频率 | 路径 | 用途 |
|---|---|---|---|
| 接口利用率 | 1秒 | /ifentry/ifoperstat | 实时拥塞检测 |
| 队列深度 | 1秒 | /qos/queue | 队列级拥塞 |
| 时延统计 | 5秒 | /yang/telemetry | 端到端时延 |
| CPU/内存 | 30秒 | /entity/entity-sensors | 设备健康 |
| BGP状态 | 30秒 | /bgp-state | 路由状态 |
三、技术细节与实施过程
3.1 Telemetry配置
# NE40E Telemetry配置
<Huawei> system-view
[Huawei] sysname NE40E-01

# 配置gRPC源接口
[NE40E-01] telemetry
[NE40E-01-telemetry] grpc source-interface LoopBack 0
[NE40E-01-telemetry] grpc port 4321
[NE40E-01-telemetry] grpc ssl enable
[NE40E-01-telemetry] grpc ssl certificate telemetry cert
[NE40E-01-telemetry] grpc ssl cipher-suite HIGH:MEDIUM:!aNULL:!MD5
[NE40E-01-telemetry] quit

# 配置采集路径(Yang Path)
[NE40E-01] telemetry
[NE40E-01-telemetry] sensor-group IF_UTILIZATION
[NE40E-01-telemetry-sensor-IF_UTILIZATION] data-node /ifentry/ifoperstat/ifadminstatus
[NE40E-01-telemetry-sensor-IF_UTILIZATION] data-node /ifentry/ifoperstat/ifinucastpkts
[NE40E-01-telemetry-sensor-IF_UTILIZATION] data-node /ifentry/ifoperstat/ifoutucastpkts
[NE40E-01-telemetry-sensor-IF_UTILIZATION] data-node /ifentry/ifoperstat/ifinoctets
[NE40E-01-telemetry-sensor-IF_UTILIZATION] data-node /ifentry/ifoperstat/ifoutoctets
[NE40E-01-telemetry-sensor-IF_UTILIZATION] sampling-mode interval
[NE40E-01-telemetry-sensor-IF_UTILIZATION] sampling-interval 1000  # 1秒
[NE40E-01-telemetry-sensor-IF_UTILIZATION] filtering-mode no-filter
[NE40E-01-telemetry-sensor-IF_UTILIZATION] quit

# 配置队列级采集
[NE40E-01-telemetry] sensor-group QUEUE_STATS
[NE40E-01-telemetry-sensor-QUEUE_STATS] data-node /qos/queue/ifqstat/queue-depth
[NE40E-01-telemetry-sensor-QUEUE_STATS] data-node /qos/queue/ifqstat/queue-dropped
[NE40E-01-telemetry-sensor-QUEUE_STATS] sampling-interval 1000
[NE40E-01-telemetry-sensor-QUEUE_STATS] quit

# 配置订阅
[NE40E-01-telemetry] subscription SUBSCRIPTION_01
[NE40E-01-telemetry-subscription-SUBSCRIPTION_01] sensor-group IF_UTILIZATION
[NE40E-01-telemetry-subscription-SUBSCRIPTION_01] sensor-group QUEUE_STATS
[NE40E-01-telemetry-subscription-SUBSCRIPTION_01] destination address ipv4 10.0.0.100
[NE40E-01-telemetry-subscription-SUBSCRIPTION_01] destination protocol grpc
[NE40E-01-telemetry-subscription-SUBSCRIPTION_01] encoding-type gpB
[NE40E-01-telemetry-subscription-SUBSCRIPTION_01] heartbeat-interval 60000
[NE40E-01-telemetry-subscription-SUBSCRIPTION_01] quit
[NE40E-01-telemetry] quit
3.2 隐藏拥塞点发现
# Telemetry数据分析
# 发现NE40E-02的某个队列在上午9-11点深度周期性增高

Time          Interface    Queue    Depth     Drop    Utilization
09:00:01      100GE1/0/1   3        15234     0       72%
09:00:02      100GE1/0/1   3        45678     0       78%  <-- 队列深度突增
09:00:03      100GE1/0/1   3        89012     1234    85%  <-- 开始丢包
09:00:04      100GE1/0/1   3        120000    5678    90%
09:00:05      100GE1/0/1   3        95000     2345    82%
# ... 周期性波动
发现: 1. 接口总利用率72%(SNMP显示正常),但Queue 3的深度在高峰期达到120KB 2. Queue 3对应的是BGP流量优先级(CS6) 3. SNMP 5分钟粒度的采集完全无法发现这种秒级波动
3.3 根因定位
通过Telemetry的细粒度数据交叉分析:
- Queue 3对应BGP流量(DSCP CS6)
- 上午9-11点是BGP路由振荡的高峰期(部分对端网络维护窗口)
- BGP更新报文突发导致Queue 3瞬间拥塞
- 队列深度超过阈值后开始尾丢包(Tail Drop),导致TCP重传和时延增加
3.4 数据量与性能评估
部署Telemetry前必须评估数据量和设备性能影响:
数据量估算公式:
| 参数 | 值 | 计算 |
|---|---|---|
| 设备数 | 30台 | - |
| 每台设备采集路径数 | ~100个 | 接口统计+队列+CPU+内存+BGP |
| 每条路径每次数据大小 | ~500 bytes(gPB编码) | JSON约1500 bytes |
| 采集频率 | 1秒 | - |
| 每秒单设备数据量 | ~50 KB/s | 100 × 500 bytes |
| 每日单设备数据量 | ~4.3 GB | 50 KB × 86400 |
| 每日总数据量 | ~129 GB | 30 × 4.3 GB |
| 带宽占用(每设备) | ~400 Kbps | 50 KB × 8 |
设备CPU开销评估:
# 查看Telemetry相关的CPU使用
<Huawei> display telemetry cpu-usage
Telemetry CPU Usage:
  Sensor Group: IF_UTILIZATION
    CPU Usage: 3.2%       # 接口统计采集
    Memory Usage: 12 MB

  Sensor Group: QUEUE_STATS
    CPU Usage: 1.8%       # 队列统计采集
    Memory Usage: 8 MB

  Total Telemetry CPU: 5.0%   # 总开销在可接受范围内
  Total Telemetry Memory: 20 MB
3.5 跨设备关联分析
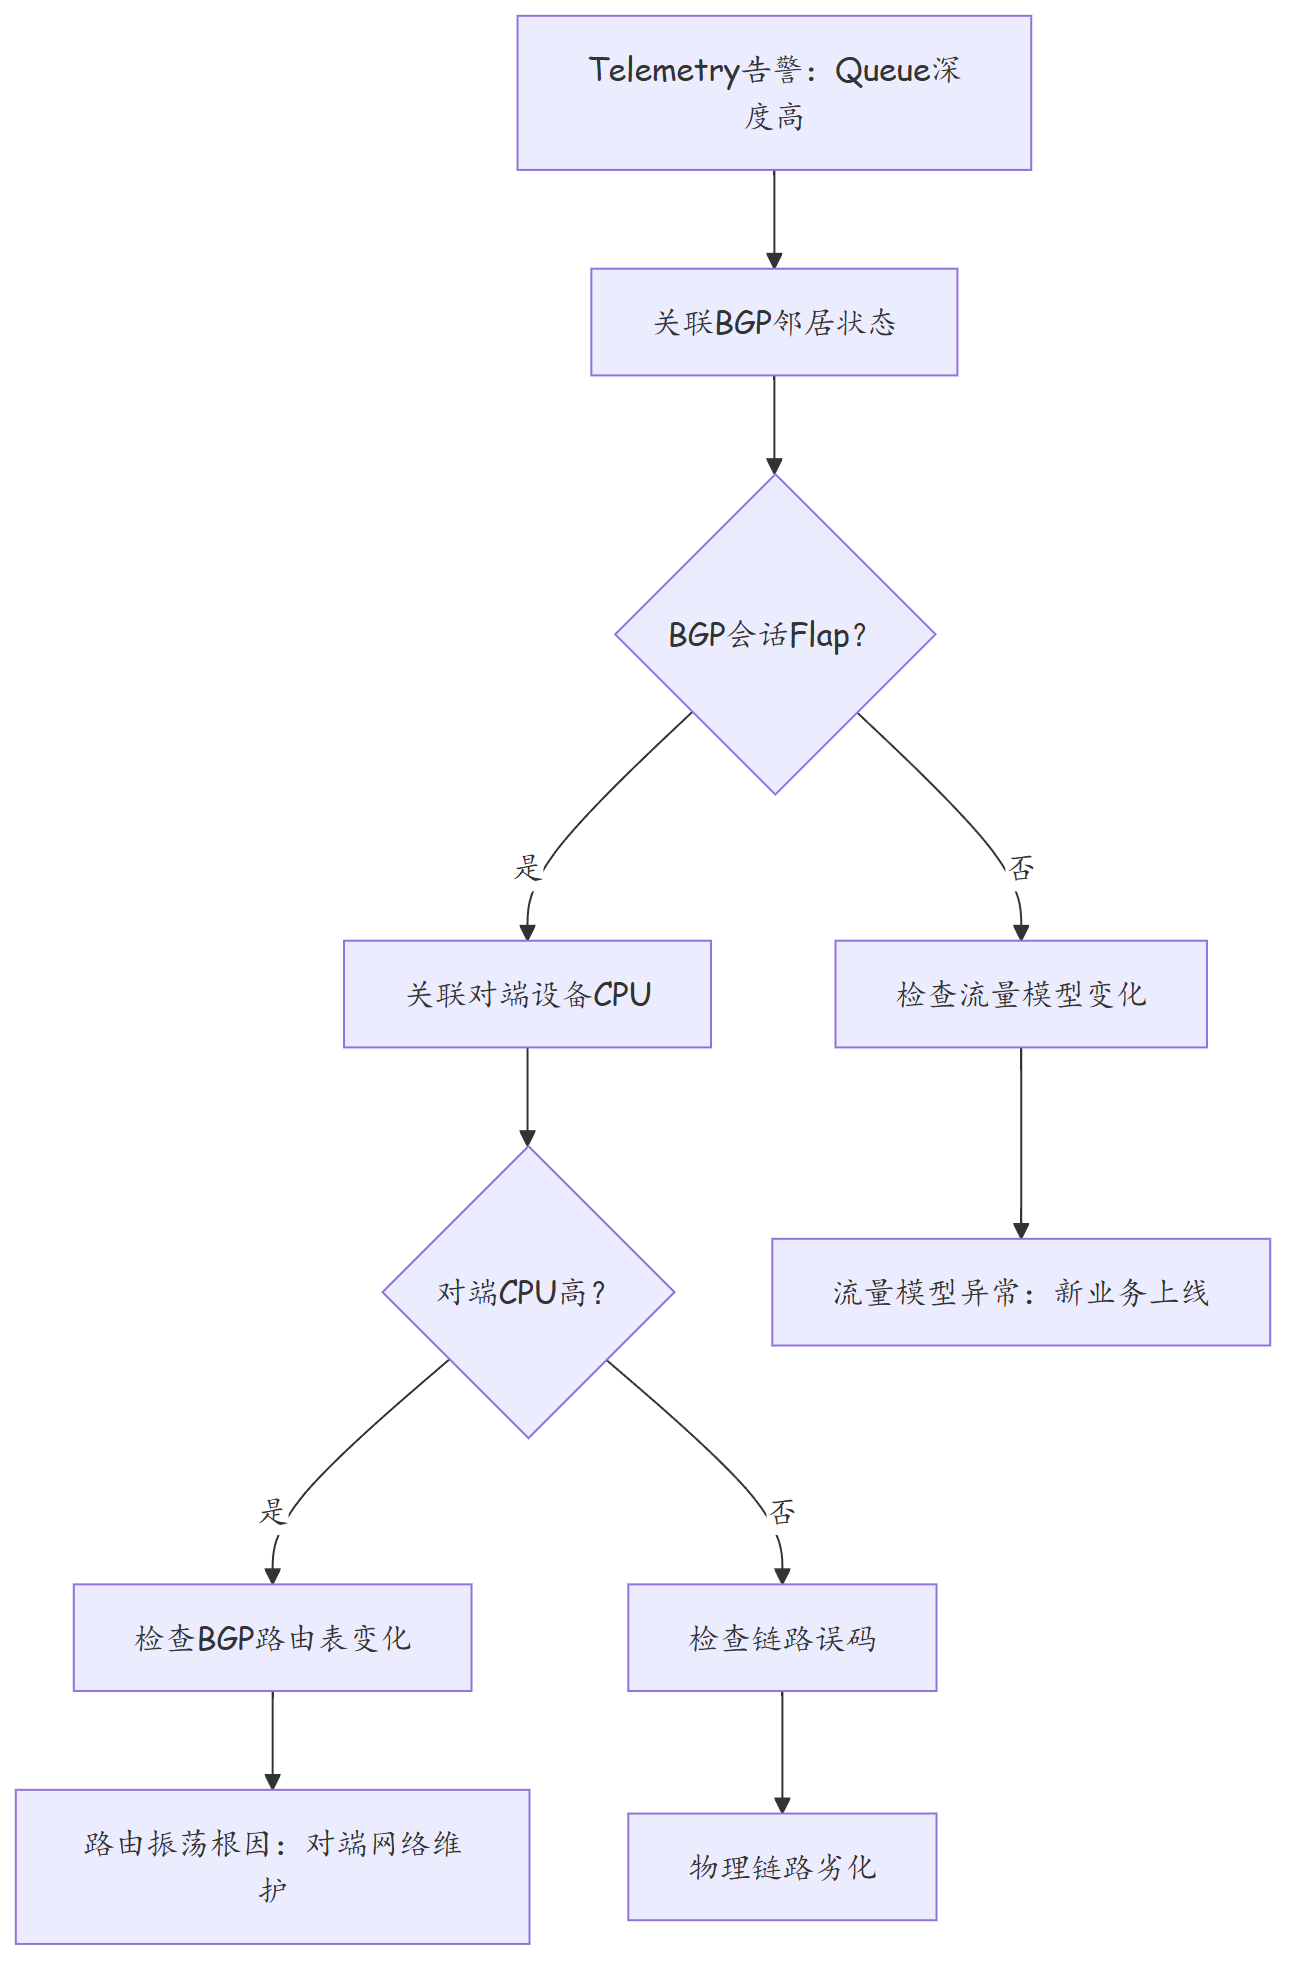
Telemetry的真正价值在于跨设备的关联分析。下面的分析发现了隐藏在单个设备数据背后的全局问题:
分析步骤1:发现NE40E-02的Queue 3深度周期性增高
    ↓
分析步骤2:查看NE40E-02的BGP邻居状态
    - 发现NE40E-02与对端NE8000-03的BGP会话在9-11点频繁Flap
    ↓
分析步骤3:查看NE8000-03的Telemetry数据
    - NE8000-03的CPU在9-11点达到85%(平时40%)
    - BGP进程CPU占用异常高
    ↓
分析步骤4:查看NE8000-03的BGP路由表变化
    - 9:00-11:00期间,BGP路由表变化次数达5000+次
    - 大量Prefix Withdraw和Re-advertise
    ↓
根因确认:对端网络维护导致BGP大规模振荡,引发Queue拥塞
Telemetry关联分析流程图:
四、实战配置/案例分析
4.1 解决方案
# 方案1:增大Queue 3的队列深度
[NE40E-02] interface 100GE 1/0/1
[NE40E-02-100GE1/0/1] qos queue 3 length 200000  # 队列深度从100000增至200000
[NE40E-02-100GE1/0/1] quit

# 方案2:配置WRED(加权随机早期检测)替代Tail Drop
[NE40E-02-100GE1/0/1] qos queue 3 wred enable
[NE40E-02-100GE1/0/1] qos queue 3 wred cs6 min-threshold 60 max-threshold 90
[NE40E-02-100GE1/0/1] qos queue 3 wred cs6 drop-probability 20
[NE40E-02-100GE1/0/1] quit

# 方案3:配置GTS(流量整形)平滑BGP流量
[NE40E-02] traffic classifier BGP_TRAFFIC
[NE40E-02-classifier-BGP_TRAFFIC] if-match dscp cs6
[NE40E-02-classifier-BGP_TRAFFIC] quit

[NE40E-02] traffic behavior BGP_SHAPING
[NE40E-02-behavior-BGP_SHAPING] car cir 1000000  # 整形为1Gbps
[NE40E-02-behavior-BGP_SHAPING] queue wfq weight 5
[NE40E-02-behavior-BGP_SHAPING] quit

[NE40E-02] traffic policy BGP_POLICY
[NE40E-02-policy-BGP_POLICY] classifier BGP_TRAFFIC behavior BGP_SHAPING
[NE40E-02-policy-BGP_POLICY] quit

[NE40E-02] interface 100GE 1/0/1
[NE40E-02-100GE1/0/1] traffic-policy BGP_POLICY outbound
[NE40E-02-100GE1/0/1] quit
4.2 Telemetry告警配置
# 在iMaster NCE上配置Telemetry告警规则
# 告警规则:队列深度超过阈值

{
  "alarm_rule": {
    "name": "Queue Depth High",
    "condition": "queue_depth > 80000",
    "severity": "Major",
    "duration": "5s",  # 持续5秒超过阈值才告警
    "notify": ["email", "sms"],
    "auto_recover": true
  }
}
4.3 Grafana Dashboard设计
Telemetry数据的核心价值需要通过可视化直观呈现。以下是一个典型的Grafana Dashboard面板设计:
{
  "dashboard": {
    "title": "骨干网Telemetry实时监控",
    "panels": [
      {
        "title": "接口利用率热力图",
        "type": "heatmap",
        "datasource": "InfluxDB",
        "targets": [{
          "query": "select mean(utilization) from interface_stats group by time(1m), device, interface fill(linear)"
        }],
        "description": "展示所有核心接口5分钟级别的利用率热力图,快速定位拥塞点"
      },
      {
        "title": "队列深度时序图",
        "type": "timeseries",
        "datasource": "InfluxDB",
        "targets": [{
          "query": "select queue_depth from queue_stats where device='$device' and interface='$interface' group by time(1s)"
        }],
        "description": "秒级队列深度监控,发现瞬时拥塞"
      },
      {
        "title": "端到端时延分布",
        "type": "histogram",
        "datasource": "InfluxDB",
        "targets": [{
          "query": "select latency from end_to_end_stats where time > now() - 1h"
        }],
        "description": "展示最近1小时的时延分布,P99时延超过50ms标红"
      },
      {
        "title": "BGP路由变化率",
        "type": "gauge",
        "datasource": "InfluxDB",
        "targets": [{
          "query": "select count(route_changes) from bgp_stats where time > now() - 5m"
        }],
        "description": "5分钟内BGP路由变化次数,超过100次告警"
      }
    ]
  }
}
4.4 数据存储与保留策略
Telemetry数据量大,必须有合理的数据保留策略:
| 数据粒度 | 保留时间 | 存储类型 | 用途 |
|---|---|---|---|
| 原始秒级数据 | 7天 | SSD(热存储) | 实时排查 |
| 1分钟聚合 | 30天 | HDD(温存储) | 趋势分析 |
| 1小时聚合 | 1年 | 对象存储(冷存储) | 容量规划 |
| 统计摘要 | 永久 | 关系数据库 | KPI报表 |
-- InfluxDB连续查询(自动聚合)
CREATE CONTINUOUS QUERY cq_1min ON telemetry_db
BEGIN
  SELECT mean(utilization) AS utilization_mean,
         max(utilization) AS utilization_max
  INTO telemetry_db.autogen.interface_1min
  FROM telemetry_db.autogen.interface_stats
  GROUP BY time(1m), device, interface
END

CREATE CONTINUOUS QUERY cq_1hour ON telemetry_db
BEGIN
  SELECT mean(utilization_mean) AS utilization_avg
  INTO telemetry_db.autogen.interface_1hour
  FROM telemetry_db.autogen.interface_1min
  GROUP BY time(1h), device, interface
END
4.5 Telemetry数据量优化方案
| 优化方法 | 节省比例 | 实现方式 |
|---|---|---|
| gPB编码替代JSON | 60-70% | 编码类型从json改为gpB |
| 阈值触发上报 | 50-80% | 仅在数据变化超过阈值时上报 |
| 动态采集频率 | 30-50% | 空闲时段降低采集频率 |
| 数据采样 | 50% | 非关键数据每N秒采样一次 |
| 流式压缩 | 40-60% | gRPC层启用gzip压缩 |
4.3 优化效果
| 指标 | SNMP监控 | Telemetry监控 | 改善 |
|---|---|---|---|
| 采集频率 | 5分钟 | 1秒 | ×300 |
| 拥塞发现时间 | 5-15分钟 | <1秒 | 提前100倍 |
| 数据粒度 | 接口级 | 队列级 | 更细 |
| 隐藏拥塞发现 | 0 | 3处 | 新发现 |
| 时延异常定位 | 无法定位 | 30分钟内 | 大幅提升 |
五、经验总结
| 序号 | 经验类别 | 经验内容 | 适用场景 |
|---|---|---|---|
| 1 | 监控升级 | SNMP无法发现秒级拥塞,Telemetry是必选项 | 监控架构 |
| 2 | 采集频率 | 关键接口1秒采集,一般接口5-10秒采集 | 采集策略 |
| 3 | 数据粒度 | 队列级数据比接口级数据更有诊断价值 | 数据采集 |
| 4 | 编码格式 | gPB编码比JSON节省70%带宽 | 传输优化 |
| 5 | 安全传输 | gRPC必须启用TLS加密 | 安全要求 |
| 6 | 设备开销 | Telemetry增加设备5-10%CPU,需评估容量 | 容量评估 |
| 7 | 告警规则 | Telemetry告警必须设置持续时间阈值,避免抖动告警 | 告警优化 |
| 8 | 数据量管理 | 秒级采集数据量大,必须有有效的数据压缩和存储策略 | 数据管理 |
| 9 | 可视化 | Grafana是Telemetry数据可视化的最佳工具 | 可视化工具 |
| 10 | 渐进部署 | 先在核心设备部署Telemetry,逐步扩展 | 部署策略 |
思考
- Telemetry秒级采集产生的数据量非常庞大(一台设备约100MB/天),如何设计数据存储和查询方案?
- gRPC和DIPIR(Direct IP Interface Reporter)两种Telemetry传输方式相比,各有什么优缺点?
- 如果网络设备不支持Telemetry,是否可以通过NetStream+Flow数据间接推断拥塞情况?
下篇预告:第348篇:全网 IP 地址梳理与重规划项目