第301篇:网络运维自动化的 Why 与 How
关键词:网络自动化、运维转型、DevOps、ITIL、自动化框架、网络工程
一、引言
承接第300篇对AI时代数据中心趋势的探讨,我们看到了数据中心正从传统"烟囱式"架构向云原生、智能化方向演进。然而,再先进的硬件与算法,若缺乏高效的运维体系支撑,也无法释放其真正的价值。当网络设备规模从几十台膨胀到数千台、配置项从数百条增长到数万条时,手工运维的"人海战术"已彻底失灵。
本篇作为第七篇章"自动化运维与编程"的开篇,将系统阐述网络运维自动化的驱动力、演进路径和实施方法学,为后续Python、Ansible、YANG等工具的学习奠定认知基础。
二、为什么需要网络运维自动化
2.1 规模爆炸带来的运维瓶颈
现代数据中心与广域网的规模增长远超人力可扩展的上限:
| 指标 | 2015年 | 2025年 | 增长倍数 |
|---|---|---|---|
| 单客户平均设备数 | ~200台 | ~2000台 | 10x |
| 单次变更涉及的配置行数 | ~50行 | ~500行 | 10x |
| 周均变更请求数 | ~15次 | ~120次 | 8x |
| MTTR(平均故障恢复时间) | ~4小时 | ~30分钟 | 8x改善 |
传统运维模式下,每次配置变更需要经历审批、手工操作、逐项验证等流程,耗时冗长且易出错。
2.2 人为错误是事故主因
据Gartner统计,超过70%的网络故障由人为配置错误引起:
- 误删接口IP地址:管理员在telnet窗口中误敲命令,导致整条链路中断
- ACL规则冲突:新增安全策略时未审查已有规则,阻断正常业务流量
- BGP路由泄露:配置导出策略时遗漏filter,将内部路由发布至对等体
- 配置漂移:多管理员并行修改同一设备,产生不可预知的叠加效应
2.3 业务连续性与合规要求
金融、电信等强监管行业要求:
- 每次变更可追溯、可审计
- 配置变更需在分钟级完成回滚
- 定期自动化合规扫描,确保设备配置符合安全基线
2.4 自动化投资回报(ROI)分析
网络自动化不是成本,而是投资。以下是某企业实施自动化6个月后的真实ROI数据:
| 指标 | 自动化前 | 自动化后 | 改善幅度 |
|---|---|---|---|
| 人均管理设备数 | 50台 | 300台 | 6x |
| 单次变更耗时 | 45分钟 | 3分钟 | 15x |
| 配置错误率 | 3.2% | 0.1% | 32x |
| 故障恢复时间(MTTR) | 2.5小时 | 15分钟 | 10x |
| 合规检查周期 | 每月1次(3人天) | 实时 | 持续 |
| 新人上手时间 | 3个月 | 2周 | 6x |
ROI 计算示例:假设运维团队10人,人均年薪30万,自动化提升效率60%:
# 自动化 ROI 计算
def calculate_roi():
    team_size = 10          # 运维团队人数
    avg_salary = 300000     # 人均年薪
    efficiency_gain = 0.6   # 效率提升 60%
    automation_cost = 500000  # 工具+培训+实施成本

    annual_saving = team_size * avg_salary * efficiency_gain
    roi = (annual_saving - automation_cost) / automation_cost * 100

    return {
        "annual_saving": annual_saving,   # 180万/年
        "roi": roi,                       # 260%
        "payback_months": automation_cost / (annual_saving / 12)  # 3.3个月
    }

result = calculate_roi()
print(f"年化节省: {result['annual_saving']/10000:.0f}万")
print(f"ROI: {result['roi']:.0f}%")
print(f"回本周期: {result['payback_months']:.1f}个月")
2.5 自动化接口协议对比
不同的设备访问协议决定了自动化的能力和效率:
| 协议 | 数据传输 | 结构化 | 实时性 | 设备支持 | 适用场景 |
|---|---|---|---|---|---|
| SSH (CLI) | 文本 | ❌ 需正则解析 | 轮询 | 全厂商 | 通用兼容,初级自动化 |
| NETCONF | XML | ✅ YANG模型 | 回调通知 | 主流厂商 | 配置管理,中级自动化 |
| RESTCONF | JSON | ✅ YANG模型 | 回调通知 | 主流厂商 | 与业务系统集成 |
| gNMI | Protobuf | ✅ 二进制高效 | 流式推送 | 新兴厂商 | 高性能采集,高级自动化 |
| SNMP | ASN.1 | 部分 | Trap/轮询 | 全厂商 | 监控告警,轻量查询 |
# 三种协议获取接口状态的代码对比

# 方式1: SSH CLI(文本解析)
import netmiko
device = netmiko.ConnectHandler(**device_params)
output = device.send_command("display interface brief")
# 需要用正则解析文本...
import re
for line in output.split('\n'):
    match = re.match(r'(\S+)\s+(\S+)\s+(\S+)\s+(\w+)', line)
    if match:
        print(f"接口: {match.group(1)}, 状态: {match.group(4)}")

# 方式2: NETCONF(结构化XML)
from ncclient import manager
with manager.connect(host='10.0.0.1', port=830, username='admin',
                     password='secret', hostkey_verify=False) as m:
    filter_xml = '''
    <filter>
        <interfaces xmlns="urn:ietf:params:xml:ns:yang:ietf-interfaces">
            <interface/>
        </interfaces>
    </filter>
    '''
    result = m.get_config('running', filter_xml)
    # 直接解析XML为结构化数据

# 方式3: gNMI(流式推送,Python + gNMI客户端)
# from gnmi_tools.gnmi_path import gnmi_path
# from gnmi_tools.client import gNMIClient
# client = gNMIClient(address='10.0.0.1:9339', username='admin',
#                      password='secret', overlay='tcp')
# paths = ['/interfaces/interface/state/oper-status']
# for response in client.subscribe(paths, mode='STREAM'):
#     print(response)  # 实时推送,无需轮询
三、网络自动化演进路线
3.1 五个成熟度阶段
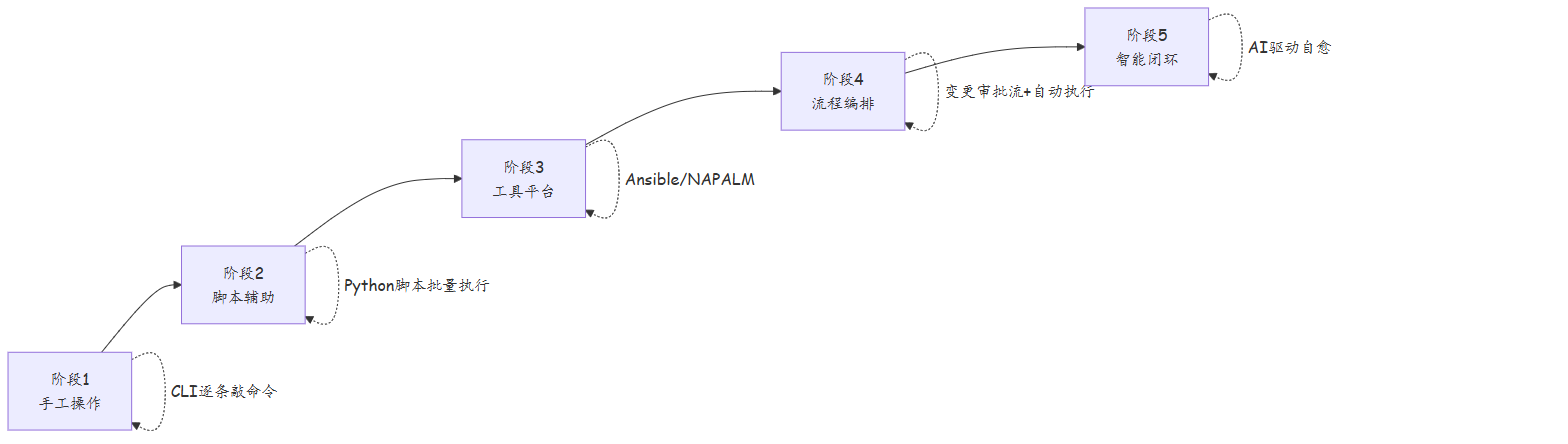
阶段1:手工操作 - 通过Console或SSH逐台登录设备,逐条输入CLI命令 - 典型工具:PuTTY、SecureCRT、CRT会话管理器
阶段2:脚本辅助
- 编写Shell/Python脚本,通过SSH批量下发命令
- 典型案例:用Expect脚本自动登录交换机执行display version
- 局限:缺乏错误处理、不可复用、无幂等性保证
阶段3:工具平台 - 引入Netmiko、NAPALM、Ansible等标准化框架 - 实现设备抽象、连接管理、配置模板化 - 关键能力:幂等性执行、结果验证、日志审计
阶段4:流程编排 - 将自动化脚本嵌入变更管理流程(ITIL Change Management) - 通过Jenkins CI/CD流水线实现配置即代码(Configuration as Code) - 支持灰度发布、金丝雀发布、自动回滚
阶段5:智能闭环 - 结合Telemetry流式数据与AI推理引擎 - 自动检测异常、定位根因、生成修复策略并自动执行 - 代表方向:AIOps、数字孪生网络
3.2 自动化覆盖域
网络自动化并非单一技术点,而是一个覆盖全生命周期的体系:
| 运维域 | 自动化场景 | 典型工具 |
|---|---|---|
| 配置管理 | 批量部署、基线对比、配置备份 | Ansible、Napalm、Oxidized |
| 监控告警 | 指标采集、异常检测、告警关联 | Prometheus、Telegraf、ELK |
| 故障自愈 | 链路down自动切换、BFD检测 | BGP Graceful Restart、ERPS |
| 变更管理 | 审批流程、变更窗口、回滚策略 | Jenkins、GitLab CI/CD |
| 文档生成 | 拓扑图生成、资产清单导出 | NetBox、Nautobot |
四、最小可行自动化系统(MVA)快速启动
4.1 第一周:构建自动化脚手架
在开始任何复杂的自动化之前,先搭建一个最小可用的自动化框架:
#!/usr/bin/env python3
"""
automation_bootstrap.py - 最小可行自动化系统
第一周即可完成的自动化基础框架
"""
import yaml
import logging
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor, as_completed
import netmiko
import paramiko
import json
from datetime import datetime

# ===================== 配置加载 =====================

def load_inventory(inventory_file='inventory.yaml'):
    """加载设备清单"""
    with open(inventory_file) as f:
        return yaml.safe_load(f)

# inventory.yaml 示例:
# devices:
#   - name: Core-SW01
#     host: 10.0.1.1
#     username: admin
#     password: secret
#     device_type: huawei_vrpv8
#     role: core
#   - name: Access-SW01
#     host: 10.0.2.1
#     ...

# ===================== 连接管理 =====================

def connect_device(device_info, timeout=30):
    """安全连接设备,带重试"""
    max_retries = 3
    for attempt in range(max_retries):
        try:
            connection = netmiko.ConnectHandler(
                host=device_info['host'],
                username=device_info['username'],
                password=device_info['password'],
                device_type=device_info['device_type'],
                timeout=timeout
            )
            return connection
        except (paramiko.ssh_exception.SSHException, netmiko.NetmikoTimeoutException) as e:
            logging.warning(
                f"连接 {device_info['name']} 失败 "
                f"(尝试 {attempt+1}/{max_retries}): {e}"
            )
            if attempt == max_retries - 1:
                raise

# ===================== 配置采集 =====================

def collect_config(device_info, output_dir='backups'):
    """采集并备份运行配置"""
    Path(output_dir).mkdir(exist_ok=True)
    connection = connect_device(device_info)
    try:
        config = connection.send_command("display current-configuration")
        timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
        filename = f"{output_dir}/{device_info['name']}_{timestamp}.txt"
        with open(filename, 'w', encoding='utf-8') as f:
            f.write(config)
        # 同时保存最新快照
        latest = f"{output_dir}/{device_info['name']}_latest.txt"
        with open(latest, 'w', encoding='utf-8') as f:
            f.write(config)
        logging.info(f"✓ {device_info['name']} 配置已备份 ({len(config)} 字节)")
        return config
    finally:
        connection.disconnect()

def collect_device_info(device_info):
    """采集设备基础信息"""
    connection = connect_device(device_info)
    try:
        info = {
            'name': device_info['name'],
            'version': connection.send_command("display version"),
            'uptime': connection.send_command("display uptime"),
            'cpu': connection.send_command("display cpu-usage"),
            'memory': connection.send_command("display memory-usage"),
        }
        return info
    finally:
        connection.disconnect()

# ===================== 并行执行 =====================

def parallel_collect(devices, task='config', max_workers=5):
    """并行采集多设备数据"""
    results = {}
    errors = {}

    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        future_map = {}
        for device in devices:
            if task == 'config':
                future = executor.submit(collect_config, device)
            else:
                future = executor.submit(collect_device_info, device)
            future_map[future] = device['name']

        for future in as_completed(future_map):
            name = future_map[future]
            try:
                results[name] = future.result()
            except Exception as e:
                errors[name] = str(e)
                logging.error(f"✗ {name}: {e}")

    return results, errors

# ===================== 报告生成 =====================

def generate_backup_report(results, errors):
    """生成备份报告"""
    total = len(results) + len(errors)
    report = {
        'timestamp': datetime.now().isoformat(),
        'total_devices': total,
        'success': len(results),
        'failed': len(errors),
        'success_rate': f"{len(results)/total*100:.1f}%" if total else "N/A",
        'failed_devices': list(errors.keys()),
        'backed_up_configs': list(results.keys())
    }

    # 打印报告
    print("\n" + "=" * 50)
    print("配置备份报告")
    print("=" * 50)
    print(f"设备总数: {total}")
    print(f"成功: {len(results)} ({report['success_rate']})")
    print(f"失败: {len(errors)}")
    if errors:
        print(f"失败设备: {', '.join(errors.keys())}")
    print("=" * 50)

    return report

# ===================== 主流程 =====================

if __name__ == '__main__':
    logging.basicConfig(level=logging.INFO,
                       format='%(asctime)s %(levelname)s %(message)s')

    inventory = load_inventory()
    devices = inventory['devices']

    print(f"开始采集 {len(devices)} 台设备...")

    # 采集配置
    configs, errors = parallel_collect(devices, task='config')
    report = generate_backup_report(configs, errors)

    # 保存报告
    with open('backup_report.json', 'w', encoding='utf-8') as f:
        json.dump(report, f, indent=2, ensure_ascii=False)
4.2 第二周:自动化巡检
在第一周采集脚本基础上,添加健康检查能力:
def health_check(device_info):
    """单设备健康检查"""
    connection = connect_device(device_info)
    try:
        checks = {}

        # 1. CPU 检查
        cpu_output = connection.send_command("display cpu-usage")
        cpu_match = re.search(r'CPU Usage Rate:\s*(\d+)%', cpu_output)
        if cpu_match:
            cpu = int(cpu_match.group(1))
            checks['cpu'] = {'value': cpu, 'status': 'warning' if cpu > 80 else 'ok'}

        # 2. 内存检查
        mem_output = connection.send_command("display memory-usage")
        mem_match = re.search(r'Memory Usage:\s*(\d+)%', mem_output)
        if mem_match:
            mem = int(mem_match.group(1))
            checks['memory'] = {'value': mem, 'status': 'warning' if mem > 85 else 'ok'}

        # 3. 接口 Down 检查
        iface_output = connection.send_command("display interface brief")
        down_interfaces = []
        for line in iface_output.split('\n'):
            if 'down' in line.lower() and 'protocol' in line.lower():
                iface_name = line.split()[0]
                down_interfaces.append(iface_name)
        checks['down_interfaces'] = {
            'count': len(down_interfaces),
            'interfaces': down_interfaces,
            'status': 'warning' if down_interfaces else 'ok'
        }

        # 4. BGP 会话检查
        bgp_output = connection.send_command("display bgp peer")
        bgp_match = re.search(r'Number of Peers:\s*(\d+)', bgp_output)
        established = re.search(r'Established:\s*(\d+)', bgp_output)
        checks['bgp'] = {
            'total': int(bgp_match.group(1)) if bgp_match else 0,
            'established': int(established.group(1)) if established else 0,
            'status': 'warning' if (bgp_match and established and
                     int(bgp_match.group(1)) > int(established.group(1))) else 'ok'
        }

        return checks

    finally:
        connection.disconnect()
五、构建自动化能力的核心方法学
5.1 配置即代码(Configuration as Code)
将网络配置视为软件代码,纳入版本控制与代码审查流程:
Git仓库结构示例:

- devices/
  - core-switch-01.j2      # Jinja2配置模板
  - access-switch-01.j2
  - router-01.j2
- inventory/
  - group_vars/
    - core.yml            # 核心交换机变量
    - access.yml          # 接入交换机变量
  - hosts.yml               # 设备清单
- playbooks/
  - deploy_core.yml         # 核心交换机部署
  - backup_all.yml          # 全量备份
- README.md
核心原则: - 所有配置变更通过代码提交记录 - 使用Pull Request进行同行评审(Peer Review) - 配置模板参数化,避免硬编码
5.2 幂等性设计
幂等性是自动化可靠执行的基石——无论执行一次还是十次,结果应当一致。
# 非幂等示例:每次运行都追加一条命令,导致重复
device.send_command("vlan 100")           # 重复执行会报错或产生副效应

# 幂等示例:先检查,再决策
desired_config = "vlan 100\n name SERVER_VLAN"
running_config = device.get_config()

if "vlan 100" not in running_config:
    device.send_config_set(desired_config)
    logging.info("VLAN 100已创建")
else:
    logging.info("VLAN 100已存在,跳过")
5.3 最小权限与安全原则
自动化系统的权限控制策略:
| 原则 | 说明 | 实践 |
|---|---|---|
| 最小权限 | 自动化账号仅授予完成任务所需权限 | 使用只读账号采集配置,使用特权账号下发变更 |
| 凭证管理 | 禁止明文存储密码 | 使用HashiCorp Vault、Ansible Vault加密 |
| 操作审计 | 每次自动操作留痕 | 写入审计日志,关联Git Commit ID |
| 变更窗口 | 非紧急变更在维护窗口执行 | 结合日历API判断当前是否处于变更窗口 |
5.4 故障案例:自动化回滚机制缺失导致全网中断
背景:某金融企业使用Python脚本批量配置BGP路由策略。
经过:
1. 运维工程师编写脚本,通过SSH连接到30台PE设备
2. 脚本中BGP export policy的deny规则优先级配置错误
3. 脚本依次下发,前5台设备配置生效时,核心互联路由被丢弃
4. 由于未设计回滚机制,工程师需手动逐台修改
5. 业务中断历时2小时15分
复盘教训: - 缺少预检查(Dry Run)步骤 - 未采用分批次灰度发布策略 - 未保留变更前快照,回滚耗时过长 - 无实时监控联动,未能第一时间感知异常
改进方案:
1. 变更前自动备份运行配置到Git仓库
2. 先在一台测试设备上验证配置效果
3. 使用Ansible的check_mode进行模拟执行
4. 与Prometheus监控联动,配置下发后实时检查BGP会话状态
5. 异常时自动触发回滚Playbook
六、团队能力培养与组织变革
自动化不仅是技术转型,更是组织能力的重构。技术工具只是冰山一角,真正决定成败的是人员和流程。
6.1 角色转变
| 传统角色 | 自动化后角色 | 新增技能要求 |
|---|---|---|
| 网络运维工程师 | 网络开发运维工程师 (NetDevOps) | Python编程、Git版本管理 |
| 配置管理员 | 自动化框架维护者 | Jinja2模板、Ansible Playbook |
| 故障处理工程师 | 自动化系统诊断专家 | 日志分析、API调试、脚本开发 |
| 架构设计师 | 自动化方案设计者 | 流程建模、CI/CD设计 |
6.2 培训计划设计
初级(0-3个月): - Python 基础语法、文件操作、正则表达式 - 使用 Paramiko/Netmiko 连接设备、执行命令 - Git 基本操作(clone、commit、push、pull)
中级(3-6个月): - Jinja2 模板引擎、YAML 数据格式 - Ansible Playbook 编写、角色开发 - 配置审计、合规检查脚本开发
高级(6-12个月): - NETCONF/RESTCONF/gNMI 协议编程 - CI/CD 流水线设计与维护 - 自动化框架架构设计、性能优化
6.3 组织保障
- 设立自动化专项小组:从各团队抽调骨干,专职负责自动化工具开发
- 建立自动化考核指标:将自动化覆盖率纳入KPI考核
- 鼓励技术创新:设立"自动化创新奖",奖励优秀自动化案例
- 知识沉淀:定期举办技术分享会,将优秀脚本和模板沉淀为共享资产
七、总结
| 维度 | 要点 |
|---|---|
| 核心驱动力 | 设备规模膨胀、人为错误频发、业务连续性要求 |
| 演进路线 | 手工→脚本→工具→编排→智能闭环,分阶段推进 |
| 方法学 | 配置即代码、幂等性设计、最小权限、变更审计 |
| 工具链 | Python生态(Paramiko/Netmiko/NAPALM)、Ansible、CI/CD |
| 避坑指南 | 必须设计回滚机制、必须做Dry Run、必须灰度发布 |
思考题
- 你的当前网络环境中,哪些运维任务最适合优先自动化?请按"收益/难度"矩阵进行评估。
- 如果领导要求"三个月内实现80%配置变更自动化",你将如何制定分阶段实施计划?
- 幂等性为何是自动化设计的核心原则?如果脚本不具备幂等性,可能引发哪些具体风险?
下篇预告
第302篇:Python 基础——网络工程师的第一行代码。从变量、循环、函数到网络模块,迈出编程之路的第一步。