第270篇:NVMe over RoCEv2 部署案例
关键词:NVMe-oF、RoCEv2、部署架构、华为存储、昇腾AI集群、性能验证
一、引言
NVMe over RoCEv2结合了NVMe协议的高并发低延迟特性和RoCEv2 RDMA的零拷贝传输能力,是当前AI训练、高性能计算等场景下的最优存储网络方案。
然而,NVMe over RoCEv2的部署涉及计算节点、存储节点和网络设备的协同配置,任何一个环节的疏漏都可能导致性能下降甚至连接失败。本文通过一个真实的昇腾AI集群部署案例,详细介绍NVMe over RoCEv2的完整部署流程。
二、核心概念
2.1 部署架构
典型NVMe over RoCEv2组网:
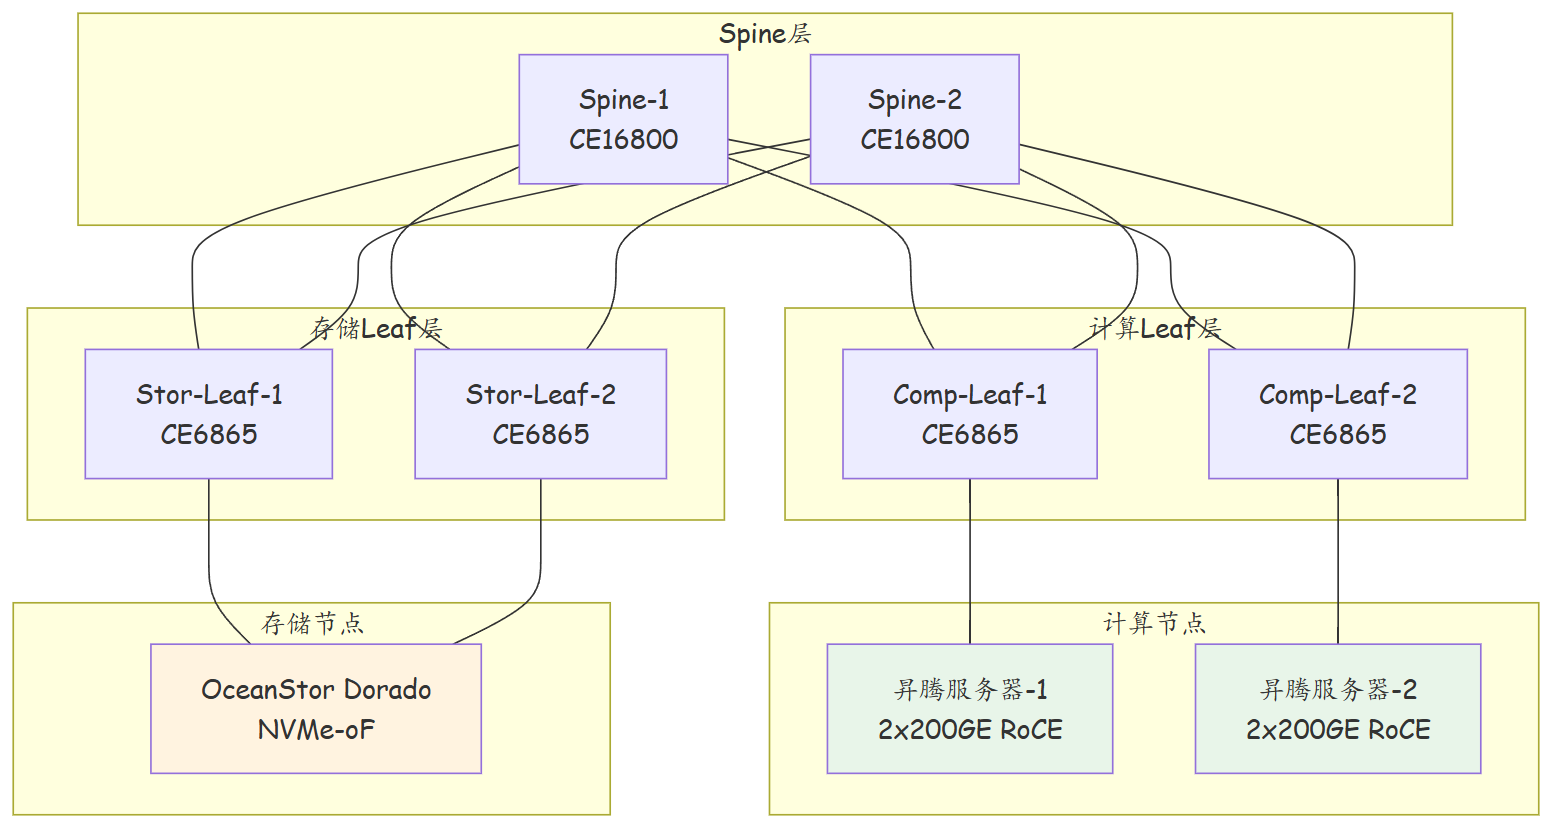
2.2 关键配置项
| 配置项 | 位置 | 说明 |
|---|---|---|
| 无损网络 | 交换机 | PFC + ECN + DCQCN |
| NVMe-oF子系统 | 存储 | NVMe Subsystem和Namespace |
| NVMe主机连接 | 服务器 | 发现并连接NVMe Target |
| RDMA配置 | 服务器 | RoCEv2网卡和子网管理器 |
| QoS策略 | 交换机 | 保障NVMe流量优先级 |
三、技术细节
3.1 网络层配置
无损网络配置(Spine+Leaf):
# Leaf交换机 NVMe over RoCEv2 网络配置
sysname Stor-Leaf-01
#
# PFC配置
pfc enable
pfc priority 3
queue 3 pfc enable
queue 3 buffer-size 512KB
pfc watchdog enable
pfc watchdog timeout 100
#
# ECN配置
ecn enable
ecn profile nvme-ecn
 threshold green 60%
 threshold yellow 75%
 threshold red 85%
queue 3 ecn profile nvme-ecn
#
# DCQCN配置
dcqcn enable
dcqcn config profile nvme-dcqcn
 congestion-timeout 100
 initial-rate 200
 min-rate 20
 alpha 24
 beta 64
#
# 队列调度
queuing scheduler profile nvme-qos
 queue 3 strict-priority
 queue 2 weight 20
 queue 1 weight 30
 queue 0 weight 50
#
# 应用到所有上联和下联端口
interface 100GE1/0/45
 description To-Spine-1
 queuing scheduler nvme-qos
 port mtu 9198
#
interface 200GE1/0/1
 description To-Storage
 queuing scheduler nvme-qos
 port mtu 9198
3.2 存储端配置
华为OceanStor Dorado NVMe-oF配置:
# 1. 创建前端主机接口(RoCE)
storage_port
 create port_id=1 protocol=ethernet
 set ip_address=192.168.200.10 netmask=255.255.255.0

# 2. 启用NVMe-oF over RoCE
protocol nvme_of
 enable transport=roce
 set port=1

# 3. 创建NVMe子系统
nvme_subsystem
 create subsystem_name=AI-NVME-SS
 add port transport=roce traddr=192.168.200.10 trsvcid=4420

# 4. 创建LUN和命名空间
lun
 create lun_id=0 capacity=10TB thin=true storage_pool=NVME-SP-0
namespace
 create ns_id=1 subsystem=AI-NVME-SS lmap=lun_0

# 5. 添加主机连接
nvme_host
 create host_name=Ascend-01
 add host_nqn=nqn.2024.com.huawei:ascend-01
 connect subsystem=AI-NVME-SS
3.3 服务器端配置
昇腾服务器NVMe-oF连接配置:
# 1. 配置RoCEv2网卡
# 设置网卡RDMA模式
ip link set eth2 up
ip addr add 192.168.200.20/24 dev eth2

# 2. 配置RDMA子网管理器
rdma link show
# 确认RoCE端口状态为UP

# 3. 发现NVMe-oF Target
nvme discover -t rdma -a 192.168.200.10 -s 4420

# 4. 连接NVMe-oF Target
nvme connect -t rdma -a 192.168.200.10 -s 4420 -n nqn.2024.com.huawei:ai-nvme-ss

# 5. 验证NVMe设备
nvme list
# 应显示新连接的NVMe设备
3.4 性能验证
# fio随机读测试
fio --name=nvme-roce-randread \
    --filename=/dev/nvme1n1 \
    --rw=randread \
    --bs=4k \
    --direct=1 \
    --numjobs=128 \
    --time_based \
    --runtime=120 \
    --group_reporting

# fio顺序写测试
fio --name=nvme-roce-seqwrite \
    --filename=/dev/nvme1n1 \
    --rw=write \
    --bs=1M \
    --direct=1 \
    --numjobs=16 \
    --time_based \
    --runtime=60 \
    --group_reporting
预期性能指标:
| 测试项 | 目标值 | 说明 |
|---|---|---|
| 4K随机读IOPS | > 500万 | 128并发队列 |
| 4K随机读延迟 | < 100μs | p99延迟 |
| 1M顺序写带宽 | > 8GB/s | 双200GE聚合 |
| NVMe连接延迟 | < 5μs | 端到端 |
3.4 部署架构变体对比
根据规模与性能要求的不同,NVMe over RoCEv2有多种部署架构:
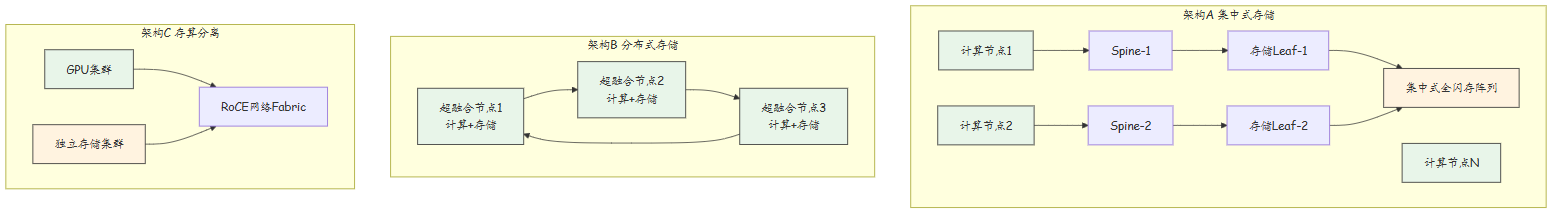
三种部署架构对比:
| 维度 | 集中式存储 | 分布式存储 | 存算分离 |
|---|---|---|---|
| 存储位置 | 独立存储区域 | 与计算节点共置 | 独立存储Fabric |
| 扩展性 | 存储独立扩展 | 存算同步扩展 | 存算独立扩展 |
| 延迟 | 中(经存储Fabric) | 最低(本地优先) | 低(专用Fabric) |
| 数据局部性 | 无 | 高(本地缓存) | 中 |
| 适用规模 | 中小规模 | 超大规模 | 中大规模 |
| 典型场景 | 传统AI训练 | 超算/HPC | AI推理+训练 |
3.5 性能调优方法论
NVMe over RoCEv2的性能调优需要系统化的方法:
| 调优层级 | 调优项 | 检查命令 | 目标值 |
|---|---|---|---|
| 网卡层 | RPS/RFS启用 | cat /proc/irq/*/smp_affinity | CPU绑核 |
| 网卡层 | 中断合并 | ethtool -c eth2 | combined 4-8 |
| 网卡层 | RSS队列数 | ethtool -l eth2 | ≥CPU核心数 |
| 内核层 | TCP窗口缩放 | sysctl net.ipv4.tcp_window_scaling | 1 |
| 内核层 | 大页内存 | cat /proc/meminfo | grep Huge | 启用 |
| 内核层 | 脏页回写延迟 | sysctl vm.dirty_expire_centisecs | 500 |
| 网络层 | PFC/WDCWatchdog | display pfc statistics | 无Pause风暴 |
| 网络层 | ECN标记率 | display ecn statistics | <5% |
| 存储层 | 队列深度 | fio --iodepth=4096 | 匹配SSD |
| 存储层 | Namespace对齐 | nvme id-ns /dev/nvme0n1 | 4K对齐 |
3.6 端到端延迟分解
理解NVMe over RoCEv2的端到端延迟构成,是精准定位性能瓶颈的前提:
| 延迟构成 | 典型值 | 占比 | 优化方向 |
|---|---|---|---|
| NVMe SSD内部延迟 | 10-50μs | 40-50% | 选择高性能SSD |
| RDMA NIC处理 | 2-5μs | 5-10% | 启用硬件卸载 |
| 网络传输(单跳) | 1-3μs | 5-10% | 优化链路距离 |
| 交换机转发 | 0.5-2μs | 3-8% | 低延迟交换机 |
| 协议封装/解封装 | 1-3μs | 5-10% | RoCEv2 vs RoCEv1 |
| 操作系统开销 | 5-15μs | 10-20% | DPDK/kernel bypass |
| 总计 | 20-90μs | 100% | 系统调优 |
3.7 监控与告警体系
| 监控维度 | 指标 | 采集方式 | 告警阈值 |
|---|---|---|---|
| NVMe连接 | 连接状态 | nvme list | 连接断开 |
| NVMe连接 | 超时重传计数 | nvme smart-log | >10/小时 |
| 性能 | IOPS | fio/smartctl | <基线80% |
| 性能 | 延迟P99 | 自研探针 | >500μs |
| 性能 | 带宽利用率 | Telemetry | >85%持续5分钟 |
| 网络 | PFC Pause帧 | SNMP/Telemetry | >100/分钟 |
| 网络 | ECN标记率 | Telemetry | >5% |
| 网络 | 丢包率 | SNMP接口统计 | >0 |
| 存储 | 温度 | smartctl | >70°C |
| 存储 | 介质磨损 | smartctl Media_Wearout_Indicator | >80% |
四、实战配置/案例分析
4.1 故障案例一:RoCE PFC配置不一致
现象:NVMe-oF连接正常,但性能测试时IOPS只有预期值的30%,延迟波动剧烈。
排查过程:
# 检查PFC统计
display pfc statistics interface 200GE1/0/1

# 发现大量PFC Pause帧
# Pause发送: 80000/分钟
# 丢包计数: 15000/分钟 (PFC未能完全消除丢包)

# 检查对端交换机PFC配置
# Spine交换机的PFC优先级配置为P5
# Leaf交换机的PFC优先级配置为P3
# 两端PFC优先级不一致!
根因:Spine和Leaf交换机的PFC优先级映射不一致。Leaf将RoCE流量映射到P3并启用PFC,但Spine将RoCE流量映射到P5(未启用PFC)。当Spine的P5队列拥塞时,直接向Leaf丢包,Leaf的PFC机制无法生效。
解决: 1. 统一Spine和Leaf的PFC优先级映射(均使用P3) 2. 在全网范围内验证PFC配置一致性 3. 使用Telemetry监控全网PFC状态
4.2 故障案例二:MTU不匹配导致NVMe-oF性能下降
现象:NVMe-oF连接的顺序读写带宽仅为预期值的50%。
排查过程:
# 检查MTU配置
display interface 200GE1/0/1
# 交换机端口MTU: 1500 (默认值, 未配置Jumbo Frame)

# 检查服务器网卡MTU
ip link show eth2
# 服务器MTU: 9000

# NVMe-oF使用大I/O(128KB), 在MTU 1500的网络上需要大量分片
# 分片导致CPU开销增加和延迟升高
根因:交换机端口未配置Jumbo Frame(MTU 9000),导致NVMe-oF的大I/O请求被分割成多个小包传输,大幅增加CPU开销和延迟。
解决: 1. 在NVMe-oF路径上的所有交换机端口配置MTU 9198(含以太网头、VLAN头等开销) 2. 确认服务器网卡MTU为9000 3. 重新测试,顺序写带宽恢复至8.5GB/s
五、总结
| 部署环节 | 关键配置 | 注意事项 |
|---|---|---|
| 无损网络 | PFC+ECN+DCQCN | 全网配置一致 |
| MTU | Jumbo Frame 9000 | 端到端一致 |
| 存储NVMe-oF | 子系统/命名空间 | NQN唯一性 |
| 服务器连接 | nvme discover/connect | RDMA端口状态 |
| 性能验证 | fio测试 | 队列深度匹配 |
| 多路径 | multipath配置 | 路径优先级 |
| 监控告警 | Telemetry+SNMP | 全维度覆盖 |
| 性能指标 | 目标 | 告警阈值 |
|---|---|---|
| IOPS(4K随机读) | > 500万 | < 200万 |
| 延迟p99 | < 100μs | > 500μs |
| 带宽(顺序写) | > 8GB/s | < 4GB/s |
| 丢包率 | 0 | > 0 |
| PFC Pause | < 10/分钟 | > 100/分钟 |
思考
- NVMe over RoCEv2部署中,如果RoCE子网管理器(Subnet Manager)未正确运行,会产生什么影响?
- 在大规模AI集群(数百个GPU节点)中,如何优化NVMe-oF存储的并发I/O性能?
- NVMe-oF连接发现(nvme discover)失败时,应该从哪些层面排查问题?
- 集中式存储与存算分离架构在NVMe-oF场景下各有什么优劣?如何选择?
- 端到端延迟分解中,SSD内部延迟占比最高(40-50%),这是否意味着网络优化空间有限?
下篇预告:第271篇:云计算网络基础:虚拟交换机(OVS)