第300篇:AI 时代的数据中心网络趋势
关键词:AI数据中心、AI集群网络、RoCEv2、InfiniBand、NVLink、SLB、NetDB、智能网卡、无损网络
一、引言
AI大模型的训练和推理正在重塑数据中心的网络架构。从GPT-3的1750亿参数到GPT-4的数万亿参数,再到未来万卡乃至十万卡规模的AI集群,数据中心网络不仅要承载传统的存储和计算流量,更要支撑海量的GPU间通信、分布式梯度同步和大规模参数传递。
AI时代的流量特征与传统数据中心截然不同:流量更加集中(GPU服务器之间的全互联通信)、更加密集(训练期间带宽利用率接近100%)、对丢包极度敏感(一次丢包可能导致整个训练批次的回退)。这些特征催生了全新的网络架构理念和技术体系。
本文将系统梳理AI时代数据中心网络的六大核心趋势,展望从单机柜到超大规模集群的网络演进方向。
二、核心概念
2.1 AI 数据中心流量特征
| 特征 | 传统DC流量 | AI集群流量 |
|---|---|---|
| 流量模式 | 东西向+南北向混合 | 东西向为主(GPU间通信) |
| 拓扑模式 | 树形/星型 | 全互联/蝴蝶胖树 |
| 带宽利用率 | 10-30%(长尾分布) | 80-100%(持续高峰) |
| 流规模 | 大量小流 | 少量超级大流 |
| 丢包容忍 | TCP自动重传 | 不可容忍(重传代价极高) |
| 时延敏感 | 毫秒级 | 微秒级(集合通信) |
| 包大小 | MTU 1500 | Jumbo Frame 9000-10000 |
2.2 AI 集群网络架构演进
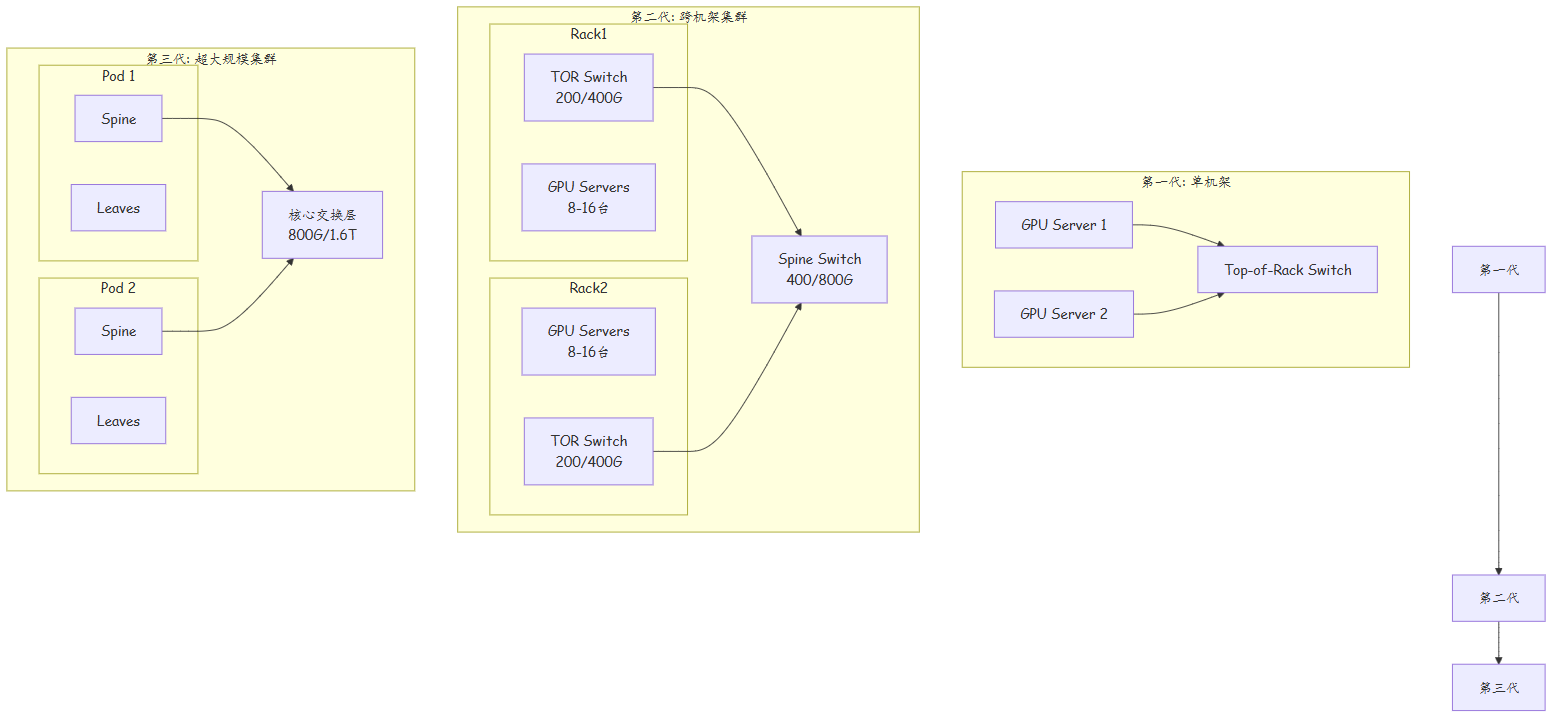
2.3 AI 网络核心协议对比
| 协议栈 | 优势 | 劣势 | 适用场景 |
|---|---|---|---|
| InfiniBand (IB) | 超低时延、零丢包、RDMA原生 | 封闭生态、成本高、扩展受限 | 中小规模AI集群(<2000卡) |
| RoCEv2 + PFC + ECN | 开放以太网、生态广、成本低 | 配置复杂、调优困难 | 大规模AI集群(>2000卡) |
| TCP/IP (DPDK) | 最通用、最成熟 | 时延高、CPU开销大 | 推理、非实时训练 |
| iWARP | TCP语义+RDMA性能 | 部署较少 | 混合场景 |
2.4 AI 网络关键指标
| 指标 | 要求 | 说明 |
|---|---|---|
| 有源网络直径 | ≤2跳 | 减少排队时延累积 |
| 端到端时延 | <10μs | 集合通信效率 |
| 带宽利用率 | >95% | AI训练效率 |
| 丢包率 | <10⁻⁷ | 避免重传导致的全局回退 |
| 抖动 | <1μs | 集合通信同步 |
| 网络可用率 | >99.99% | 避免训练中断 |
三、技术细节
3.1 趋势一:无损网络成为标配
AI训练流量(NCCL集体通信)对丢包零容忍。传统的TCP重传机制在AI场景下代价过高——单个包的丢失可能导致整个训练节点上的所有GPU回退到上一个检查点。
三层无损保障体系:
| 层级 | 技术 | 功能 |
|---|---|---|
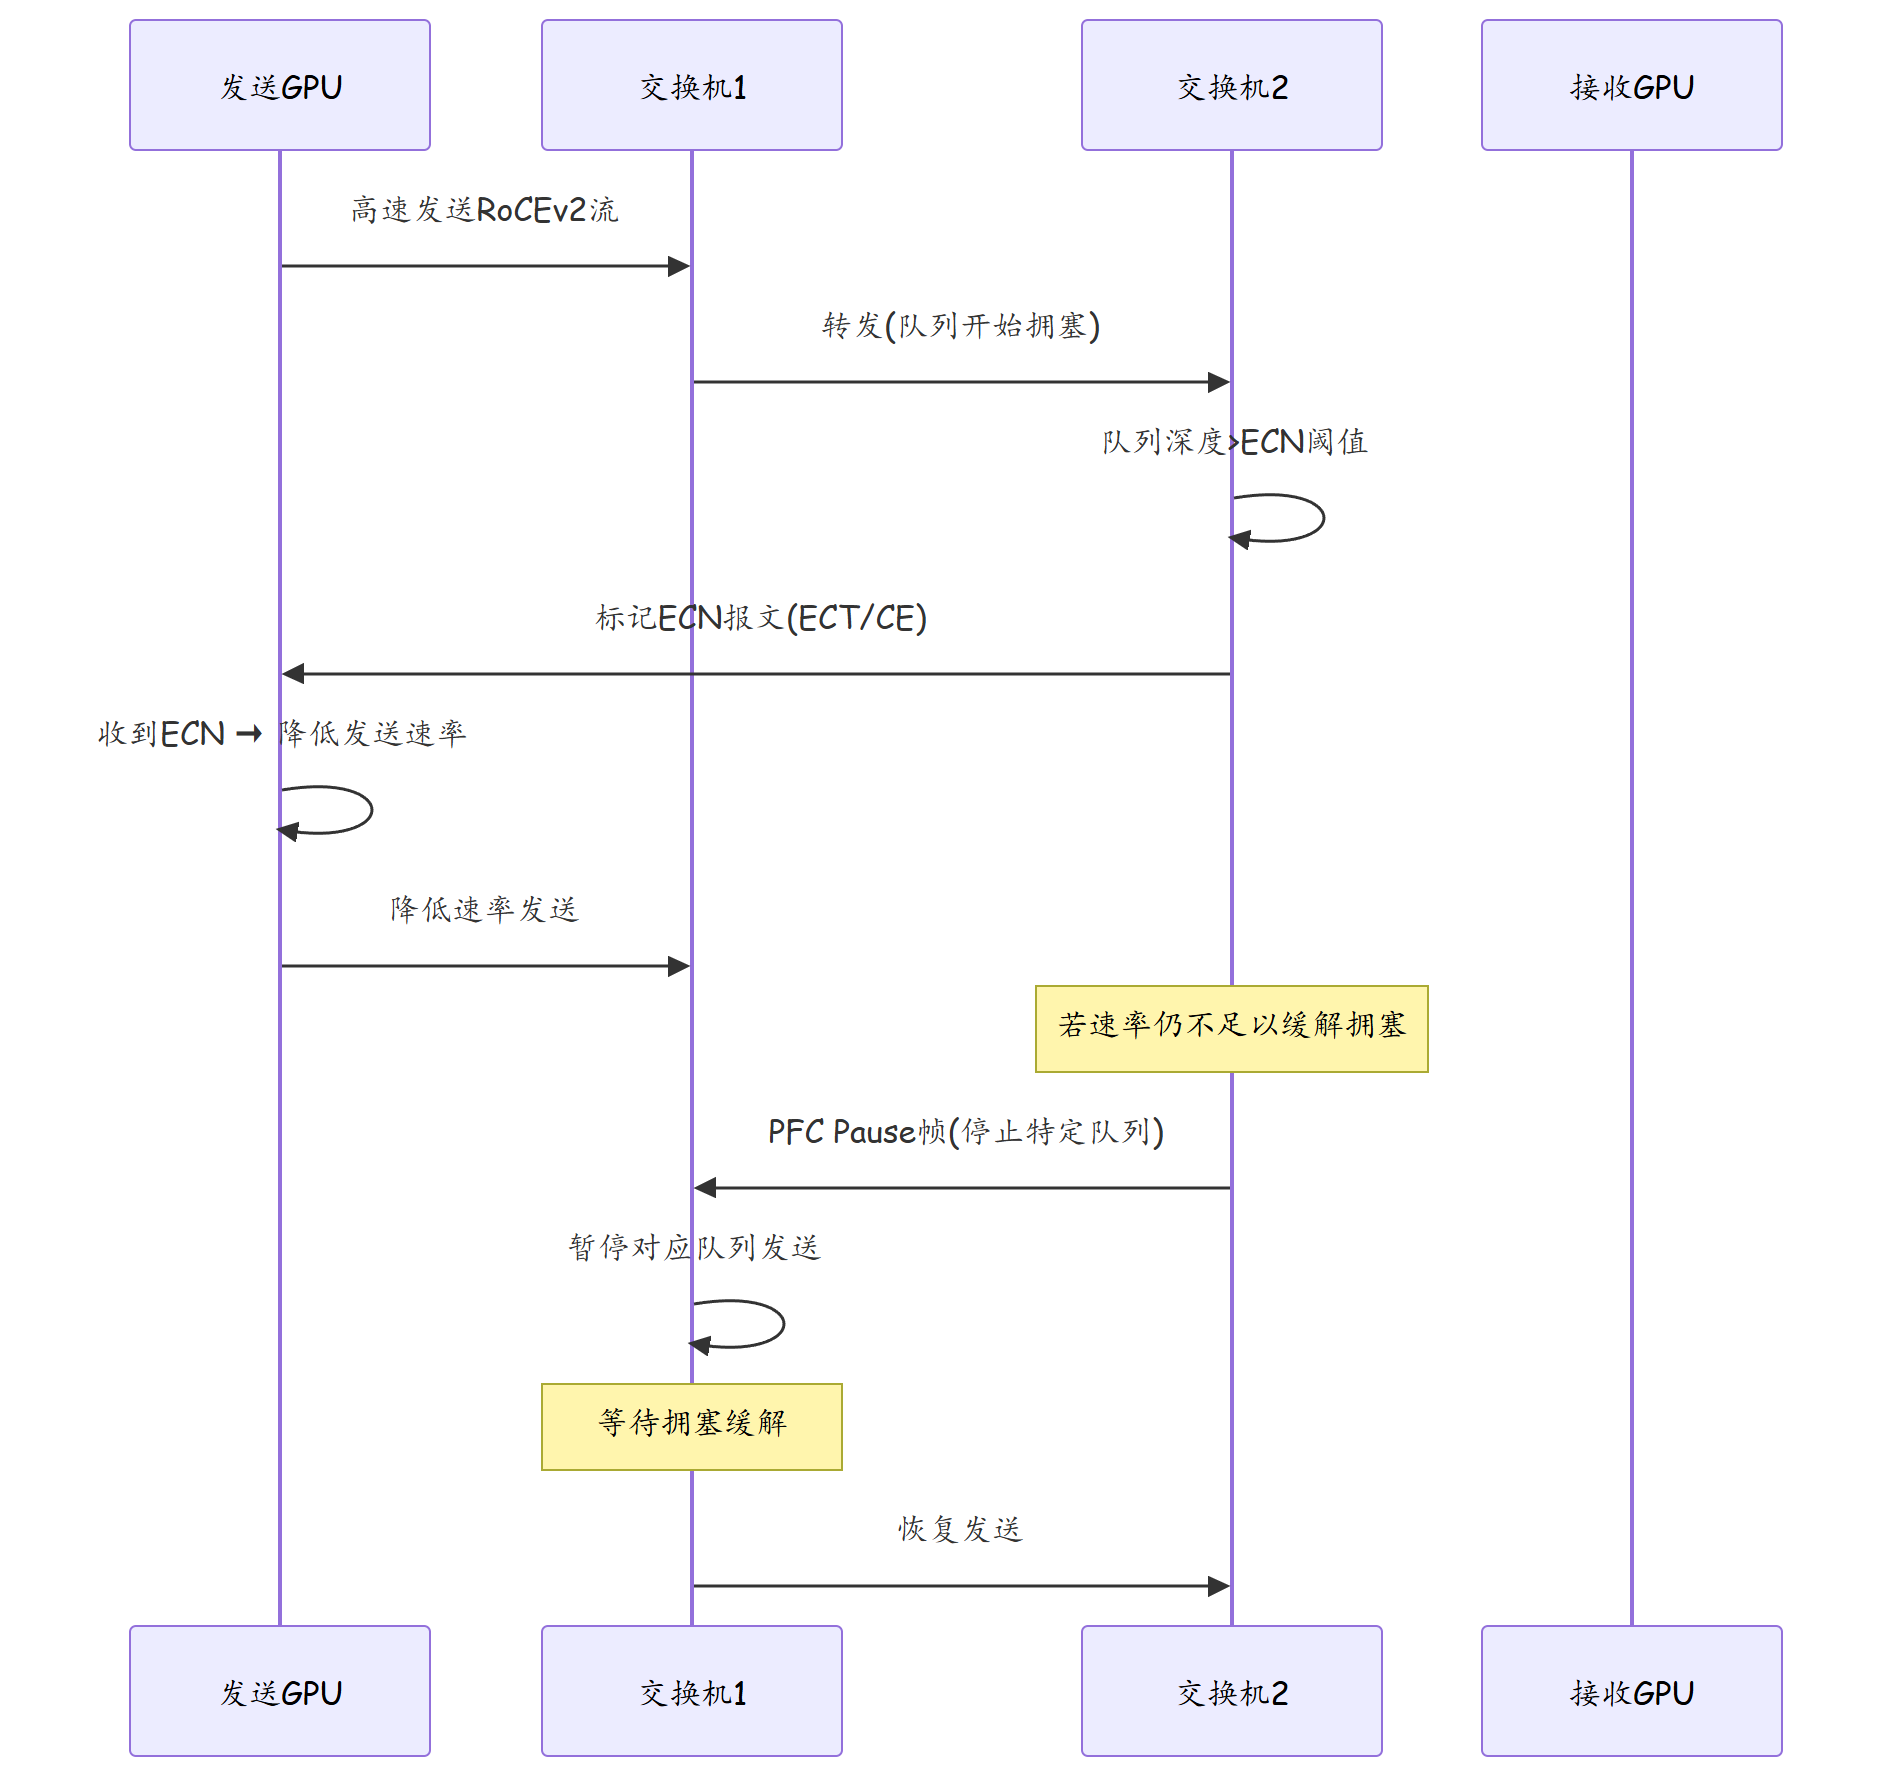
| 链路层 | PFC (Priority Flow Control) | 基于优先级的流控,防止队列溢出 |
| 网络层 | ECN (Explicit Congestion Notification) | 显式拥塞标记,提前缓解拥塞 |
| 协议层 | DCQCN / HPCC | 端到端拥塞控制协议 |
PFC + ECN 联合工作:
3.2 趋势二:智能网卡(SmartNIC/DPU)的崛起
智能网卡将网络处理从CPU卸载到专用硬件,为AI服务器提供极致的网络性能:
| 能力 | 传统NIC | 智能NIC/DPU |
|---|---|---|
| RDMA卸载 | 部分支持 | 完全硬件卸载 |
| PFC/ECN处理 | 软件处理 | 硬件级实时处理 |
| 加密/解密 | CPU处理 | 硬件加密引擎 |
| 虚拟化(vSwitch) | 宿主CPU | NIC侧vSwitch |
| 存储协议卸载 | 无 | iSCSI/NVMe-oF卸载 |
| 安全策略 | 宿主执行 | NIC侧安全引擎 |
主流智能NIC对比:
| 产品 | 厂商 | 速率 | 核心特性 |
|---|---|---|---|
| ConnectX-7/8 | NVIDIA/Mellanox | 400G/800G | RoCE/IB双栈、AI加速 |
| BlueField-3 | NVIDIA | 200G+Arm CPU | DPU、完整计算卸载 |
| Azure NCLU | Microsoft | 200G/400G | 定制化DPU |
| Horizon X5 | Marvell | 400G/800G | ODP开放数据路径 |
| RoCE SmartNIC | 华为 | 400G/800G | 自研RoCE协议栈 |
3.3 趋势三:自适应负载均衡(ALB/SLB)
传统ECMP在AI流量场景下存在严重缺陷——由于AI集群的流量高度集中(少数超级大流占据绝大部分带宽),ECMP的基于流哈希的负载均衡容易导致部分链路拥塞而部分链路空闲。
| 负载均衡方式 | 机制 | AI场景适配度 |
|---|---|---|
| 5-tuple ECMP | 基于5元组哈希 | 差(超级大流集中) |
| Flowlet Switching | 基于流微流切换 | 中(依赖流间歇) |
| Per-Packet Load Balancing | 逐包负载均衡 | 好但包乱序 |
| SLB (Sub-Flow Load Balance) | 基于子流负载均衡 | 优(NVIDIA方案) |
| NetDB + 动态路由 | 基于全局拓扑感知的动态路由 | 优(Cisco方案) |
3.4 趋势四:400G/800G/1.6T 端口速率演进
AI数据中心正经历前所未有的端口速率升级:
| 时间线 | TOR端口速率 | Spine端口速率 | 互联速率 |
|---|---|---|---|
| 2022-2023 | 100G | 400G | 400G |
| 2024-2025 | 400G | 800G | 800G |
| 2026-2027 | 800G | 1.6T | 1.6T |
| 2028+ | 1.6T | 3.2T | 3.2T |
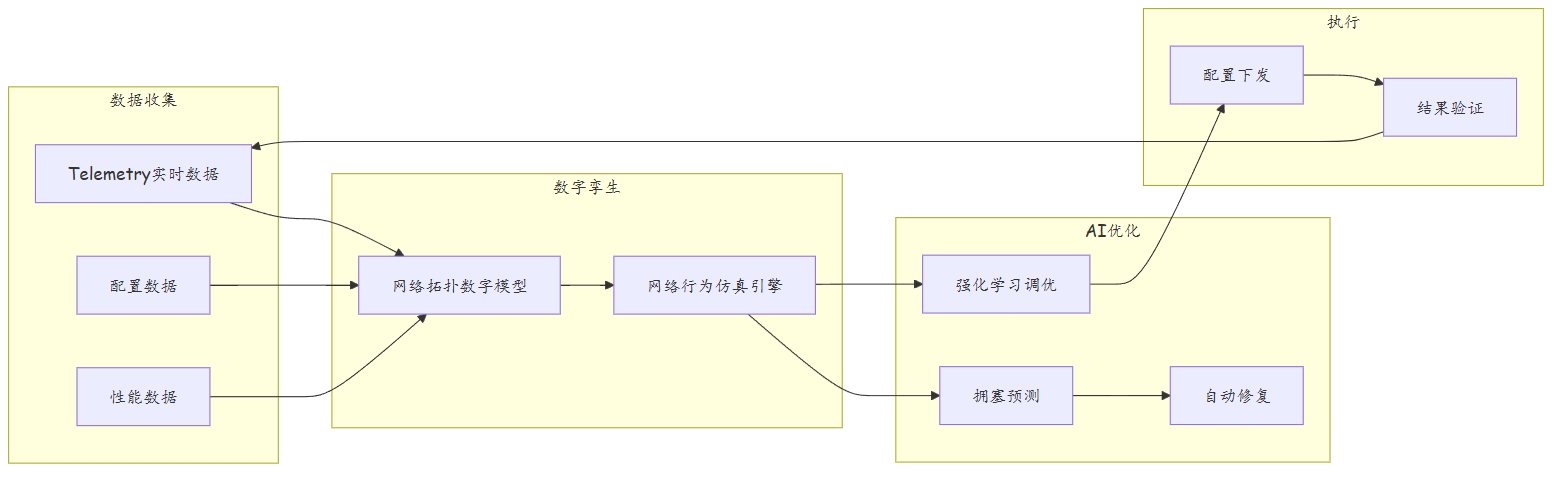
3.5 趋势五:网络数字孪生与AI运维
利用AI技术对网络进行建模、仿真和优化的闭环:
3.6 趋势六:存算分离与 disaggregation
AI训练中,GPU计算和网络I/O的分离架构(Disaggregated Architecture)正在兴起:
| 架构类型 | 说明 | 优势 |
|---|---|---|
| Collocated | GPU+NIC+Switch同机架 | 低时延、部署简单 |
| Disaggregated Compute | 计算节点与网络节点分离 | 灵活扩容、资源解耦 |
| Disaggregated Memory | 远程GPU内存共享 | 内存池化、提高利用率 |
| NVMe-oF 存储池 | GPU通过RoCE直接访问远程NVMe | 存储与计算解耦 |
四、实战配置/案例分析
4.1 AI 集群 RoCEv2 无损网络配置
# ============================
# AI集群TOR交换机无损网络配置
# 华为 CloudEngine 8860
# ============================

# 1. 配置PFC (优先级流控)
interface 400GE1/0/1
 # PFC在Priority 3上启用(RoCEv2通常映射到P3)
 qos pfc enable priority 3
 qos pfc max-pause 300000  # 最大Pause时间300ms

# 2. 配置ECN (显式拥塞通知)
# 全局ECN配置
ecn enable
 ecn profile AI-ECN
  wred queue 3
   ecn-mark enable
   queue-min-threshold 50    # 队列深度50%开始标记ECN
   queue-max-threshold 75    # 队列深度75%全部标记ECN
   ecn-threshold 60          # ECN标记阈值60%

# 3. 配置DCQCN (Data Center Quantized Congestion Notification)
# DCQCN参数调优
qos dcqcn enable
 dcqcn profile AI-DCQCN
  alpha 1024                 # 乘法增加因子
  beta 786                   # 乘法减少因子
  max-rate 400000            # 最大发送速率400Gbps
  min-rate 1000              # 最小发送速率1Gbps
  initial-rate 10000         # 初始发送速率10Gbps
  ccm-rate-increase 1000     # CCM速率增加步长

# 4. 配置接口Jumbo Frame
interface 400GE1/0/1
 mtu 10000                  # Jumbo Frame (AI训练常用)

# 5. 配置端口速率
interface 400GE1/0/1
 speed 400000
 duplex full

# 6. 监控PFC/ECN统计
display qos pfc statistics interface 400GE1/0/1
display qos ecn statistics interface 400GE1/0/1
display qos dcqcn statistics
4.2 故障案例:PFC 死锁导致 AI 训练停滞
故障现象:某256卡AI训练集群在训练第3小时突然出现整体停滞,所有GPU的NCCL通信时延从正常的5μs飙升至数秒,训练任务完全停止。
排查过程:
# 1. 检查PFC统计
display qos pfc statistics interface 400GE1/0/1
# Priority 3:
#   Pause帧接收数: 2,456,789 (异常高)
#   Pause帧发送数: 2,345,678 (异常高)
#   平均Pause时间: 250ms (接近最大值)

# 2. 检查交换机队列深度
display queuing interface 400GE1/0/1
# 队列3(RoCE):
#   当前深度: 99% (几乎满)
#   队列大小: 512KB (配置偏小)

# 3. 检查PFC死锁检测
display qos pfc deadlock-detection
# 死锁检测: 发现PFC环路!
# 环路路径: TOR1(Q3) → Spine(Q3) → TOR2(Q3) → Spine(Q3) → TOR1(Q3)
# PFC Pause帧在环路上循环, 形成死锁

# 4. 分析根因
# TOR1的队列3拥塞 → 向Spine发送PFC Pause
# Spine的队列3暂停TOR1方向的转发
# Spine向TOR2方向也有拥塞 → 向TOR2发送PFC Pause
# 但TOR2方向有发往TOR1的流量被Spine暂停
# 结果: 环路中所有端口互相等待, 形成PFC死锁
根因:AI集群中多个超级大流同时经过Spine交换机,导致PFC Pause帧在Spine和TOR之间形成环路。PFC死锁一旦发生,所有被Pause的队列完全停止转发,AI训练流量被完全阻断。
解决措施: 1. 增大交换机队列深度(从512KB增至2MB),降低PFC触发频率 2. 配置PFC Deadlock Detection and Recovery(死锁检测与恢复),自动打破死锁 3. 优化ECN阈值,提前标记拥塞,通过DCQCN降低发送速率,减少PFC触发 4. 调整AI训练任务的通信模式,减少跨Spine的流量
# 增大队列深度
qos queue 3
 queue size 2048 KB

# 启用PFC死锁检测
qos pfc deadlock-detection enable
 deadlock-detection-interval 5000    # 5秒检测一次
 deadlock-recovery-action drop-ccm  # 死锁恢复: 丢弃CCM包触发速率下降

# 优化ECN阈值(提前标记)
ecn profile AI-ECN-V2
 wred queue 3
  queue-min-threshold 30     # 从50%降至30%
  queue-max-threshold 60     # 从75%降至60%
  ecn-threshold 40           # 从60%降至40%
4.3 故障案例:GPU网卡固件 Bug 导致 NCCL 通信异常
故障现象:某AI集群使用NVIDIA A100 GPU + ConnectX-6 DX智能网卡,NCCL集体通信(AllReduce)的带宽利用率只有理论值的60%,且时延抖动严重。
排查过程:
# 1. 检查RoCE性能
# nccl-tests 测试结果:
# AllReduce (256 GPU):
#   带宽: 24Gbps/GPU (理论应>35Gbps)
#   时延: 50-200μs (理论应<10μs)

# 2. 检查网卡驱动和固件
# mlxfwmanager -q
# ConnectX-6 DX:
#   FW Version: 23.31.1014 (发现旧版本)
#   Driver: mlx5_core 5.1-1.22 (旧版本)

# 3. 检查RoCE重传统计
# ip link show
# retransmits: 持续递增
# 网卡内部的重传计数器异常高

# 4. NVIDIA官方KB排查
# 发现ConnectX-6 DX FW 23.31.x存在已知Bug:
# Bug ID: SDEV-xxx
# 描述: 特定条件下的RoCEv2流控处理错误
# 影响: 带宽下降40%, 时延增加10倍
# 修复版本: FW 24.32.x
根因:NVIDIA ConnectX-6 DX网卡固件版本存在已知Bug,在特定的RoCEv2流控场景下,网卡错误地处理PFC Pause帧,导致不必要的发送暂停和大量重传。
解决措施: 1. 升级网卡固件到最新版本(24.32.x) 2. 升级Mellanox OFED驱动到匹配版本 3. 重新运行nccl-tests验证:带宽提升至36Gbps/GPU,时延降至8μs 4. 建立固件版本管理规范,AI集群的网卡固件纳入统一版本管控
五、总结
| AI网络趋势 | 核心驱动 | 关键技术 |
|---|---|---|
| 无损网络 | 零丢包容忍 | PFC+ECN+DCQCN |
| 智能网卡 | CPU卸载需求 | DPU/SmartNIC硬件卸载 |
| 自适应负载均衡 | 超级大流 | SLB/NetDB/逐包负载 |
| 超高速端口 | 带宽饥渴 | 400G→800G→1.6T |
| AI驱动运维 | 复杂性管理 | 数字孪生+强化学习 |
| 存算分离 | 资源解耦 | Disaggregated Architecture |
| 部署建议 | 说明 |
|---|---|
| 无损网络调优 | PFC+ECN参数需要针对性调优,不可套用模板 |
| 固件管理 | GPU网卡固件版本与驱动必须匹配 |
| 容量规划 | AI集群端口速率需与GPU代际同步升级 |
| 监控体系 | 实时监控PFC Pause、ECN标记、DCQCN速率 |
| 性能基线 | 建立nccl-tests性能基线,快速定位异常 |
思考
- InfiniBand在AI集群中仍有不可替代的优势(超低时延、零配置),而RoCEv2基于开放以太网生态更广。在未来的超大规模AI集群中,哪种协议栈会成为主流?为什么?
- AI训练对网络丢包零容忍,但当PFC死锁发生时,整个网络可能完全瘫痪。如何在"零丢包"和"系统可用性"之间找到平衡?
- 智能网卡/DPU将大量网络功能卸载到硬件,这对网络工程师的技能要求带来了什么变化?网络运维的未来方向是什么?
下篇预告:第301篇:网络运维自动化的Why与How