第296篇:算力感知路由与负载分发
关键词:算力感知路由、BGP扩展、SR-TE、负载均衡、算力调度、路径优化、算网融合
一、引言
在第295篇中,我们介绍了算力网络的整体架构和调度理念。然而,理念需要技术落地。无论算力调度引擎做出多么精妙的决策,如果底层网络无法将业务流量高效、可靠地输送到目标算力中心,整个算力调度体系就是空中楼阁。
算力感知路由(Computing-Aware Routing)是算力网络的核心使能技术。它要求网络路由协议不仅感知拓扑和链路状态,还要感知沿途和目的端的算力资源状态,从而做出"最优路径+最优算力"的联合决策。
本文将深入解析算力感知路由的实现机制、BGP协议扩展方案、SR-TE在算网融合中的应用,以及基于算力感知的负载分发策略。
二、核心概念
2.1 传统路由 vs 算力感知路由
| 维度 | 传统路由 | 算力感知路由 |
|---|---|---|
| 路由决策因子 | 拓扑、链路状态、AS路径、MED | 以上 + 算力类型、算力容量、算力时延、能效 |
| 路由目标 | 最短路径(最少跳数/最低成本) | 最优算力可达路径 |
| 收敛触发 | 链路故障、拓扑变化 | 以上 + 算力资源变化 |
| 协议扩展 | 标准BGP/IS-IS/OSPF | BGP-LS扩展、IS-IS算力TE |
| 路径优化 | ECMP负载均衡 | 算力感知的多路径负载分发 |
2.2 算力感知路由架构
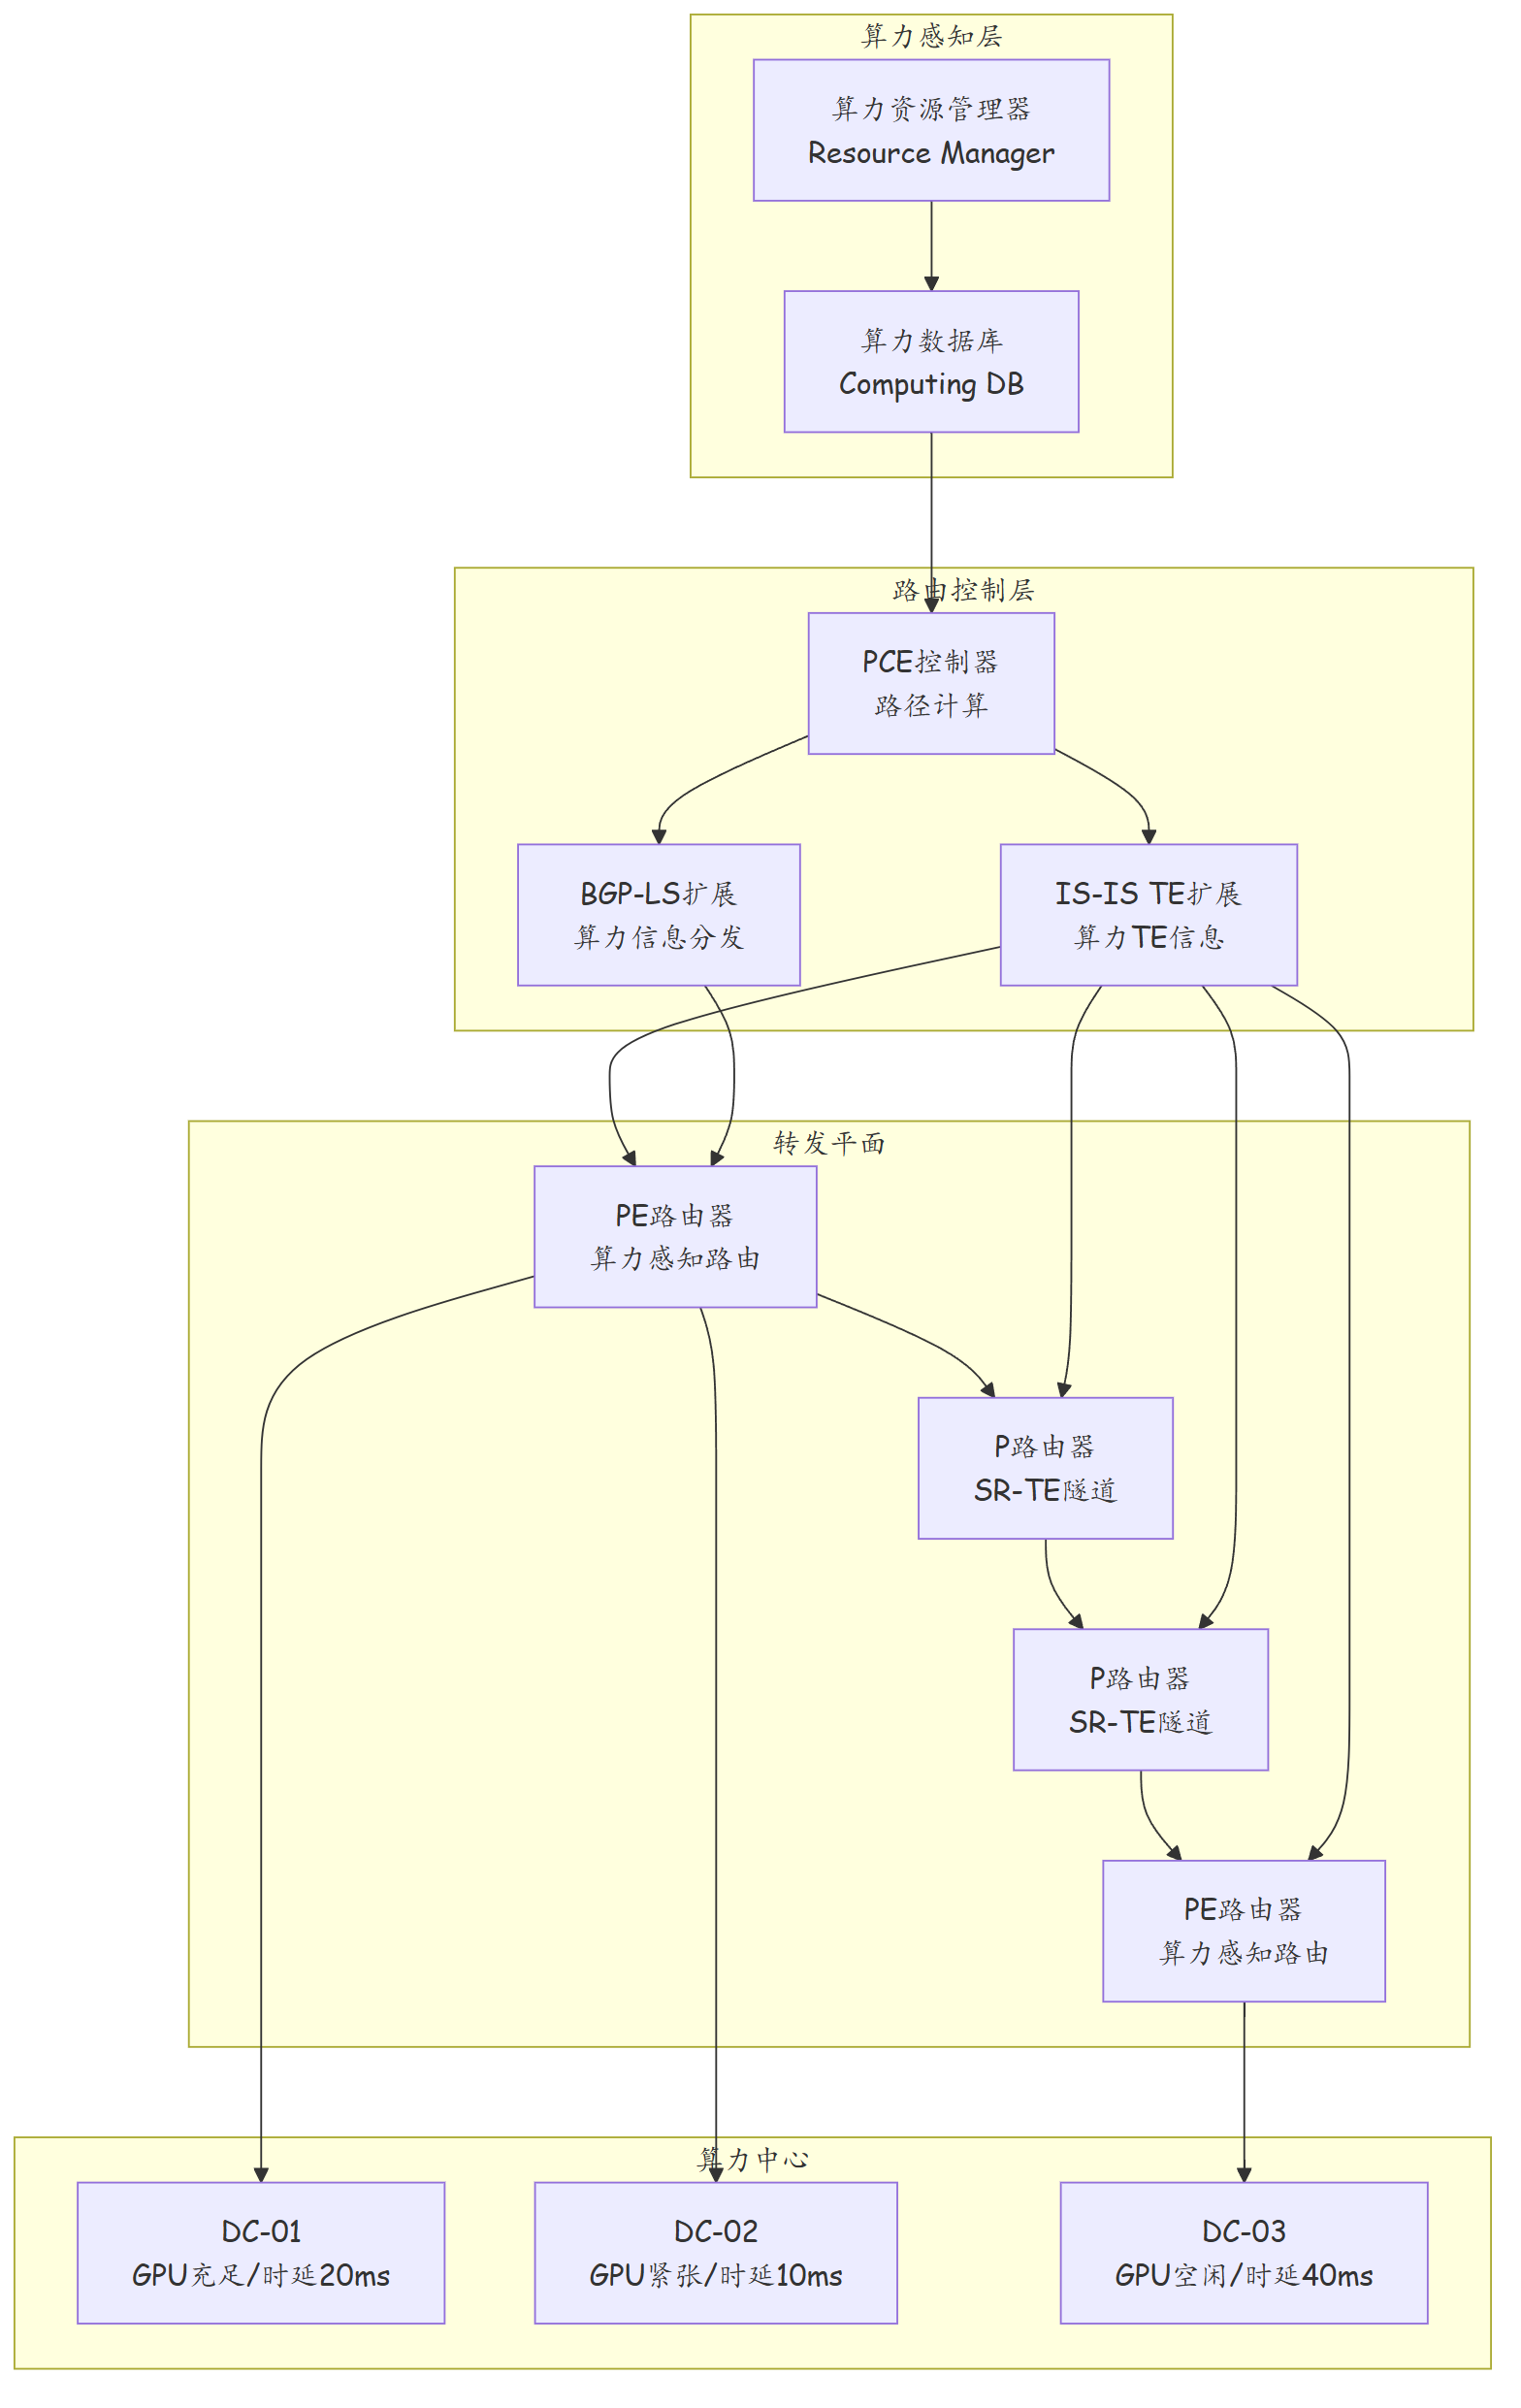
2.3 算力感知信息类型
| 信息类型 | 内容 | 更新频率 | 分发协议 |
|---|---|---|---|
| 算力能力信息 | GPU/CPU类型和数量、存储容量 | 低频(小时级) | BGP |
| 算力状态信息 | 可用算力比例、当前负载率 | 中频(分钟级) | BGP-LS |
| 算力时延信息 | 端到端算力服务时延 | 高频(秒级) | IS-IS/BFD |
| 算力价格信息 | 单位算力价格、网络费用 | 低频(天级) | 业务系统 |
三、技术细节
3.1 BGP 算力信息扩展
BGP协议通过NLRI(Network Layer Reachability Information)扩展来携带算力信息:
算力NLRI扩展格式:
| 字段 | 大小 | 说明 |
|---|---|---|
| Prefix | 可变长度 | 目标前缀地址 |
| Computing Type | 1 Byte | 算力类型:0x01=CPU, 0x02=GPU, 0x03=NPU, 0x04=HPC, 0x05=Edge |
| Compute Cap | 可变 | 算力能力描述(CPU核数/GPU型号等) |
| Extended Communities | 可变 | 扩展社区属性 |
Compute Capabilities (TLV格式): TLV 1: Total Cores/Units (4 bytes) TLV 2: Available Cores/Units (4 bytes) TLV 3: Compute Throughput (8 bytes, FLOPS) TLV 4: Energy Efficiency (4 bytes, FLOPS/W)
**BGP路由策略示例**:

```bash
# 基于算力信息的BGP选路策略
route-policy COMPUTING-AWARE permit 10
 # 优先选择GPU充足且时延<15ms的路径
 if gpu-available gt 200 and compute-delay lt 15ms
  apply preferred 100
 if-end

route-policy COMPUTING-AWARE permit 20
 # 次选GPU可用且成本最低的路径
 if gpu-available gt 50
  apply preferred 50
 if-end

route-policy COMPUTING-AWARE deny 30
 # 拒绝GPU资源不足的目的地
 if gpu-available lt 10
  apply reject
 if-end
3.2 IS-IS 算力 TE 扩展
IS-IS通过扩展TED(Traffic Engineering Database)来携带算力TE信息:
# IS-IS TE扩展:算力TLV
# TLV 253: Computing Resource TLV
#
# Sub-TLV 1: GPU Type and Count
# Sub-TLV 2: GPU Available Ratio
# Sub-TLV 3: Compute Latency (us)
# Sub-TLV 4: Energy PUE

# 设备配置
isis 1
 te-level level-2
  computing-resource advertisement enable
  gpu-type NVIDIA_A100
  gpu-total 4096
  advertisement-interval 300
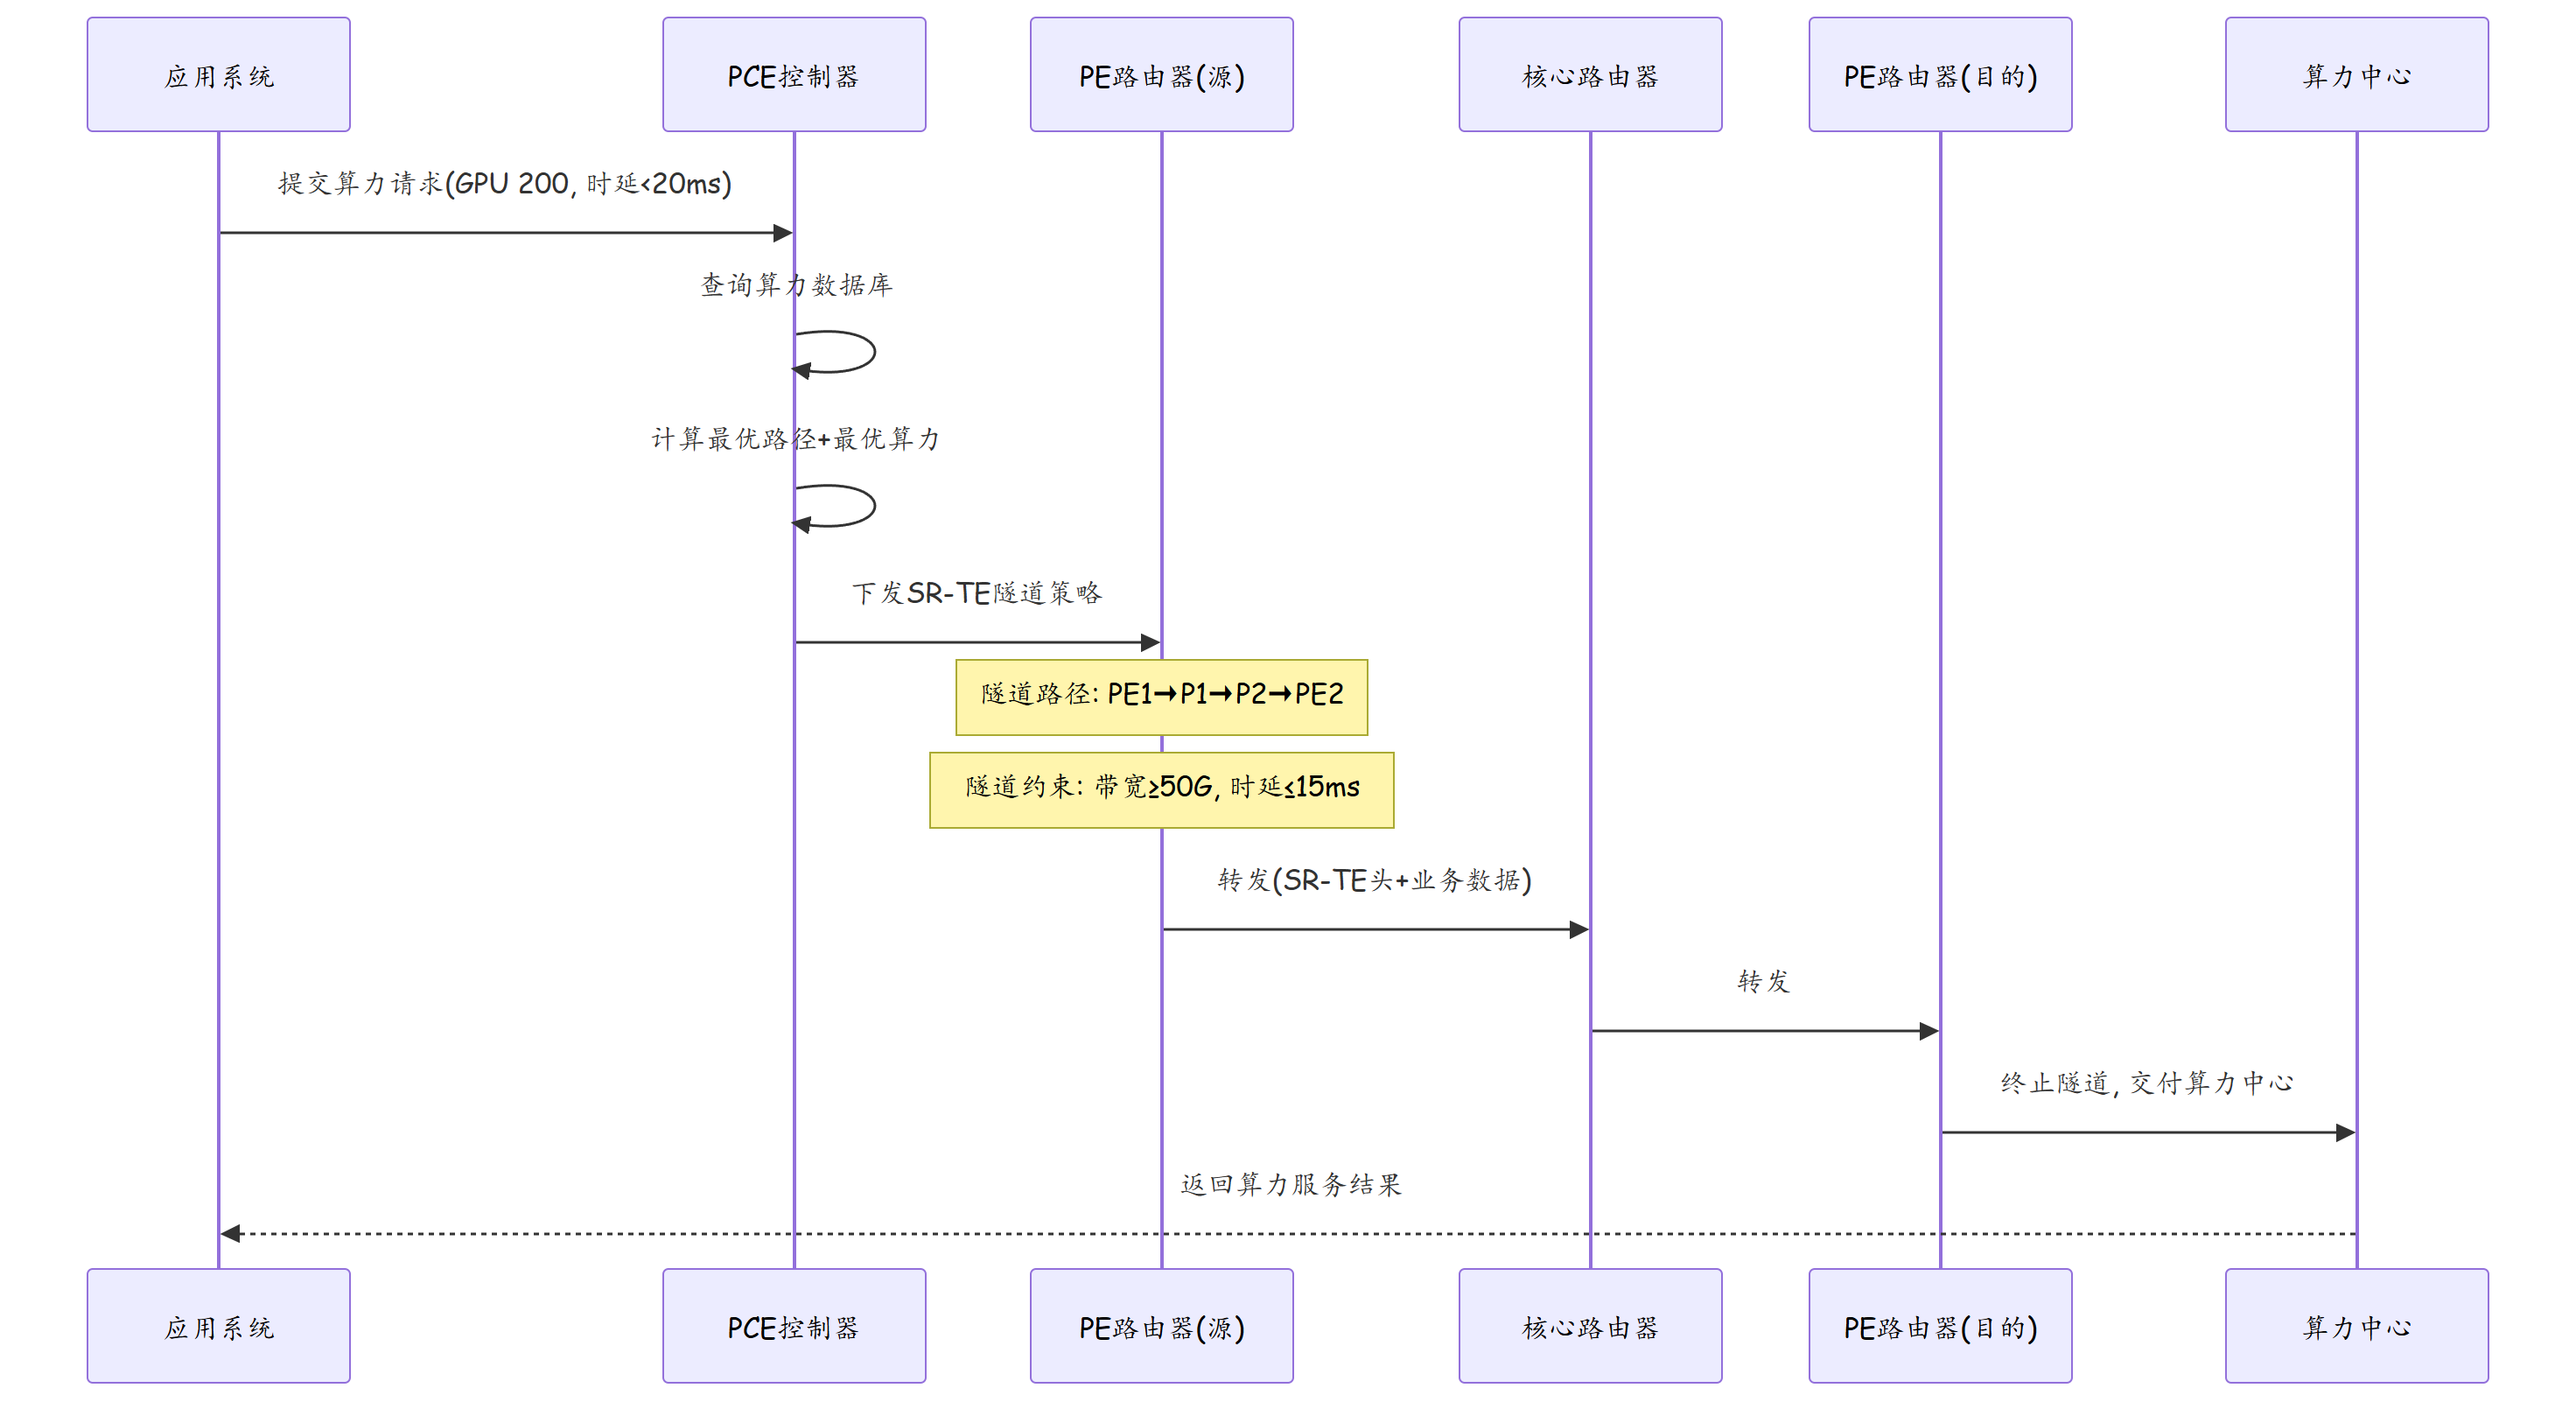
3.3 SR-TE 算力感知隧道
SR-TE(Segment Routing Traffic Engineering)隧道是实现算力感知转发的关键:
3.4 算力感知负载分发
| 负载分发模式 | 说明 | 适用场景 |
|---|---|---|
| 加权ECMP | 基于算力容量加权分配 | 同类型算力中心的均衡 |
| 时延感知ECMP | 基于端到端时延分配 | 实时性敏感业务 |
| 算力感知Anycast | 多算力中心Anycast地址 | 就近算力接入 |
| 弹性伸缩调度 | 动态调整各中心的流量比例 | 潮汐流量场景 |
算力感知Anycast配置:
# ============================
# 算力感知Anycast配置
# ============================

# 所有算力中心的PE路由器宣告同一个Anycast地址
# DC-01侧PE
interface LoopBack100
 ip address 100.64.0.1 255.255.255.255
#
bgp 65001
 ipv4-family unicast
  network 100.64.0.1 255.255.255.255
  community COMPUTING-AWARE gpu-200-delta15ms

# DC-02侧PE
interface LoopBack100
 ip address 100.64.0.1 255.255.255.255
#
bgp 65001
 ipv4-family unicast
  network 100.64.0.1 255.255.255.255
  community COMPUTING-AWARE gpu-50-delta10ms

# DC-03侧PE
interface LoopBack100
 ip address 100.64.0.1 255.255.255.255
#
bgp 65001
 ipv4-family unicast
  network 100.64.0.1 255.255.255.255
  community COMPUTING-AWARE gpu-500-delta40ms
四、实战配置/案例分析
4.1 华为设备算力感知路由完整配置
# ============================
# 源端PE路由器配置
# ============================
sysname PE-Source

# 1. IS-IS算力TE扩展
isis 1
 is-level level-2
 network-entity 01.6500100000001.00
 cost-style wide
#
 te-level level-2
  computing-resource advertisement enable
  advertisement-interval 300
#
interface LoopBack0
 ip address 1.1.1.1 255.255.255.255
 isis enable 1

# 2. BGP算力信息扩展
bgp 65001
 router-id 1.1.1.1
#
 # 配置BGP-LS
 bgp ls enable
  computing-resource advertisement enable
#
 # 配置算力感知路由策略
 route-policy COMPUTE-RIB prefer 10
  if gpu-available gt 100 and compute-delay lt 20ms
   apply med 100
  if-end
 route-policy COMPUTE-RIB prefer 20
  if gpu-available gt 50
   apply med 200
  if-end

# 3. SR-TE算力感知隧道
# 隧道1: 到DC-01 (GPU充足, 低时延)
interface Tunnel-policy DC01-GPU
 destination 10.1.1.1
 tunnel-policy-mode pce
  pce-server 10.10.10.1
  constraint max-delay 15
  constraint min-bandwidth 50000
#
# 隧道2: 到DC-03 (GPU充裕, 高时延, 低成本)
interface Tunnel-policy DC03-GPU
 destination 10.3.3.3
 tunnel-policy-mode pce
  pce-server 10.10.10.1
  constraint max-delay 50
  constraint min-bandwidth 100000
4.2 故障案例:算力资源变化导致路由黑洞
故障现象:某AI训练业务的流量在跨域传输中出现大量丢包,目的端算力中心的PE路由器显示流量到达但GPU调度队列堆积。
排查过程:
# 1. 检查BGP路由表
display bgp routing-table 100.64.0.1
# 路由有效, Next-Hop可达
# 但算力Community显示: gpu-0-delta15ms (GPU可用数为0!)

# 2. 检查算力资源状态
# DC-02的GPU集群刚刚启动了一个大规模训练任务
# GPU可用数从200骤降到0
# 但BGP的算力信息尚未更新(更新间隔300秒)

# 3. 检查SR-TE隧道状态
display tunnel-policy DC02-GPU
# 隧道状态: Up
# 但隧道的算力约束已不满足
# GPU可用数 = 0, 需求 = 100

# 4. 分析流量走向
# 由于BGP路由仍然有效
# 流量继续通过SR-TE隧道发送到DC-02
# GPU调度器无法分配资源
# 数据包在队列中堆积 → 超时丢弃
根因:算力资源状态的BGP更新间隔(300秒)过长,当GPU资源突然耗尽时,路由系统未能及时感知,导致流量继续被调度到已无可用GPU的算力中心。
解决措施: 1. 缩短BGP算力信息的更新间隔,从300秒调整为10秒 2. 在PE路由器上实现GPU资源状态和本地转发策略的联动,当检测到GPU不可用时立即触发路由撤销 3. 引入BFD for Computing,实现算力资源状态的毫秒级检测
# 优化配置
bgp ls enable
 computing-resource advertisement enable
  advertisement-interval 10  # 缩短更新间隔
  fast-failover enable       # 启用快速倒换
#
bfd
 computing-bfd enable
  min-tx-interval 1000
  min-rx-interval 1000
  detect-multiplier 3
4.3 故障案例:算力感知Anycast路由振荡
故障现象:部署算力感知Anycast后,多个业务流量的目的DC频繁切换(每5-10分钟切换一次),导致TCP连接频繁重建,业务体验严重下降。
排查过程:
# 1. 检查Anycast路由收敛
display bgp routing-table 100.64.0.1
# Preferred Peer频繁变化:
# 14:00 → DC-01 (MED=100)
# 14:05 → DC-03 (MED=100)
# 14:10 → DC-01 (MED=100)
# ...

# 2. 检查MED值
# DC-01的GPU可用数在100-150之间波动
# DC-03的GPU可用数在100-120之间波动
# 两者的MED值因GPU可用数的微小波动而交替成为最优

# 3. 分析MED计算逻辑
# MED = f(gpu_available, compute_delay)
# 当两个DC的GPU可用数接近时, MED值非常接近
# BGP的MED选路在两个路径之间振荡
根因:当多个算力中心的GPU可用数量和时延接近时,MED值非常接近,BGP选路在两者之间频繁切换。缺乏路由阻尼(Route Damping)机制来抑制微小变化导致的路由振荡。
解决措施: 1. 引入MED滞后(Hysteresis)机制:只有当新路径的MED比当前路径低一定阈值(如20%)时才切换 2. 配置BGP路由阻尼,抑制短时间内频繁变化的路由 3. 在PCE控制器中实现全局优化的流量分配,避免依赖单条路由的MED选路
# 配置MED滞后
bgp 65001
 med-hysteresis enable
  hysteresis-threshold 20  # MED需要差20%才切换
#
# 配置路由阻尼
route-damping enable
  penalty-half-life 15     # 半衰期15分钟
  suppress-threshold 2000
  reuse-threshold 750
五、总结
| 技术组件 | 功能 | 关键配置 |
|---|---|---|
| BGP算力NLRI | 分发算力资源信息 | computing-resource advertisement |
| IS-IS TE扩展 | 分发算力TE信息 | te-level + computing TLV |
| SR-TE隧道 | 算力导向的路径转发 | constraint max-delay/min-bandwidth |
| PCE控制器 | 全局路径+算力联合优化 | 集中式路径计算 |
| 算力感知Anycast | 就近算力接入 | 统一Anycast地址+MED选路 |
| 部署最佳实践 | 说明 |
|---|---|
| 合理更新间隔 | 算力信息更新不宜过频(>5秒)也不宜过疏(<300秒) |
| MED滞后机制 | 防止路由振荡 |
| BFD联动 | 快速检测算力资源状态变化 |
| 多路径冗余 | 每个算力中心至少2条SR-TE隧道 |
| 全局优化 | PCE集中计算优于分布式BGP选路 |
思考
- 算力感知路由需要在传统BGP/IS-IS协议基础上进行大量扩展,这些私有扩展如何与标准化进程(IETF BGP Extensions for Computing)协调?
- 在多租户的算力网络中,如何确保不同租户的算力感知路由策略互不干扰?
- 算力感知路由的PCE集中式计算模型在超大规模网络(数万个算力节点)中如何保证可扩展性?
下篇预告:第297篇:确定性网络(802.1Qbv/TSN)入门