第295篇:算力网络(Computing First Network)概念
关键词:算力网络、Computing First Network、算网融合、算力调度、东数西算、CFN、智能调度
一、引言
在AI大模型、自动驾驶、科学计算等算力密集型应用的驱动下,计算资源的需求呈现指数级增长。然而,算力资源的分布极不均衡——东部沿海地区算力需求旺盛但土地和能源成本高昂,西部地区的能源充沛、土地廉价但本地算力需求有限。"东数西算"工程正是为了解决这一结构性矛盾而提出的国家级战略。
传统的网络架构以"连接"为核心,一切设计围绕如何实现高效、可靠的通信。而算力网络(Computing First Network, CFN)将"算力"作为网络的头等要素,网络的使命从"传输数据"转变为"调度算力"。在这种新范式下,网络需要感知全网算力资源的分布、能力和状态,并根据业务的算力需求智能地将计算任务调度到最优位置。
本文将系统介绍算力网络的核心理念、技术架构和关键使能技术。
二、核心概念
2.1 算力网络的定义
算力网络是将算力和网络深度融合的新型信息基础设施,其核心目标是实现算力的"泛在连接、智能调度、按需服务"。
| 特征 | 传统网络 | 算力网络 |
|---|---|---|
| 核心要素 | 带宽、时延、可靠性 | 算力+带宽+时延+可靠性 |
| 调度对象 | 比特流 | 比特流+计算任务 |
| 资源池 | 网络资源 | 网络资源+计算资源+存储资源 |
| 用户感知 | 网络质量 | 算力服务质量 |
| 定价模式 | 带宽定价 | 算力+网络联合定价 |
2.2 算力网络整体架构
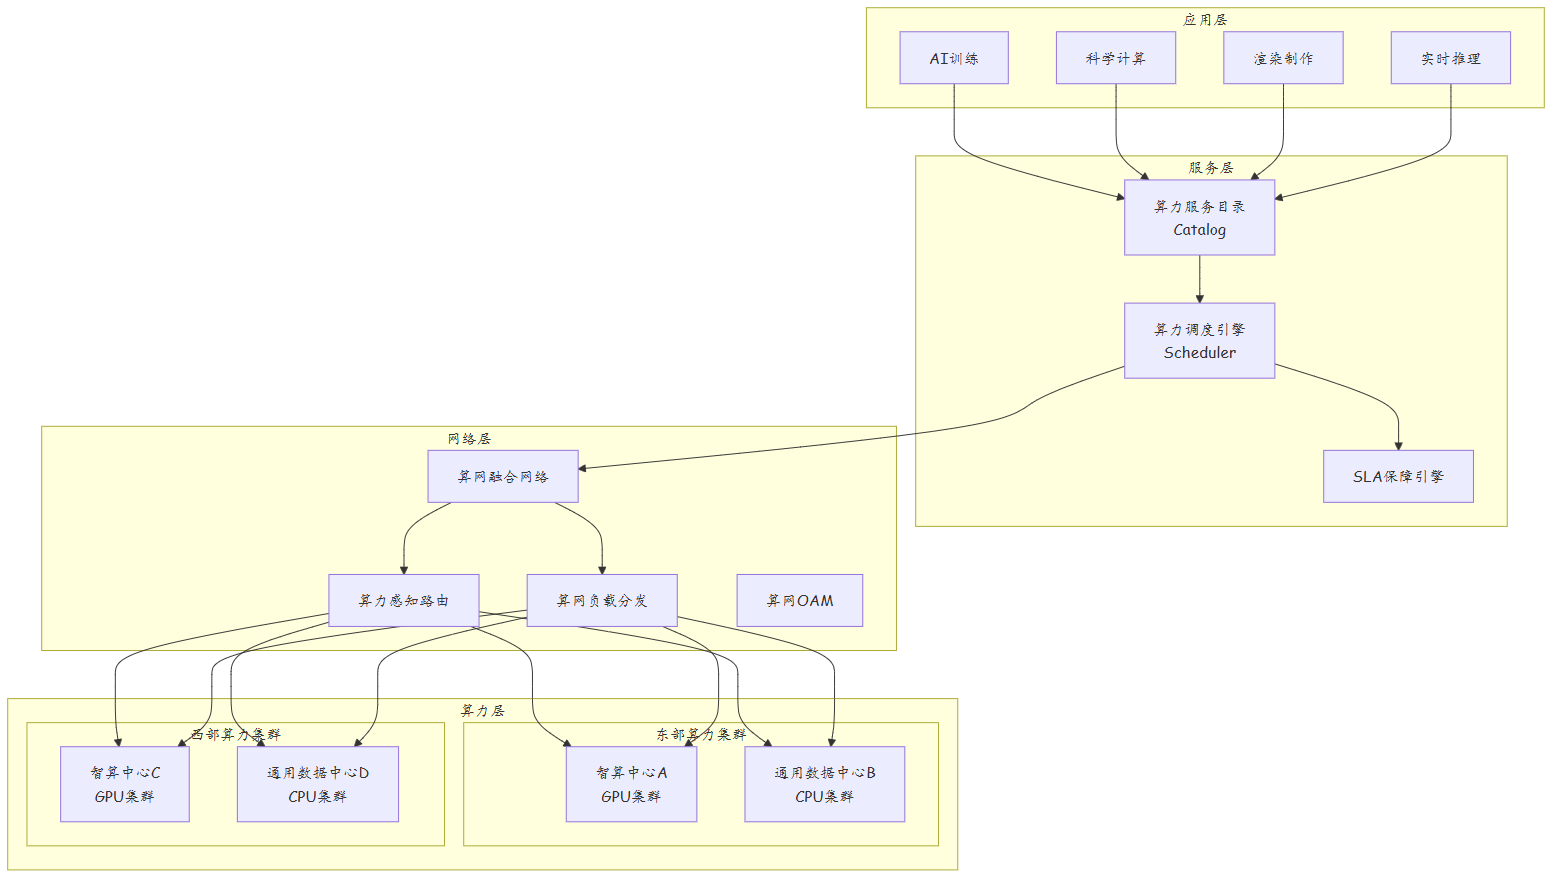
2.3 算力类型与分级
| 算力类型 | 描述 | 典型场景 |
|---|---|---|
| 通用算力(CPU) | 通用计算能力 | 数据库、Web服务、办公 |
| 智能算力(GPU/NPU) | AI训练与推理 | 大模型训练、图像识别 |
| 超级算力(HPC) | 大规模并行计算 | 气象模拟、药物设计 |
| 边缘算力 | 分布式近用户计算 | 自动驾驶、工业控制 |
| 算力等级 | 时延要求 | 带宽要求 | 部署位置 |
|---|---|---|---|
| 实时级 | <1ms | 高 | 边缘节点 |
| 近实时级 | 1-10ms | 高 | 城域中心 |
| 交互级 | 10-100ms | 中 | 区域中心 |
| 批处理级 | >100ms | 中/低 | 超大规模中心 |
2.4 算力度量标准
| 度量维度 | 单位 | 说明 |
|---|---|---|
| 算力规模 | FLOPS | 每秒浮点运算次数 |
| 存储容量 | TB/PB | 数据存储总量 |
| 存储IOPS | IOPS | 每秒输入输出操作数 |
| 网络带宽 | Gbps/Tbps | 互联带宽 |
| 能效比 | FLOPS/W | 每瓦特功耗的算力输出 |
| 综合算力指数 | CPI | Computing Power Index(标准化指数) |
三、技术细节
3.1 算力描述模型
算力网络需要一种统一的语言来描述全网算力资源。算力描述模型(Computing Resource Descriptor)定义了算力资源的属性、能力和状态:
{
  "resource_id": "DC-CHINA-WEST-001",
  "resource_type": "computing_cluster",
  "location": {
    "region": "Guizhou",
    "coordinates": {"lat": 26.58, "lon": 106.71}
  },
  "capacity": {
    "cpu": {
      "total_cores": 65536,
      "available_cores": 24576,
      "type": "x86_64",
      "frequency_ghz": 2.8
    },
    "gpu": {
      "total_units": 4096,
      "available_units": 1536,
      "type": "NVIDIA_A100",
      "memory_gb": 80,
      "fp16_tflops": 312
    },
    "storage": {
      "total_tb": 10000,
      "available_tb": 4500,
      "type": "NVMe_SSD"
    }
  },
  "network": {
    "uplink_bandwidth_gbps": 400,
    "available_bandwidth_gbps": 120,
    "latency_to_east_ms": 25,
    "supported_protocols": ["RoCEv2", "TCP/IP", "gRPC"]
  },
  "energy": {
    "pdu": 1.2,
    "power_capacity_mw": 50,
    "available_power_mw": 15,
    "renewable_ratio": 0.85
  },
  "sla": {
    "availability": "99.99%",
    "max_concurrent_users": 1000
  }
}
3.2 算力服务目录(Computing Service Catalog)
算力服务目录是算力网络的"黄页",集中管理全网算力资源的注册、查询和发现:
| 目录功能 | 说明 |
|---|---|
| 资源注册 | 各算力中心定期上报资源能力和状态 |
| 资源查询 | 用户按算力类型、容量、位置等条件查询 |
| 资源推荐 | 根据业务需求智能推荐最优算力资源 |
| 状态监控 | 实时监控算力资源的运行状态和利用率 |
| 容量预测 | 基于历史数据预测未来资源需求 |
3.3 算力调度策略
| 调度策略 | 决策因子 | 适用场景 |
|---|---|---|
| 最短时延优先 | 网络时延、计算时延 | 实时推理、交互式应用 |
| 最低成本优先 | 算力单价、网络费用 | 离线训练、批量处理 |
| 负载均衡优先 | 各节点负载率 | 多租户共享算力 |
| 能效优先 | PUE、单位算力能耗 | 绿色数据中心 |
| 数据亲和优先 | 数据位置、传输量 | 大数据处理 |
3.4 算网融合网络架构
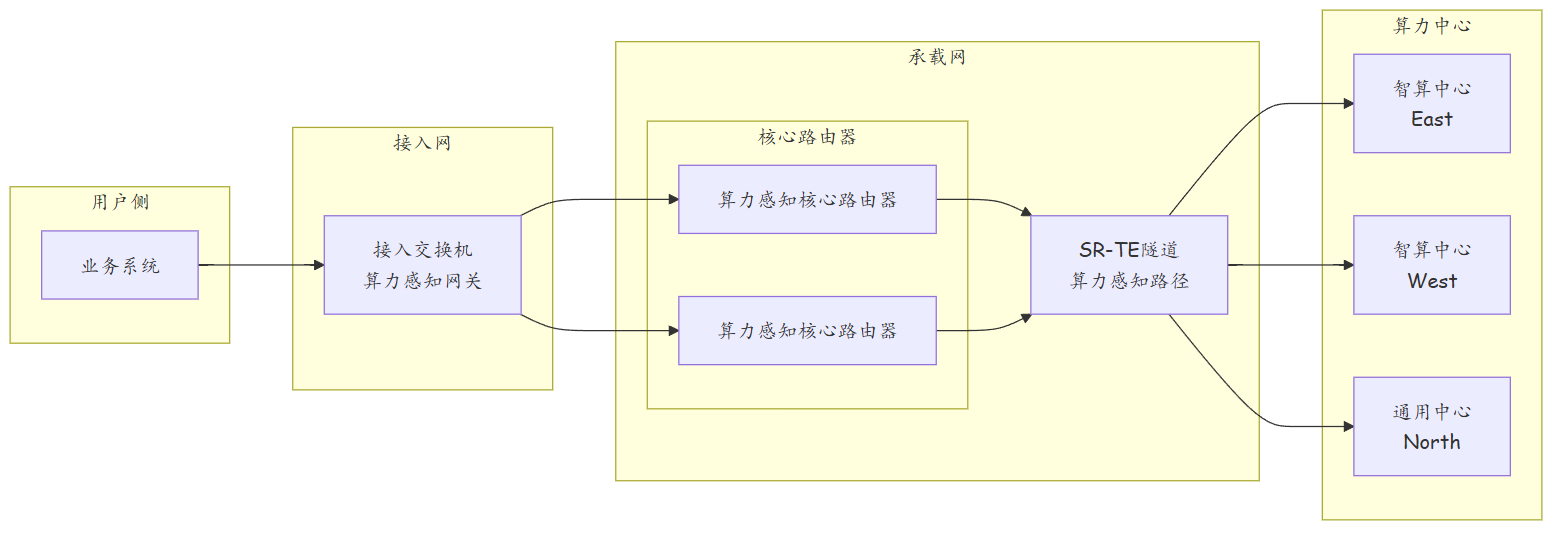
四、实战配置/案例分析
4.1 华为 iMaster NCE 算力网络管理配置
# ============================
# 算力资源注册(NCE控制器)
# ============================

# 1. 注册算力中心
POST /nca/v1/computing-clusters
{
  "cluster_name": "Guizhou_AICenter_01",
  "cluster_type": "AI_Training",
  "location": "Guizhou",
  "capacity": {
    "gpu_type": "Ascend_910B",
    "gpu_count": 4096,
    "fp16_tflops": 312
  },
  "network_uplink": "400GE",
  "energy_pdu": 1.15
}

# 2. 配置算力感知路由策略
# 在核心路由器上部署算力感知BGP扩展
router bgp 65001
 # BGP-LS扩展:发布算力资源信息
 bgp ls enable
  computing-resource advertisement enable
  resource-type gpu-cpu-storage
  advertisement-interval 60

 # 算力感知路由策略
 route-policy COMPUTING-AWARE permit 10
  if computing-delay lt 10ms and gpu-available gt 100
   apply next-hop compute-optimal
  if-end
 route-policy COMPUTING-AWARE permit 20
  if computing-cost lt threshold
   apply next-hop cost-optimal
  if-end

# 3. 配置算力调度策略
# 用户提交算力请求
POST /nca/v1/computing-scheduling
{
  "request_id": "JOB-20240101-001",
  "application_type": "AI_Training",
  "resource_requirement": {
    "gpu_type": "Ascend_910B",
    "gpu_count": 512,
    "memory_gb": 4096,
    "storage_tb": 100
  },
  "sla_requirement": {
    "max_latency_ms": 50,
    "min_bandwidth_gbps": 100,
    "availability": "99.9%"
  },
  "scheduling_policy": "latency_first"
}
4.2 案例分析:东数西算跨区域算力调度
场景描述:某AI公司需要在西部算力中心训练一个千亿参数的大语言模型,训练数据存储在东部数据中心。
调度决策:
| 决策维度 | 分析 |
|---|---|
| 算力需求 | 512个GPU节点,训练周期约2周 |
| 数据量 | 原始数据100TB,预处理后500TB |
| 东部方案 | 时延低但GPU资源紧张,排队等待3个月 |
| 西部方案 | GPU资源充足,但数据传输耗时和成本高 |
| 最终方案 | 数据预迁移至西部 + 西部训练 + 增量数据实时更新 |
实施步骤:
# 1. 预迁移阶段:利用夜间低峰期通过高速专线迁移基础数据
# 专线带宽: 100Gbps
# 数据传输量: 500TB
# 预计时间: 500TB / 100Gbps / 3.6 ≈ 139小时 ≈ 5.8天

# 2. 训练阶段:在西部算力中心启动分布式训练
# GPU集群: 512 × Ascend 910B
# 训练框架: MindSpore分布式训练
# 预期训练时间: 12-14天

# 3. 增量更新:训练过程中持续从东部同步增量数据
# 增量数据: 约10TB/天
# 专线带宽预留: 10Gbps持续同步
效果评估:
| 指标 | 东部训练 | 西部调度 |
|---|---|---|
| GPU资源等待 | 3个月排队 | 即时可用 |
| 数据传输成本 | 无需传输 | 约15万元(专线) |
| 训练周期 | 14天 | 14天 + 6天预迁移 |
| 总成本 | 高(GPU溢价) | 低(西部GPU成本约60%) |
| 碳排 | 高(东部PUE 1.5) | 低(西部PUE 1.15) |
4.3 故障案例:算力调度失败导致业务中断
故障现象:某金融公司的实时风控推理服务频繁超时,推理时延从正常的5ms飙升至200ms以上。
排查过程:
# 1. 检查算力调度状态
GET /nca/v1/scheduling/JOB-RISK-001
{
  "status": "degraded",
  "allocated_cluster": "DC-EAST-02",
  "actual_latency_ms": 205,
  "expected_latency_ms": 5,
  "issue": "cross_region_fallback"
}

# 2. 分析调度决策日志
# 原计划调度到西部集群(WDC-01)
# 因WDC-01的跨域链路拥塞
# 调度引擎自动切回到东部集群(EDC-02)
# 但EDC-02的GPU资源已满载
# 导致推理任务排队等待

# 3. 检查跨域链路状态
display interface 400GE1/0/1 statistics
# 利用率: 96%(严重拥塞)
# 丢包率: 0.5%(导致传输重传)
根因:调度引擎的容灾切换逻辑存在缺陷。当首选的西部集群跨域链路拥塞时,自动切回到东部集群,但调度引擎没有检查东部集群的GPU资源是否充足,导致推理任务堆积超时。
解决措施: 1. 优化调度引擎的容灾逻辑,切换前验证备用集群的资源可用性 2. 引入多路径传输,为算力调度提供冗余的跨域链路 3. 建立算力资源的弹性伸缩机制,在高峰时段动态扩容
五、总结
| 算力网络能力 | 技术支撑 | 价值 |
|---|---|---|
| 算力发现 | 算力描述模型+服务目录 | 全网算力一目了然 |
| 智能调度 | 多目标优化算法 | 最优资源匹配 |
| 算力感知路由 | BGP扩展+SR-TE | 算力导向的网络转发 |
| SLA保障 | 端到端QoS+弹性扩容 | 业务级质量承诺 |
| 能效优化 | 绿色调度+PUE管理 | 降低碳排和运营成本 |
| 部署建议 | 说明 |
|---|---|
| 统一描述模型 | 采用标准化的算力描述模型 |
| 分阶段建设 | 先实现算力发现,再逐步增加调度能力 |
| 多目标权衡 | 在时延、成本、能效之间找到平衡点 |
| 弹性架构 | 算力资源支持动态伸缩 |
| 安全隔离 | 多租户算力资源的安全隔离 |
思考
- 算力网络将网络的核心使命从"传输"转变为"调度",这对传统网络运营商的业务模式和商业模式带来了哪些挑战?
- 在算力调度中,如何量化和比较不同类型算力(CPU/GPU/NPU)的"等效算力"?
- 算力和网络的融合调度涉及多个域(计算、存储、网络),如何实现跨域的端到端SLA保障?
下篇预告:第296篇:算力感知路由与负载分发