第269篇:NVMe over Fabric 协议演进
关键词:NVMe、NVMe-oF、传输协议、RoCE、FC、TCP、性能对比、存储网络
一、引言
NVMe(Non-Volatile Memory Express)协议是为固态存储(SSD/NVMe)设计的高性能接口协议。传统的SATA/SAS协议是为机械硬盘设计的,其命令队列深度和延迟已无法满足NVMe SSD的性能需求。
当NVMe SSD需要通过网络共享时(而不是通过本地PCIe总线),NVMe over Fabric(NVMe-oF)协议应运而生。NVMe-oF将NVMe命令封装在不同的传输协议上,实现了网络化的NVMe存储访问。
二、核心概念
2.1 NVMe 协议基础
NVMe的核心特性:
| 特性 | SATA/AHCI | NVMe |
|---|---|---|
| 命令队列 | 1个队列, 深度32 | 65535个队列, 每队列深度65535 |
| 命令处理 | 串行 | 并行 |
| 延迟 | 较高(软件开销大) | 极低(零拷贝) |
| 中断机制 | 每命令中断 | 中断合并 |
| 最大带宽 | 6Gbps(SATA3) | 数十Gbps(PCIe 4.0/5.0) |
NVMe架构组件:
| 组件 | 说明 |
|---|---|
| NVMe Controller | NVMe控制器,管理命名空间和命令队列 |
| Namespace | 命名空间,逻辑存储单元 |
| Submission Queue | 提交队列,主机提交I/O请求 |
| Completion Queue | 完成队列,控制器返回I/O结果 |
| Admin Queue | 管理队列,配置和管理操作 |
2.2 NVMe-oF 传输协议
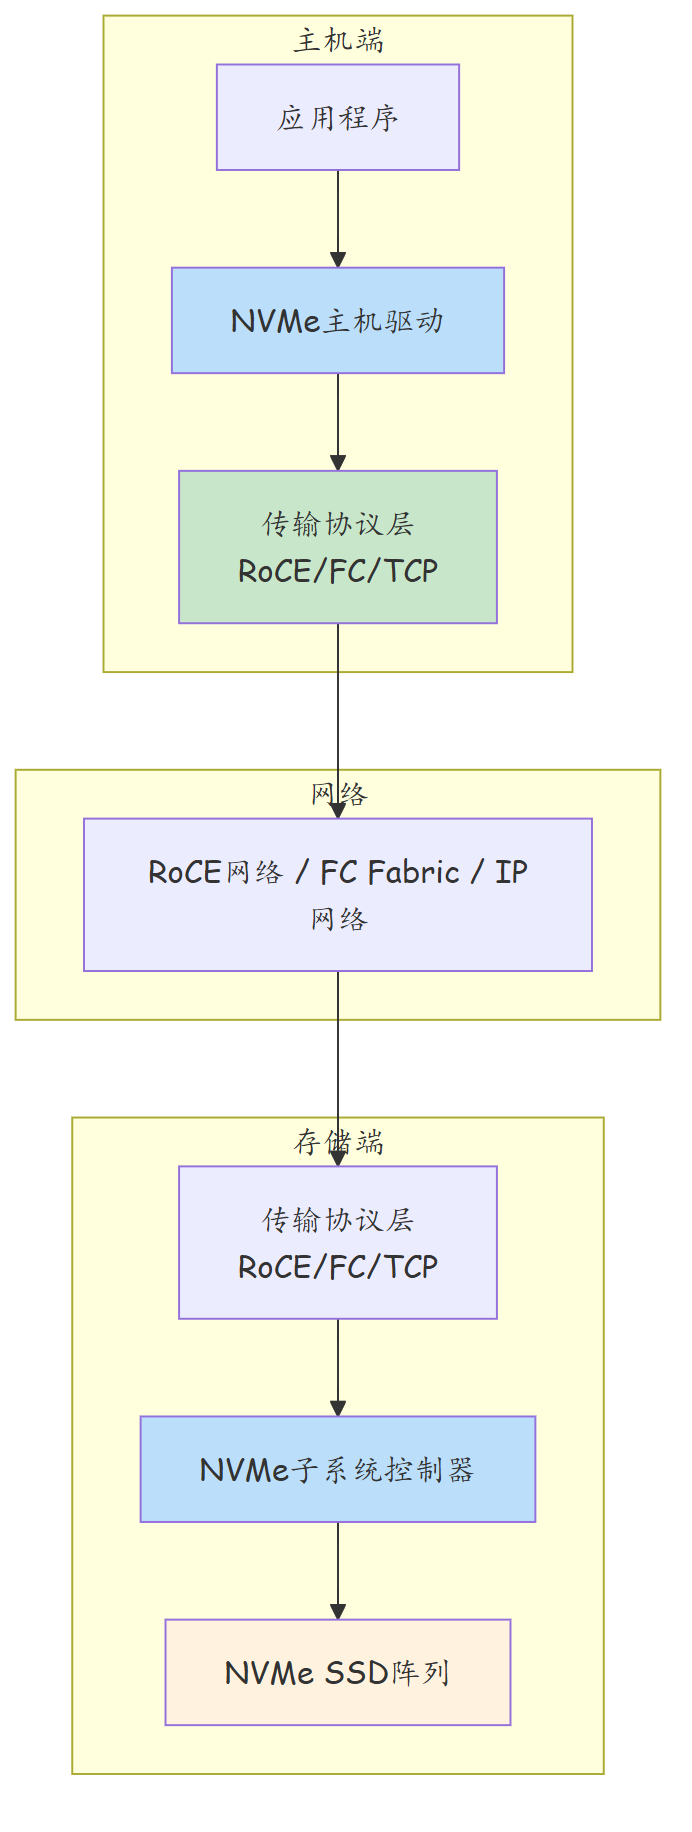
NVMe-oF支持三种传输协议:
| 传输协议 | 全称 | 特性 | 延迟 | 适用场景 |
|---|---|---|---|---|
| RoCE | RDMA over Converged Ethernet | 低延迟, 需要无损网络 | 最低 | AI/HPC/高性能计算 |
| FC | Fibre Channel | 成熟可靠, 专用存储网络 | 低 | 企业SAN |
| TCP | TCP/IP | 通用, 无需特殊网络 | 中 | 通用云存储 |
2.3 NVMe-oF 架构
三、技术细节
3.1 RoCE 传输
RoCE传输的特点: - 使用RDMA技术,实现零拷贝和低CPU开销 - 需要无损以太网(PFC + ECN + DCQCN) - 延迟最低,性能最优 - UDP端口4791(RoCEv2)
RoCE传输的性能优势:
| 指标 | TCP | RoCE |
|---|---|---|
| 延迟 | 5-20μs | 1-5μs |
| CPU利用率 | 高 | 极低 |
| 带宽效率 | 70-85% | 90-95% |
| 网络要求 | 标准以太网 | 无损以太网 |
3.2 FC 传输
FC传输的特点: - 基于成熟的FC SAN基础设施 - 使用FC-4映射层承载NVMe命令 - 需要FC HBA和FC交换机 - 延迟低,可靠性高
FC NVMe的要求: - FC交换机支持NVMe over FC(FC-NVMe) - HBA支持NVMe over FC - 存储阵列支持NVMe over FC
3.3 TCP 传输
TCP传输的特点: - 基于标准TCP/IP网络,无需特殊硬件 - 兼容性好,任何支持TCP的设备均可使用 - 延迟和CPU开销高于RoCE - 适合云环境和通用场景
TCP传输的优化: - 启用TCP Offload Engine(TOE)降低CPU开销 - 使用Jumbo Frame减少分片 - 启用TCP Chimney Offload
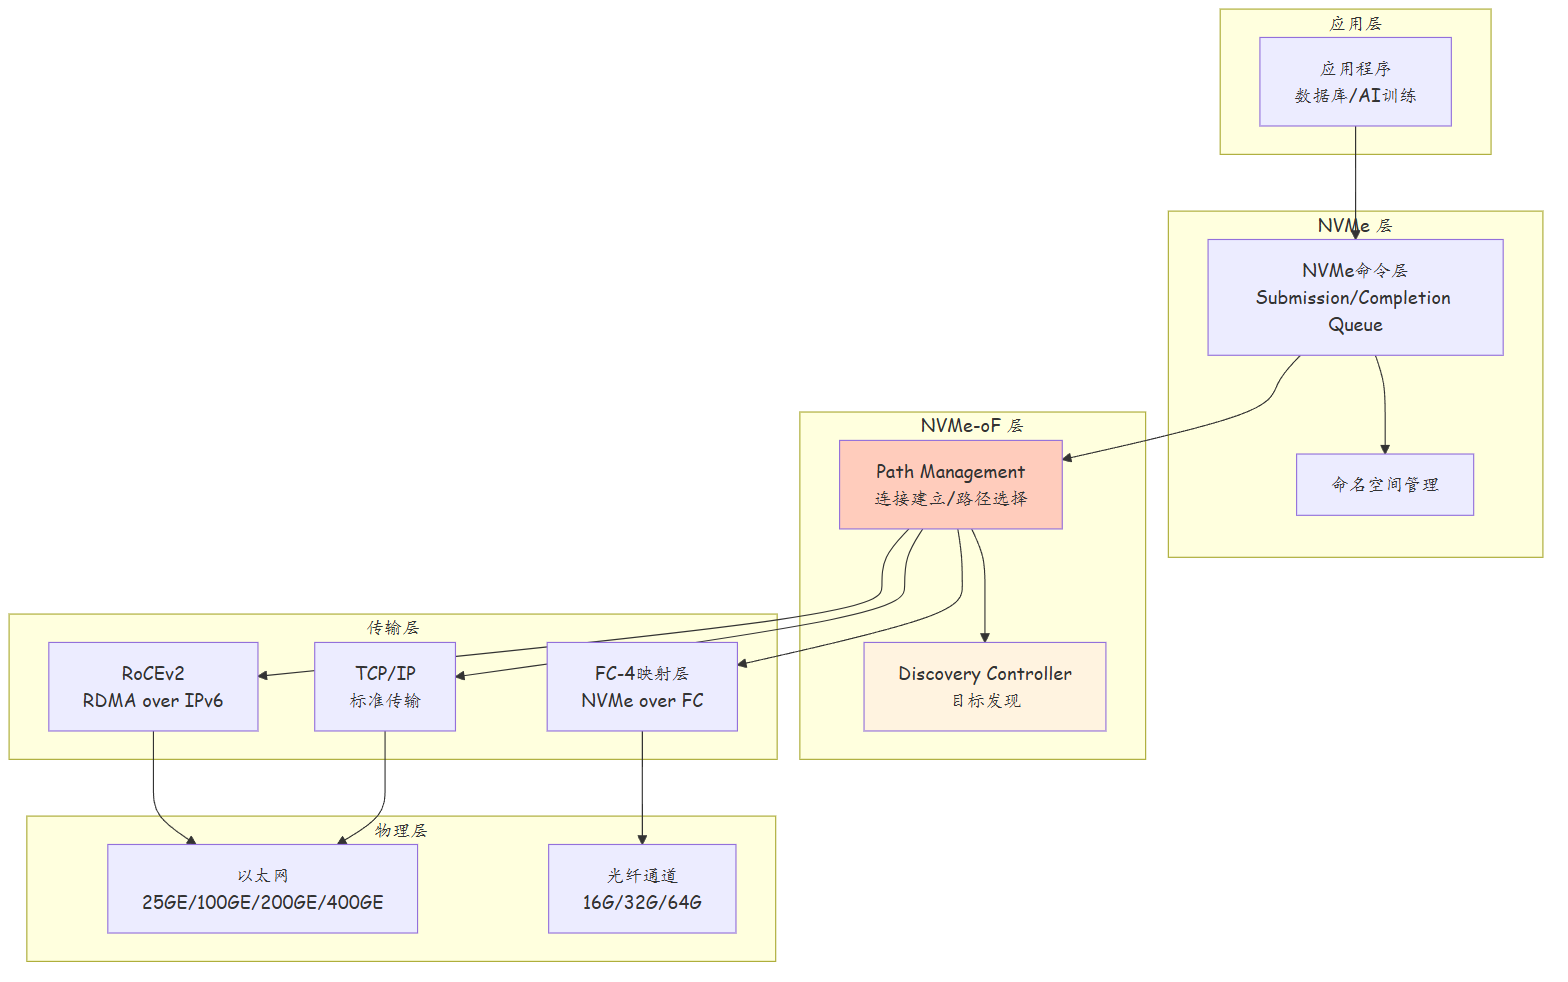
3.4 NVMe-oF 协议栈分层架构
NVMe-oF采用了清晰的分层设计,将NVMe命令层与传输层解耦:
3.5 NVMe-oF 发现机制(Discovery)
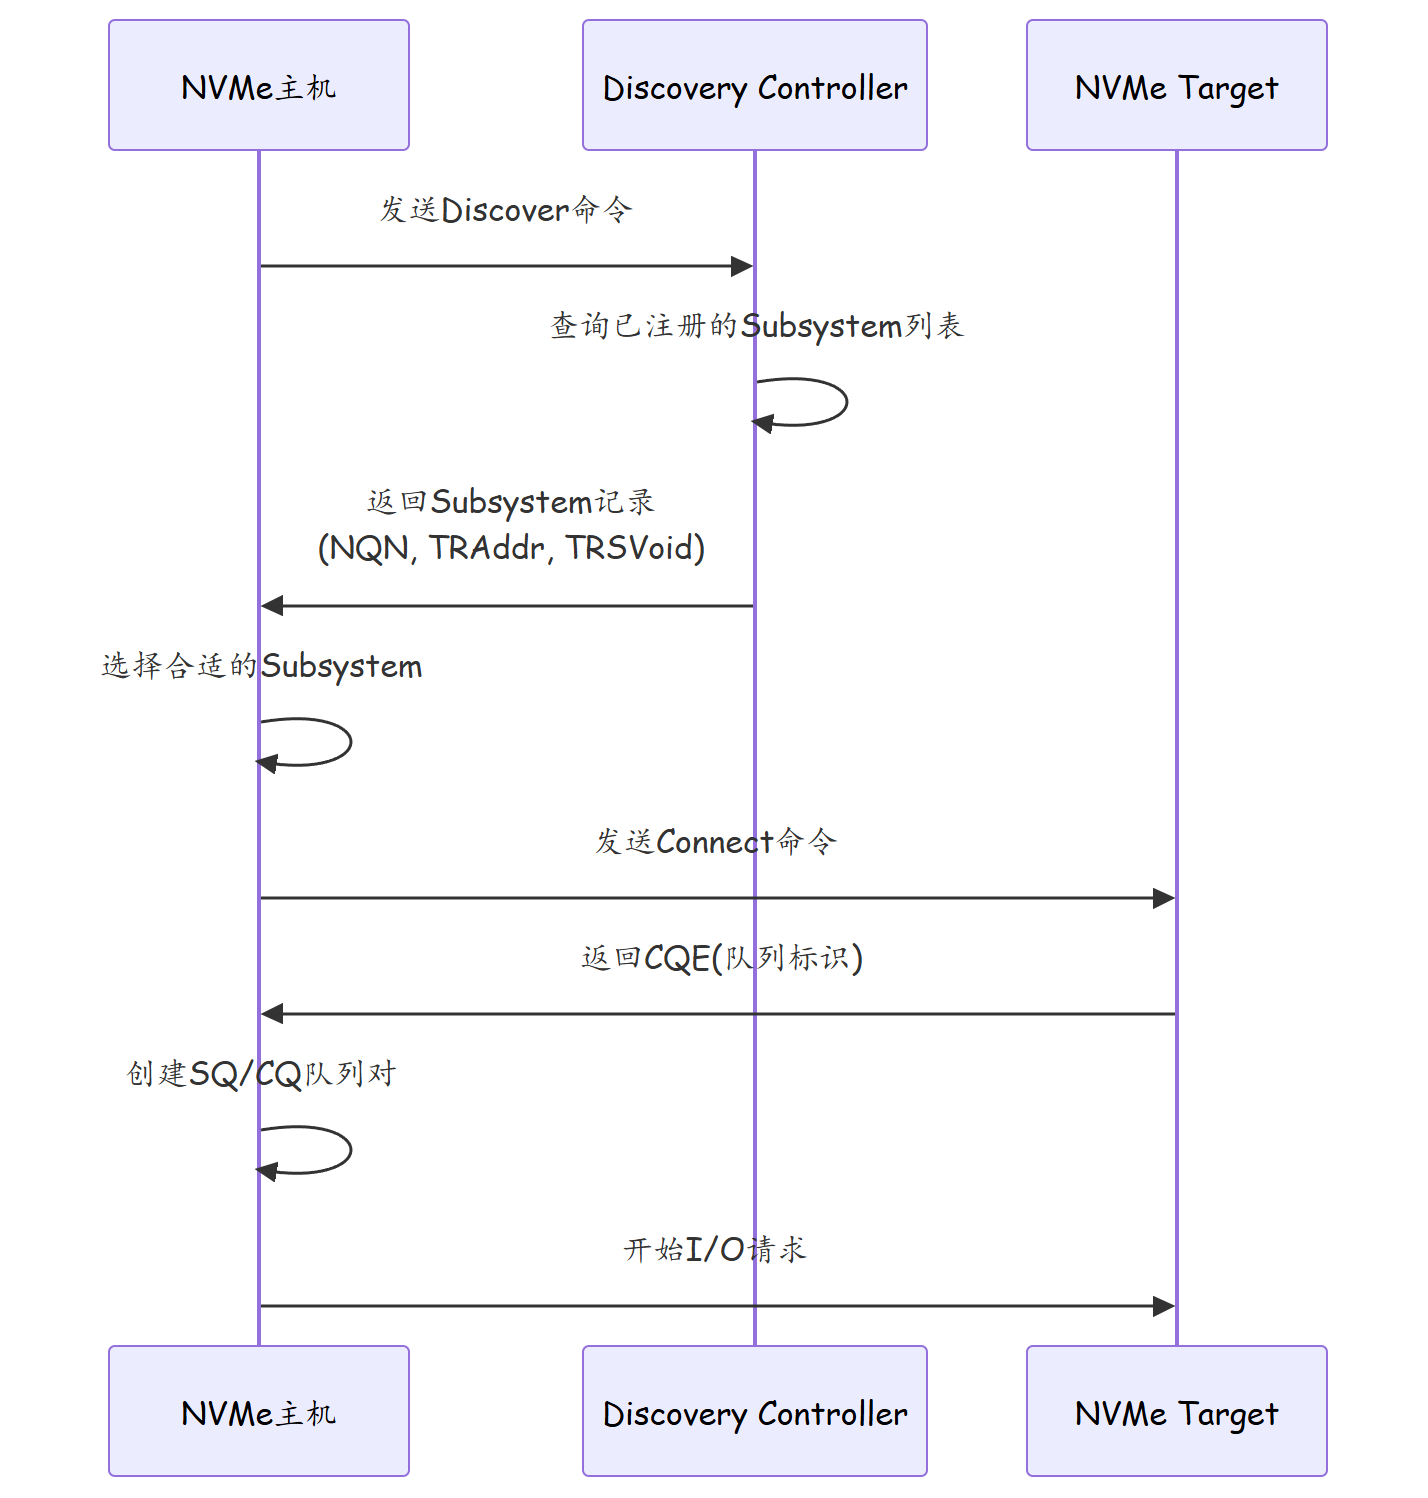
NVMe-oF使用Discovery Controller实现存储目标的自动发现:
| 发现模式 | 说明 | 适用场景 |
|---|---|---|
| 手动配置 | 手动指定Target地址和NQN | 小规模/测试环境 |
| Discovery Controller | 主机自动发现可用的NVMe-oF Target | 大规模生产环境 |
| DNS-SD | 通过DNS服务发现协议解析Target | 云环境动态发现 |
Discovery流程:
3.6 NVMe-oF 多路径与高可用
NVMe-oF支持多路径(Multipath)实现高可用和负载均衡:
| 多路径特性 | 说明 | 实现方式 |
|---|---|---|
| 路径冗余 | 多条路径同时可达同一Target | 双端口HBA+双交换机 |
| 负载均衡 | I/O请求在多条路径间分担 | 轮询/最少队列/哈希 |
| 故障切换 | 主路径故障时自动切换到备路径 | 路径健康检测+自动重连 |
| 路径优先级 | 不同路径可配置不同优先级 | 本地PCIe优先于远程 |
多路径配置示例:
# Linux multipath配置
# /etc/multipath.conf
defaults {
    user_friendly_names yes
    find_multipaths yes
}

devices {
    device {
        vendor "NVME"
        product "NVMe"
        path_selector "service-time 0"
        path_grouping_policy multibus
        failback immediate
        no_path_retry 5
        rr_min_io_rq 1
        detect_prio yes
        prio nvme
        detect_checker yes
        checker nvme
    }
}
3.7 NVMe-oF 传输协议演进路线
| 时间线 | 里程碑 | 意义 |
|---|---|---|
| 2011 | NVMe 1.0发布 | PCIe本地SSD接口标准 |
| 2016 | NVMe-oF 1.0 | 首次支持RoCE/FC/TCP传输 |
| 2017 | NVMe 1.2 | 支持命名空间共享、持久保留 |
| 2019 | NVMe 1.3 | 支持ZNS(分区命名空间) |
| 2021 | NVMe 2.0 | 重大更新:支持CVM、虚拟化管理 |
| 2022 | NVMe 2.0.1 | 管理接口增强、安全增强 |
| 2023 | NVMe 2.1 | 支持存储级编排、远程管理 |
3.8 三种传输协议适用场景深度分析
| 决策维度 | RoCE优选条件 | FC优选条件 | TCP优选条件 |
|---|---|---|---|
| 延迟要求 | <5μs极致延迟 | <10μs低延迟 | <20μs可接受 |
| 网络基础 | 新建/可改造网络 | 已有FC SAN | 通用IP网络 |
| 运维能力 | 具备无损网络调优能力 | 具备FC运维经验 | 标准网络运维 |
| 预算约束 | 中档(RoCE NIC) | 高(FC全链路) | 低(标准NIC) |
| 规模 | 百节点AI集群 | 千LUN企业SAN | 万节点云平台 |
| 协议栈成熟度 | NVMe-oF RoCE 1.1 | NVMe/FC 2.0 | NVMe/TCP 1.1 |
四、实战配置/案例分析
4.1 华为NVMe-oF 部署架构
方案:NVMe over RoCEv2
某企业部署AI训练平台,选择NVMe over RoCEv2作为存储网络:
组网: - 计算节点:GPU服务器,配备RoCEv2网卡(2×200GE) - 存储节点:华为OceanStor存储,支持NVMe-oF - 网络:CloudEngine交换机,配置无损以太网
4.2 华为OceanStor NVMe-oF 配置
# OceanStor NVMe-oF 配置
#
# 1. 启用NVMe-oF协议
protocol nvme_of
 enable transport=roce
#
# 2. 配置NVMe子系统
nvme_subsystem
 create subsystem_name=NVME-SS-01
 add port transport=roce traddr=192.168.200.10 trsvcid=4420
#
# 3. 创建命名空间
namespace
 create ns_id=1 subsystem=NVME-SS-01 lmap=lun_0
#
# 4. 配置主机连接
nvme_host
 create host_name=GPU-Server-01
 add host_nqn=nqn.2024-01.com.huawei:gpu-server-01
 connect subsystem=NVME-SS-01
4.3 性能测试与调优
性能测试方法:
# 使用fio进行NVMe-oF性能测试
fio --name=nvme-of-test \
    --filename=/dev/nvme0n1 \
    --rw=randread \
    --bs=4k \
    --direct=1 \
    --numjobs=64 \
    --time_based \
    --runtime=60 \
    --group_reporting \
    --output-format=json
调优要点:
| 调优项 | 推荐配置 | 说明 |
|---|---|---|
| 队列深度 | 1024-4096 | 根据SSD性能调整 |
| 队列数 | 与CPU核心数匹配 | 最大化并行度 |
| MTU | 9000(Jumbo Frame) | 减少分片开销 |
| RoCE Pkey | 0xFFFF | 确保RoCE通信 |
| 网络队列 | 多队列RSS | 均衡CPU负载 |
4.4 故障案例:NVMe-oF连接超时
现象:GPU服务器无法连接到NVMe-oF存储,系统日志显示"NVMe connect timeout"。
排查过程:
# 1. 检查网络连通性
ping 192.168.200.10
# Ping通, 网络层正常

# 2. 检查RoCE连通性
rdma link show
# RoCE端口状态Up, 但QP(队列对)未建立

# 3. 检查RoCE子网管理器
ibstat
# Subnet Manager正常运行

# 4. 检查存储端NVMe-oF端口
# 存储端NVMe-oF端口配置的TRADDR与主机端不匹配

# 5. 检查防火墙/ACL
# UDP 4420端口(NVMe-oF默认)被防火墙拦截
根因:安全策略中未放行NVMe-oF的UDP 4420端口,导致NVMe连接请求被防火墙丢弃。
解决:
1. 在防火墙上放行UDP 4420端口(NVMe-oF默认端口)
2. 确认存储端和主机端的NVMe-oF端口配置一致
3. 使用nvme discover命令验证NVMe-oF目标发现
五、总结
| 传输协议 | 延迟 | 成本 | 部署难度 | 推荐场景 |
|---|---|---|---|---|
| RoCE | 最低 | 中 | 高 | AI/HPC/高性能 |
| FC | 低 | 高 | 中 | 企业SAN |
| TCP | 中 | 低 | 低 | 云存储/通用 |
| NVMe-oF关键能力 | 说明 |
|---|---|
| 高并发 | 65535个命令队列 |
| 低延迟 | 微秒级响应 |
| 并行处理 | 多队列并行I/O |
| 网络扩展 | 打破PCIe物理限制 |
| 发现机制 | Discovery Controller自动发现 |
| 多路径 | 冗余+负载均衡+故障切换 |
思考
- NVMe-oF的TCP传输协议延迟明显高于RoCE,为什么仍然有云服务商选择TCP方案?
- NVMe over FC和NVMe over RoCE在性能上差距有多大?什么场景下FC传输仍然有竞争力?
- NVMe-oF的队列深度可以达到65535,实际应用中应该配置多少队列深度?如何确定最佳值?
- NVMe-oF的Discovery Controller机制如何实现存储目标的自动发现?与传统的iSCSI目标发现有什么区别?
- 在多路径NVMe-oF部署中,路径优先级(本地PCIe优先于远程)的设计思路是什么?如何配置路径切换策略?
下篇预告:第270篇:NVMe over RoCEv2 部署案例