第252篇:Spine-Leaf 架构原理:为什么取代三层架构
关键词:Spine-Leaf、CLOS网络、无阻塞条件、等径转发、故障域隔离、Pod扩展、华为CloudEngine
一、引言
第251篇中,我们梳理了数据中心网络从传统三层架构向Spine-Leaf架构演进的宏观脉络。我们看到,流量模型从南北向为主转变为东西向为主,是驱动架构变革的根本动力。但仅了解"发生了什么"还不够——工程师需要深入理解Spine-Leaf"为什么能行",以及它的每一条设计原则背后隐藏的技术取舍。
本文将以CLOS网络定理为起点,从数学和协议两个层面剖析Spine-Leaf的核心原理:无阻塞条件究竟如何计算、等径转发如何支撑ECMP、故障域如何被限制在最小范围、以及当单Pod端口耗尽时如何通过多Pod(Multi-Pod)扩展继续横向扩容。
二、Spine-Leaf 的核心设计原则
2.1 原则一:Leaf之间不互联(Leaf-to-Leaf No Interconnect)
在传统三层架构中,汇聚层交换机之间通常通过Trunk链路互联,作为冗余路径或负载分担手段。但在Spine-Leaf架构中,Leaf之间严格禁止任何直接互联。
这一原则的原因有三:
- 消除次优路径:如果Leaf A与Leaf B直连,那么从Leaf A到Leaf C的流量可能走Leaf A→Leaf B→Spine→Leaf C(3跳),而非Leaf A→Spine→Leaf C(2跳)。这将破坏Spine-Leaf的等径特性。
- 避免二层环路:Leaf间互联一旦误配为二层Trunk,结合M-LAG或其他二层扩展技术,极易引发环路。
- 简化运维模型:Leaf间不互联意味着所有东西向流量路径均可预测——必定经过且仅经过一台Spine。这种确定性极大地简化了故障排查和性能分析。
2.2 原则二:Spine之间不互联(Spine-to-Spine No Interconnect)
Spine交换机之间同样不建立任何直接链路。这与传统核心层"两台核心互联做VRRP/堆叠"的思路截然相反。
Spine不互联的设计逻辑: - 每台Leaf与所有Spine全互联,已经提供了N条等价路径(N=Spine数量) - Leaf之间的流量通过ECMP在N条Spine路径上分担,无需Spine间链路做备份 - Spine间链路反而可能引入非对称路由——Leaf A→Spine1→Spine2→Leaf B的路径与Leaf B→Spine3→Leaf A的回程路径不一致
2.3 原则三:全互联(Full-Mesh Connectivity)
每台Leaf与所有Spine必须建立物理连接。这是Spine-Leaf架构得以成立的前提条件。
为什么是全互联而非部分互联?
假设只有4台Spine和4台Leaf,但每台Leaf只连接2台Spine(非全互联),则: - Leaf1连接Spine1和Spine2 - Leaf3连接Spine3和Spine4 - Leaf1到Leaf3之间没有任何共同Spine,通信将中断
全互联保证了任意Leaf之间的任意一对Leaf都共享所有Spine作为共同转发节点,因此不存在"可达但无路径"的情况。
2.4 原则四:等臂路由(Equal-Cost Paths)
Spine-Leaf要求所有Leaf到Leaf的转发路径具有相同的路由度量(Metric)。在路由协议层面,这意味着: - 如果使用OSPF,所有Spine-Leaf互联链路的OSPF Cost必须一致 - 如果使用IS-IS,所有链路的IS-IS Metric必须一致 - 如果使用iBGP,所有Spine-Leaf直连路由的IGP Cost必须一致
等臂路由是ECMP生效的前提。如果路径不等价,路由器只会选择最优路径(单路径),其余路径沦为备份,ECMP的带宽聚合效果将荡然无存。
三、无阻塞条件与规模计算
3.1 Clos 无阻塞定理的推导
从Clos网络的三级结构出发,设: - n = 每台输入级交换机的输入端口数(即下连服务器数) - r = 每台输入级交换机连接到中间级交换机的链路数(即Spine数) - m = 每台中间级交换机的输入端口数(即每台Spine连接的Leaf数)
严格无阻塞条件:m ≥ 2n - 1
但在Spine-Leaf的实际场景中,我们关注的是上行带宽无阻塞,其条件简化为:
每台Leaf的上行链路带宽之和 ≥ 该Leaf下连服务器的最大可能聚合带宽
用更工程化的方式表达:
Spine数量 × Leaf单条上行链路带宽 ≥ Leaf下连服务器的总带宽需求
3.2 实际计算案例
场景:某数据中心Leaf层使用CloudEngine 6865(48×25GE + 6×100GE),每台Leaf连接48台25GE服务器,上行使用4条100GE链路分别连接到4台Spine。
Leaf下行容量:48 × 25GE = 1200 Gbps
Leaf上行容量:4 × 100GE = 400 Gbps
上行/下行比 = 400 / 1200 = 1:3
这意味着Leaf的上行汇聚比为3:1,即当下行服务器同时满速发送时,上行链路将出现拥塞。但从实际流量模型看: - 并非所有服务器同时满速发送 - 东西向流量通过ECMP在4条Spine路径上均匀分布 - 南北向流量占比已降至20%以下
因此3:1的汇聚比在大多数场景下是可接受的。但对于存储密集型场景(如全闪存阵列),可能需要更高的上行带宽比例。
3.3 不同汇聚比的选择策略
| 汇聚比 | Leaf上行带宽/下行带宽 | 适用场景 | 风险 |
|---|---|---|---|
| 1:1 | 上行=下行 | 超融合、全闪存存储 | 端口利用率低,成本高 |
| 1:2 | 上行=下行×50% | 通用计算、容器集群 | 偶发拥塞,需监控 |
| 1:3 | 上行=下行×33% | Web服务、微服务集群 | 高峰时段拥塞风险较高 |
| 1:4 | 上行=下行×25% | 开发测试、批处理 | 不建议用于生产环境 |
四、故障域与可靠性设计
4.1 Spine故障的影响分析
当一台Spine发生故障时: - 经过该Spine的所有ECMP路径立即失效 - BGP或ECMP快速收敛,流量自动重分布到剩余Spine路径 - 剩余Spine的链路带宽负载按比例上升
以4台Spine为例,1台Spine故障后: - ECMP路径从4条降为3条,有效带宽下降25% - 每条存活Spine的流量负载上升约33%(从25%升至33%)
关键结论:Spine-Leaf架构在单Spine故障时不会中断业务,仅降低带宽余量。只要剩余Spine的总带宽能满足业务需求,故障就是透明的。
4.2 Leaf故障的影响分析
Leaf故障的影响范围被限制在该Leaf下挂的服务器: - 该Leaf上的所有服务器暂时失联 - 若使用M-LAG(跨设备链路聚合),服务器通过另一台Leaf恢复连接 - 其他Leaf的流量不受影响
4.3 M-LAG 实现Leaf层冗余
M-LAG(Multi-Chassis Link Aggregation Group)是华为CloudEngine系列实现跨设备链路聚合的技术。两台Leaf通过M-LAG心跳线和系统互联线建立主备关系,下挂服务器可以通过LACP同时连接两台Leaf,实现设备级冗余。
# Leaf-01 和 Leaf-02 配置 M-LAG 系统
# Leaf-01
sysname Leaf-01
mlag domain 1
 mlag-device 1
 system-priority 4096
 local-interface 10GE1/0/49  # M-LAG 心跳线
 peer-ip 10.255.0.2          # Leaf-02 对端IP

# Leaf-02
sysname Leaf-02
mlag domain 1
 mlag-device 2
 system-priority 8192
 local-interface 10GE1/0/49
 peer-ip 10.255.0.1          # Leaf-01 对端IP

# 配置下挂服务器的跨设备 Eth-Trunk
interface Eth-Trunk1
 mlag 100
 mode lacp-static
 trunkport 10GE1/0/1 to 10GE1/0/4
 port link-type access
 port access vlan 100
4.4 故障域隔离总结
| 故障场景 | 影响范围 | 恢复方式 | 恢复时间 |
|---|---|---|---|
| 单台Spine故障 | 全网ECMP路径减少,带宽下降 | BGP/ECMP自动收敛 | 秒级 |
| 单台Leaf故障(无M-LAG) | 该Leaf下挂服务器中断 | 人工恢复或HA切换 | 分钟级 |
| 单台Leaf故障(有M-LAG) | 该Leaf下挂服务器短暂闪断 | M-LAG自动切换 | 亚秒级 |
| Spine-Leaf链路故障 | 单条ECMP路径失效 | ECMP自动重分布 | 毫秒级 |
| 全部Spine故障 | 全网中断 | 需人工干预 | 小时级 |
五、多Pod(Multi-Pod)扩展
5.1 单Pod的扩展瓶颈
单Pod Spine-Leaf架构的扩展上限受限于: - Spine交换机的端口密度(决定了最大Leaf数) - Leaf交换机的上行端口密度(决定了最大Spine数)
当Spine端口耗尽无法连接更多Leaf时,就需要引入第二Pod。
5.2 Pod间互联方案
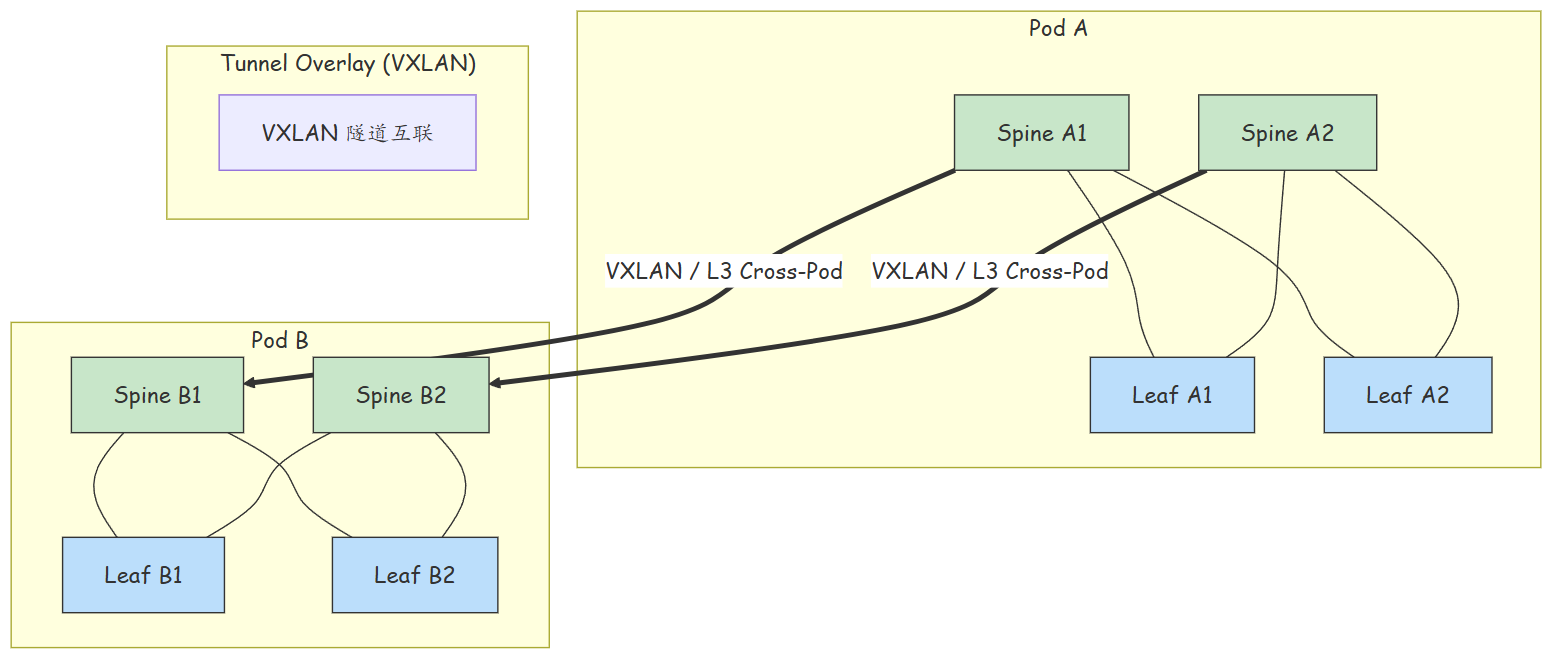
跨Pod互联的两种主流方案:
| 方案 | 实现方式 | 优点 | 缺点 |
|---|---|---|---|
| L3 Cross-Pod | Spine间通过三层路由互联 | 无需Overlay,延迟低 | Spine间需要额外链路 |
| VXLAN Cross-Pod | Spine间建立VXLAN隧道 | 无需额外物理链路 | 增加封装开销和延迟 |
5.3 华为Cross-Pod配置示例
# Spine-01 (Pod A) 配置 Cross-Pod 路由
# 通过 BGP 与 Pod B 的 Spine 建立 eBGP 会话
bgp 65100
 #
 # Pod B Spine 的 eBGP 对等体
 peer 10.255.0.2 as-number 65200
 peer 10.255.0.2 connect-interface 100GE1/0/55
 #
 address-family ipv4 unicast
  peer 10.255.0.2 enable
  # 引入本Pod Leaf的路由到 Pod B
  import-route direct
5.4 ECMP 配置详解
ECMP(等价多路径路由)是Spine-Leaf架构实现负载均衡的核心机制:
# 在Leaf交换机上配置ECMP
# 1. 启用ECMP(华为设备默认支持, 最大路径数可配置)
ip route max-ecmp-path 8

# 2. 确保所有Spine-Leaf链路具有相同的Cost(以OSPF为例)
ospf 1
 area 0.0.0.0
  network 10.0.0.0 0.0.255.255

# 3. 在所有Spine-Leaf互联接口上设置相同的OSPF Cost
interface 100GE1/0/1
 ospf cost 1
interface 100GE1/0/2
 ospf cost 1
interface 100GE1/0/3
 ospf cost 1
interface 100GE1/0/4
 ospf cost 1

# 4. 验证ECMP路由
display ip routing-table protocol ospf
# 应显示到同一目的的多条等价路径

# 5. 配置ECMP哈希算法
# 基于源IP+目的IP+源端口+目的端口五元组哈希
ip hash policy ecmp five-tuple
ECMP哈希算法对比:
| 哈希算法 | 哈希因子 | 负载均衡效果 | 乱序风险 |
|---|---|---|---|
| 目的IP | 仅目的IP | 差(同一目的走同一路径) | 无 |
| 源IP+目的IP | 源+目的IP | 中 | 无 |
| 四元组 | IP+端口 | 好 | 低 |
| 五元组 | IP+端口+协议 | 最佳 | 极低 |
5.5 Spine-Leaf 多层Clos架构
当单Pod无法满足端口需求时,可采用多层Clos(Multi-Tier Clos)扩展:
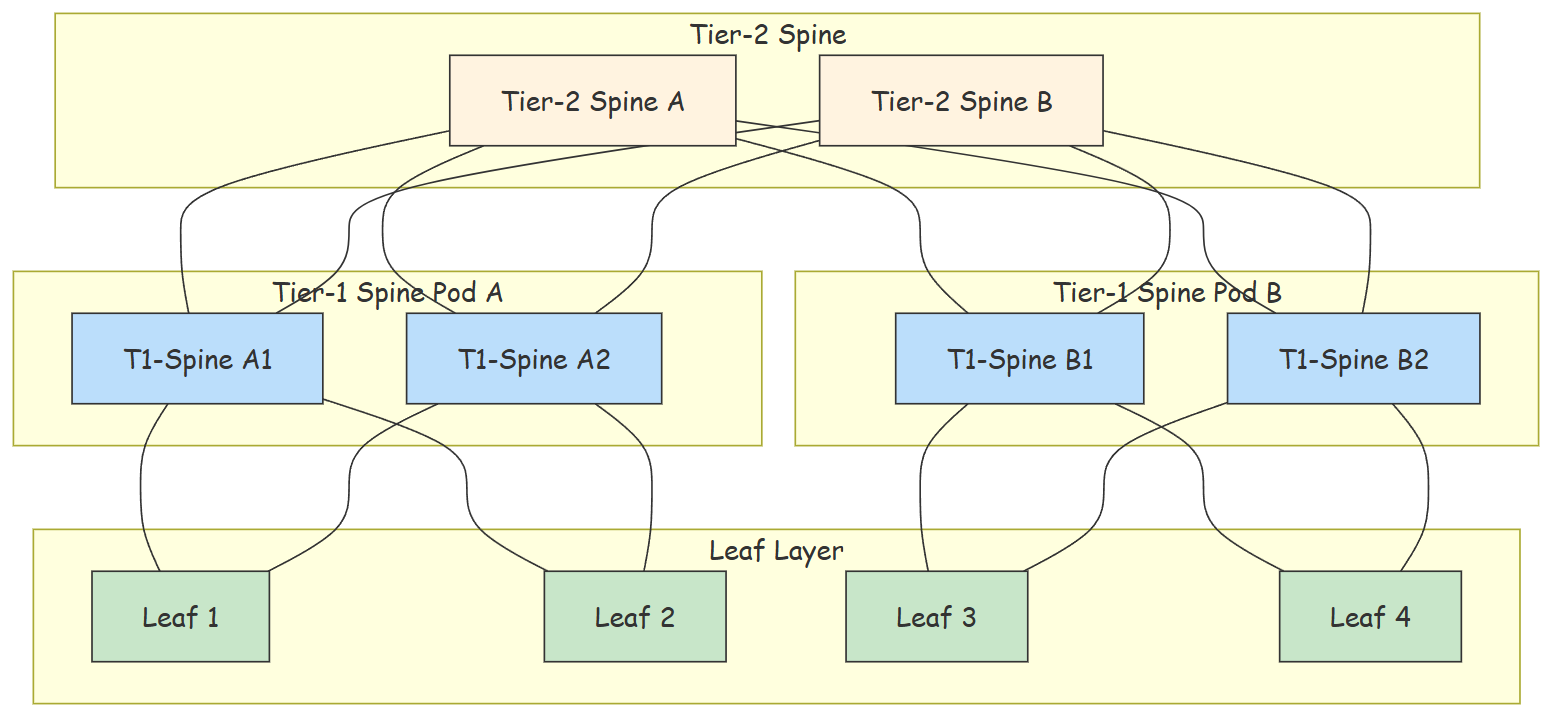
| 架构层级 | 跳数 | 适用规模 | 延迟影响 |
|---|---|---|---|
| 单层Clos(2-tier) | 2跳 | <48 Leaf | 基准延迟 |
| 双层Clos(3-tier) | 4跳 | <192 Leaf | +1跳延迟 |
| 三层Clos(4-tier) | 6跳 | <768 Leaf | +2跳延迟 |
5.6 Spine-Leaf 设计检查清单
| 检查项 | 标准 | 验证方法 |
|---|---|---|
| Leaf全互联 | 每台Leaf连接所有Spine | 物理端口对照表 |
| Spine不互联 | Spine间无直连线 | 端口状态检查 |
| Leaf不互联 | Leaf间无直连线 | 端口状态检查 |
| 等臂路由 | 所有Spine-Leaf链路Cost相同 | 路由表检查 |
| ECMP生效 | 到同一目的存在多条等价路径 | 路由表路径数 |
| MTU一致 | 所有链路MTU=9198 | 接口配置检查 |
| BFD配置 | 所有互联链路启用BFD | BFD会话状态 |
| 环路防护 | 无二层环路风险 | STP/RSTP检查(应禁用) |
| VTEP可达 | 所有VTEP IP互相可达 | Ping测试 |
| EVPN会话 | 所有Leaf-Spine EVPN Established | BGP peer状态 |
六、故障案例:Spine-Leaf架构中的非对称路由
6.1 故障背景
某互联网企业部署了4Spine×8Leaf的Spine-Leaf架构,使用BGP EVPN VXLAN方案。业务上线后,运维团队发现某些VM间的流量出现明显的延迟抖动——部分报文延迟稳定在100μs以内,另一些报文延迟跃升至500μs以上。
6.2 排查过程
第一步:抓包分析
在源VM和目的VM对应的Leaf交换机接口上分别抓包,发现同一TCP流的往返报文走不同的Spine:
Forward path:  Leaf-02 → Spine-03 → Leaf-05
Return path:   Leaf-05 → Spine-01 → Leaf-02
第二步:检查路由
发现Leaf-02和Leaf-05均通过ECMP学习到对端的路由,但ECMP的哈希算法在去程和回程选择了不同的Spine,导致非对称路由。
第三步:深入分析
非对称路由本身并不是问题——Spine-Leaf的等径设计允许任意Spine参与转发。但进一步检查发现,Spine-01上配置了比Spine-03更严格的QoS策略,导致经过Spine-01的回程报文被排队延迟。
6.3 解决方案
- 统一所有Spine的QoS策略:确保所有Spine的QoS配置完全一致
- 验证ECMP对称性:虽非必须,但对于对延迟敏感的业务,可通过配置哈希种子(hash seed)使往返流量尽量走同一路径
- 部署Spine配置模板:使用自动化配置管理工具确保所有Spine配置的一致性
# 在所有 Spine 上应用统一的 QoS 策略
qos profile Spine-QoS-Profile
 queue 1 wred enable
 queue 2 wfq enable
 queue 3 strict enable
#
traffic classifier Spine-Traffic
 if-match vlan 100 200 300
#
traffic behavior Spine-Behavior
 qos-profile Spine-QoS-Profile
#
traffic policy Spine-Policy
 classifier Spine-Traffic behavior Spine-Behavior
#
# 在所有 Spine 的互联接口上应用
interface Range 100GE1/0/1 to 100GE1/0/8
 traffic-policy Spine-Policy inbound
 traffic-policy Spine-Policy outbound
七、总结
| 设计原则 | 核心要义 | 违反后的后果 |
|---|---|---|
| Leaf不互联 | 消除次优路径和环路 | 非等径路由,ECMP失效 |
| Spine不互联 | 保证所有路径等价 | 非对称路由,故障域扩大 |
| 全互联 | 保证任意Leaf可达 | 部分Leaf间通信中断 |
| 等臂路由 | 使ECMP充分发挥作用 | 单路径转发,带宽利用率低 |
| 关键机制 | 说明 |
|---|---|
| Clos无阻塞 | 上行带宽≥下行带宽需求 |
| ECMP负载均衡 | 五元组哈希,多路径分担 |
| M-LAG冗余 | Leaf层跨设备链路聚合 |
| Multi-Pod扩展 | 端口耗尽时的横向扩展 |
| 多层Clos | 超大规模场景的多级扩展 |
思考
- Spine-Leaf架构中要求Leaf之间不互联,但如果两台Leaf属于同一机柜,距离很近且带宽充足,将两台Leaf互联是否能提升同一机柜内服务器的通信效率?为什么这种设计不被推荐?
- 在多Pod架构中,Pod间互联使用VXLAN隧道而非直接三层路由,各自的适用场景是什么?
- Spine故障后剩余Spine的负载会上升,如果上升后的负载超过Spine的处理能力,会导致什么后果?如何避免?
- ECMP的五元组哈希算法如何实现负载均衡?为什么仅基于目的IP的哈希会导致负载不均?
- 多层Clos架构中,每增加一层Spine,跳数增加2跳,这对延迟敏感型业务(如HFT、RoCE)有什么影响?
下篇预告:第253篇:ECMP 在 Spine-Leaf 中的负载均衡