第264篇:RoCE 与无损网络:PFC、ECN、DCQCN
关键词:RoCE、RoCEv2、RDMA、PFC、ECN、DCQCN、无损以太网、高性能计算
一、引言
随着AI训练、大数据分析、分布式存储等高性能计算场景的爆发式增长,传统TCP/IP网络的高延迟和低吞吐量已无法满足需求。RoCE(RDMA over Converged Ethernet)技术通过在以太网上传输RDMA报文,实现了微秒级的通信延迟和线速吞吐,成为高性能数据中心网络的核心技术。
然而,以太网本质上是一种有损网络(丢包是TCP的流量控制机制),而RDMA协议对丢包极度敏感(一次丢包可能导致整个TCP连接级别的性能下降)。要使RoCE在以太网上高效运行,必须构建"无损网络"。
二、核心概念
2.1 RDMA 技术原理
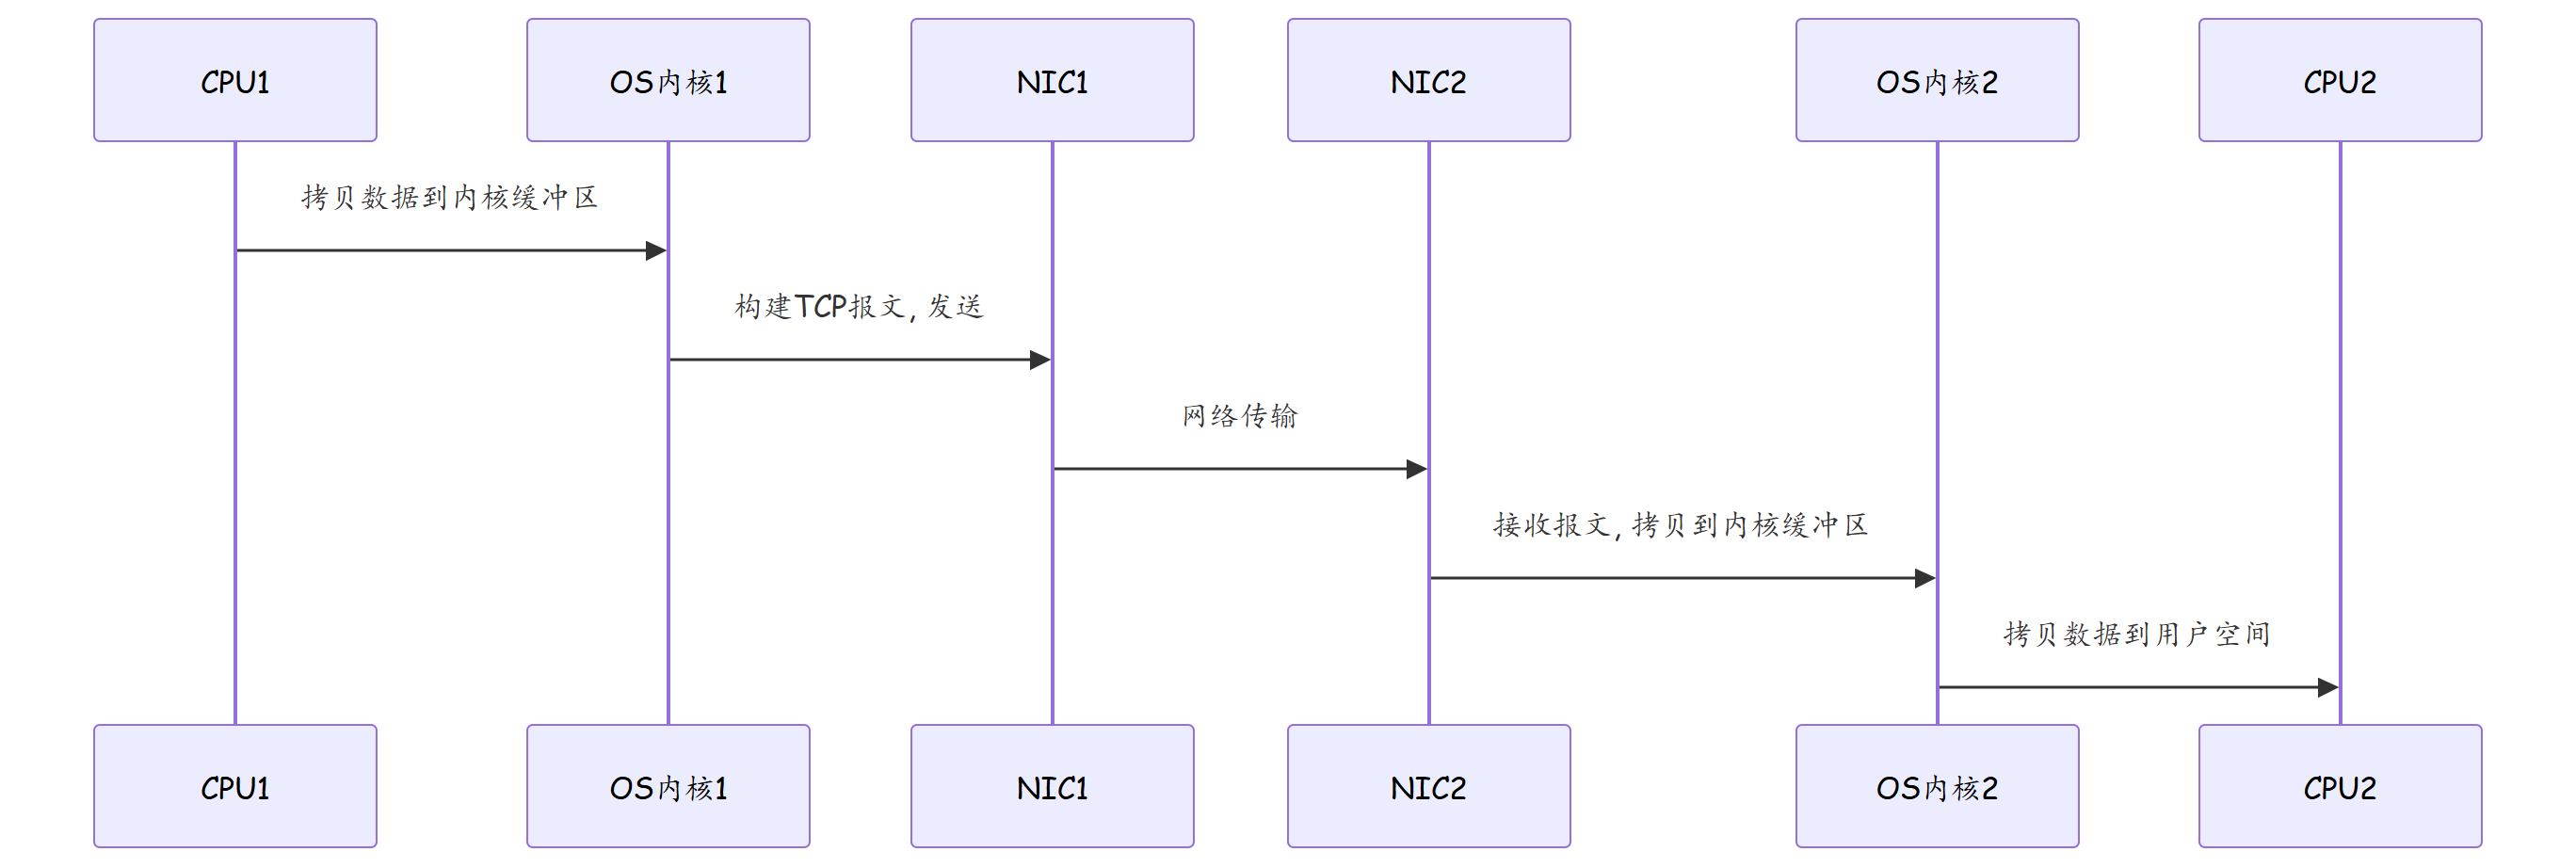
RDMA(Remote Direct Memory Access)允许一台计算机直接访问另一台计算机的内存,无需CPU和操作系统内核的参与:
传统TCP通信:
RDMA通信:
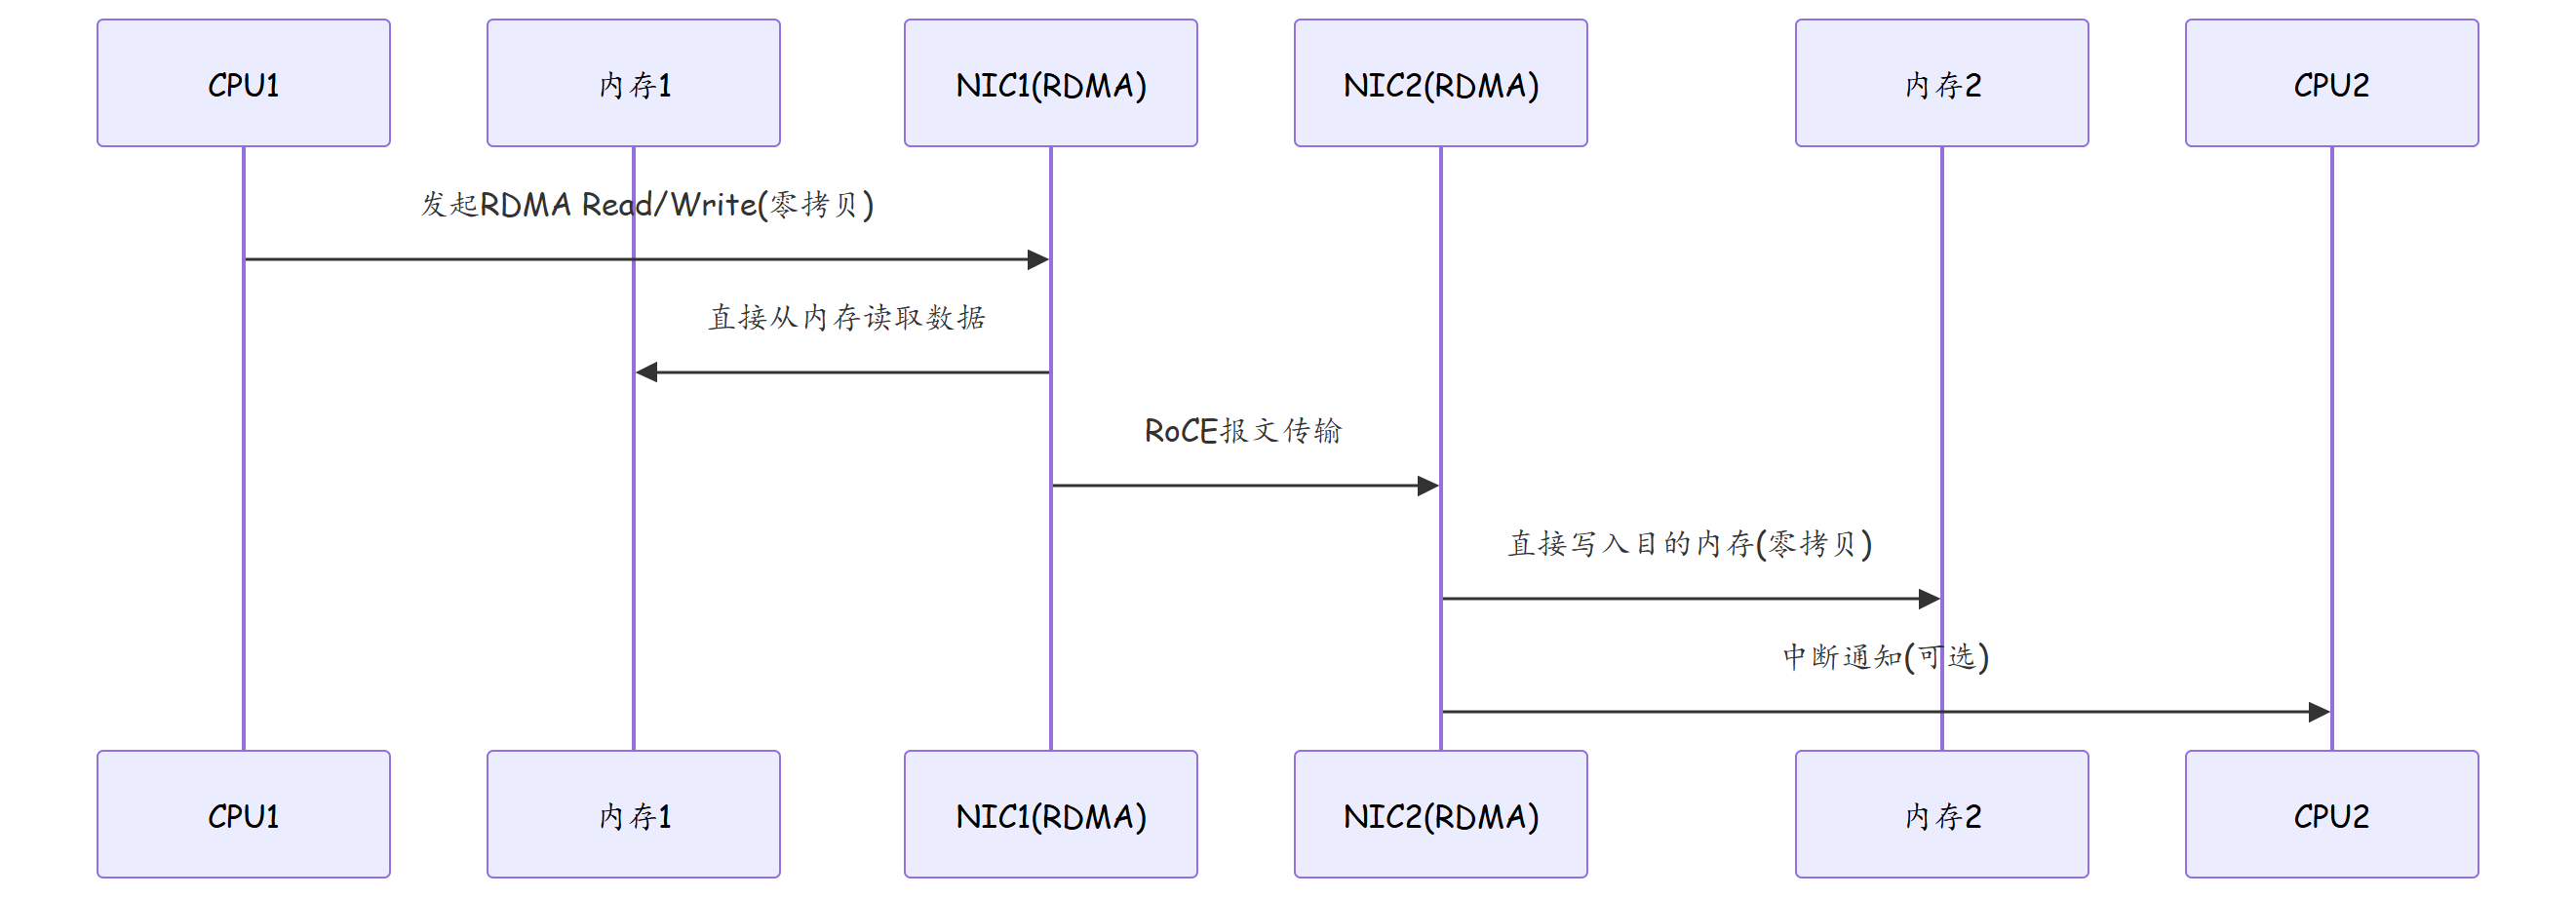
对比:
| 通信方式 | 延迟 | CPU占用 | 上下文切换 | 适用场景 |
|---|---|---|---|---|
| TCP/IP | 数十微秒~毫秒 | 高 | 频繁 | 通用应用 |
| RDMA(RoCE) | 亚微秒~数微秒 | 极低 | 极少 | HPC/AI/分布式存储 |
2.2 RoCE 协议演进
| 版本 | 传输层 | 网络层 | 特性 | 状态 |
|---|---|---|---|---|
| RoCEv1 | 二层 | 以太网 | 仅限同一二层域 | 已过时 |
| RoCEv2 | 四层(UDP) | IP路由 | 跨子网/跨DC | 主流 |
RoCEv2封装:
| 层次 | 协议 | 说明 |
|---|---|---|
| 二层 | 以太网 | 标准以太网帧 |
| 三层 | IPv4/IPv6 | 支持IP路由 |
| 四层 | UDP | 目的端口4791 |
| 传输层 | RC(可靠连接) | InfiniBand传输语义 |
| 数据 | RDMA载荷 | Read/Write/Send |
2.3 为什么需要无损网络
RDMA协议工作在可靠连接(RC, Reliable Connected)模式下,要求所有报文按序到达、不丢包。在以太网上:
- TCP可以通过丢包触发重传(拥塞控制机制)
- RDMA没有重传机制(重传由端点处理,效率远低于网络层重传)
- 一次丢包导致RDMA端点暂停发送,直到重传成功,性能急剧下降
因此,RoCE网络必须实现"零丢包"的无损特性。
三、技术细节
3.1 PFC(Priority-based Flow Control)
PFC(IEEE 802.1Qbb)是优先级流控协议,是以太网上的逐跳流控机制:
工作原理: 1. 当交换机的某个优先级队列的缓冲区使用率达到高水位(Xon阈值)时 2. 交换机向上游邻居发送PFC Pause帧(Per-Priority) 3. 上游邻居暂停发送该优先级的流量 4. 当缓冲区使用率降至低水位(Xoff阈值)时 5. 交换机发送PFC Resume帧恢复流量
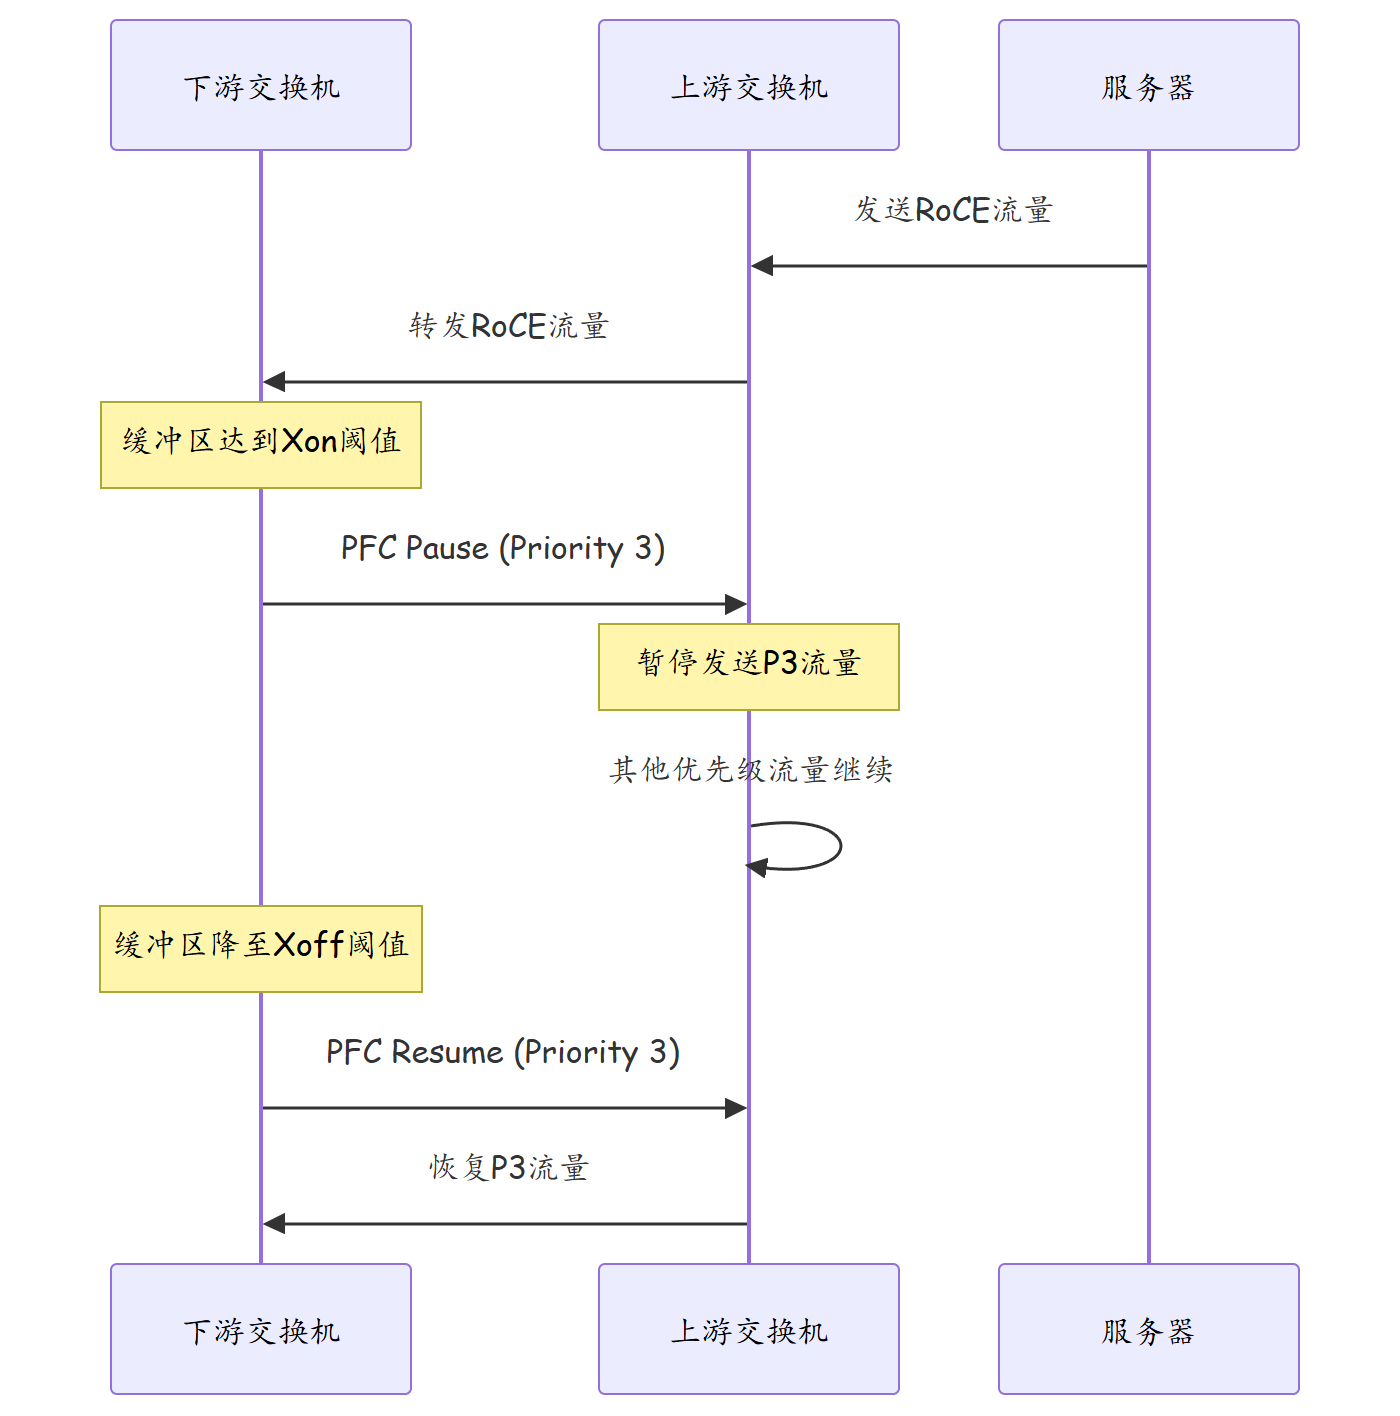
PFC的关键参数:
| 参数 | 说明 | 默认值 |
|---|---|---|
| Xon阈值 | 触发Pause的缓冲区水位 | 缓冲区大小的80% |
| Xoff阈值 | 触发Resume的缓冲区水位 | 缓冲区大小的60% |
| 优先级映射 | 哪些优先级启用PFC | 通常为P3(RoCE) |
| 队列大小 | PFC队列的缓冲区大小 | 需根据流量调优 |
3.2 ECN(Explicit Congestion Notification)
ECN(RFC 3168)是显式拥塞通知机制,通过IP头的ECN字段标记拥塞状态:
工作原理: 1. 交换机监测队列深度 2. 当队列深度超过ECN标记阈值时,将报文的IP ECN字段标记为CE(Congested Experienced) 3. 目的端NIC收到标记报文后,发送CONG(Congestion)响应给源端 4. 源端NIC降低发送速率(拥塞避免)
ECN的优势: - 在丢包之前提前通知发送端减速,实现"软"拥塞控制 - 与PFC配合使用,PFC处理突发拥塞,ECN处理渐进拥塞
3.3 DCQCN(Data Center Quantized Congestion Notification)
DCQCN是Mellanox(现NVIDIA)设计的RoCEv2拥塞控制协议,结合PFC和ECN:
DCQCN工作过程:
| 阶段 | 触发条件 | 动作 |
|---|---|---|
| 正常发送 | 无拥塞 | 以线速发送 |
| ECN标记 | 交换机队列超过ECN阈值 | 标记报文CE位 |
| 减速响应 | 目的端收到ECN标记 | 发送CONG响应 |
| 速率降低 | 源端收到CONG | 按算法降低发送速率 |
| 速率恢复 | 超时无拥塞 | 逐步恢复发送速率 |
四、实战配置/案例分析
4.1 华为CloudEngine 无损网络配置
# Leaf交换机 RoCE无损网络配置
sysname Leaf-01
#
# 1. 配置PFC
#
# 启用PFC
pfc enable
# 将P3优先级映射到PFC
pfc priority 3
# 配置PFC队列
queue 3 pfc enable
#
# 2. 配置ECN
#
# 启用ECN
ecn enable
# 配置ECN阈值(基于队列深度)
ecn profile 1
 threshold green 80%
 threshold yellow 90%
 threshold red 95%
#
# 将ECN应用到P3队列
queue 3 ecn profile 1
#
# 3. 配置DCQCN
#
# 启用DCQCN
dcqcn enable
# 配置DCQCN参数
dcqcn config
  congestion-timeout 100
  initial-rate 100
  min-rate 10
  alpha 32
  beta 64
#
# 4. 配置严格的优先级队列调度
#
# P3(RoCE)最高优先级
queuing scheduler 1
 queue 3 weight 0  # 严格优先
 queue 2 weight 25
 queue 1 weight 25
 queue 0 weight 50
4.2 故障案例:PFC参数调优不当导致拥塞
现象:AI训练集群的RoCE网络出现周期性性能下降,GPU利用率从95%骤降至40%,持续数秒后恢复。
排查过程:
# 检查PFC统计
display pfc statistics interface 100GE1/0/1

# 发现PFC Pause帧频繁触发
# Xon触发次数: 15000次/分钟
# Pause持续时间: 平均5ms, 最长200ms

# 检查队列深度
display queue statistics interface 100GE1/0/1

# P3队列深度经常超过Xon阈值
# 队列深度峰值: 95% (Xon阈值: 80%)

# 分析流量模式
# AI训练中大量GPU节点同时发送梯度数据, 形成突发流量
# 当前PFC队列大小不足以吸收突发
根因:PFC队列大小配置过小(64KB),在AI训练突发流量下频繁触发PFC Pause。过长的Pause时间(最大200ms)导致RoCE传输效率急剧下降。
解决: 1. 增大PFC队列大小至256KB 2. 调整ECN阈值,使拥塞通知更早触发(绿色阈值从80%降至70%) 3. 调整DCQCN参数,增大初始减速力度 4. 在交换机上启用动态PFC(dPFC),根据实际流量动态调整PFC阈值
五、总结
| 技术 | 层次 | 作用 | 配合关系 |
|---|---|---|---|
| PFC | 二层流控 | 逐跳暂停,防止丢包 | 处理突发拥塞 |
| ECN | 三层标记 | 提前通知拥塞 | 处理渐进拥塞 |
| DCQCN | 端到端控制 | 速率调整,拥塞避免 | 综合PFC+ECN |
| 严格优先调度 | 队列调度 | 确保RoCE优先转发 | 基础保障 |
| 调优参数 | 推荐值 | 说明 |
|---|---|---|
| PFC队列大小 | 256KB+ | 根据突发流量调整 |
| Xon阈值 | 70-80% | 更早触发Pause |
| ECN绿色阈值 | 60-70% | 更早标记拥塞 |
| DCQCN初始速率 | 100Gbps | 与端口速率匹配 |
思考
- PFC是逐跳流控机制,如果网络中出现PFC环路,会发生什么?如何检测PFC环路?
- ECN标记阈值应该设置为什么值?设置过低或过高分别有什么影响?
- RoCEv2的UDP目的端口是4791,与VXLAN的4789端口非常接近,在同一台交换机上同时运行RoCE和VXLAN会有冲突吗?
下篇预告:第265篇:RoCEv2 拥塞控制与流量监管