关键词:OSPF、邻接震荡、Flapping、状态机震荡、链路不稳定、快速收敛
第68篇:OSPF 邻接震荡典型案例分析
一、引言
OSPF 邻接震荡(Adjacency Flapping)是指 OSPF 邻居关系在短时间内频繁地在 Up 和 Down 之间切换。每次邻接断开都会触发 LSA 重新泛洪和 SPF 重新计算,对网络性能和稳定性造成严重影响。
邻接震荡的根因多样,可能是物理链路质量问题、设备资源不足、配置不当或软件缺陷。准确定位震荡根因并采取有效的抑制措施,是维护 OSPF 网络稳定性的关键技能。
二、核心概念
2.1 邻接震荡的表现
| 表现 | 说明 |
|---|---|
| 日志频繁记录邻居 Down/Up | 系统日志中出现大量 OSPF Peer Down/Up 事件 |
| SPF 计算频繁触发 | display ospf 显示 SPF 运行次数快速增加 |
| 路由表频繁刷新 | 路由表中 OSPF 路由的 NextHop 频繁变化 |
| CPU 利用率升高 | 频繁 SPF 计算消耗 CPU 资源 |
| 网络性能下降 | LSA 泛洪和路由刷新占用带宽 |
2.2 震荡的常见根因分类
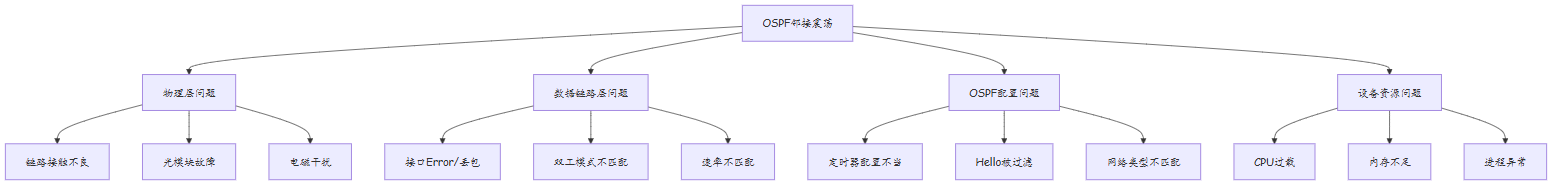
三、技术细节
3.1 OSPF 震荡抑制机制
OSPF 内置了多种抑制震荡的机制:
| 机制 | 说明 | 默认值 |
|---|---|---|
| SPF 延迟计算(Spreading Delay) | 等待网络稳定后再计算 SPF | 20秒(华为) |
| SPF 最小间隔(Hold Down) | 两次 SPF 计算的最小时间间隔 | 1秒 |
| LSA 最小泛洪间隔 | 同一 LSA 两次泛洪的最小间隔 | 1秒 |
| BFD 联动 | 通过 BFD 快速检测链路故障 | 需手动配置 |
3.2 SPF 抑制参数
# 查看SPF抑制参数
display ospf

# 调整SPF抑制参数
ospf 1
 spf-scheduler interval 50      # SPF延迟计算间隔(毫秒)
 spf-scheduler hold-time 5000   # SPF最小间隔(毫秒)
参数调整原则:
- interval 不宜过大,否则收敛慢
- hold-time 不宜过小,否则频繁 SPF 消耗 CPU
3.3 震荡统计与监控
# 查看OSPF邻居变化统计
display ospf peer statistics

# 查看SPF运行统计
display ospf spf-statistics

# 查看OSPF事件日志
display logfile content | include OSPF

# 实时监控邻居状态
monitor ospf peer-state
四、实战配置/案例分析
4.1 案例一:物理链路质量导致的震荡
故障现象:R1 与 R2 的 OSPF 邻居每天凌晨 3 点左右发生 5-10 次震荡。
排查过程:
- 查看震荡日志:
[R1] display logfile content | include OSPF
 *Mar 15 03:00:01: OSPF: Peer 2.2.2.2 state changed from Full to Down
 *Mar 15 03:00:05: OSPF: Peer 2.2.2.2 state changed from Down to Full
 # 多次重复
- 检查接口错误统计:
[R1] display interface GigabitEthernet 0/0/1
  Input:
   input packets: 1234567
   input errors: 523           # 存在输入错误
   input discards: 0
  Output:
   output packets: 7654321
   output errors: 128          # 存在输出错误
-
进一步排查发现光模块收光功率在临界值,凌晨温度降低时光功率波动导致链路间歇性中断。
-
解决方案:更换光模块或调整光功率。
4.2 案例二:Hello 报文间歇性丢失导致的震荡
故障现象:OSPF 邻居频繁在 Full 和 Down 之间切换,每次切换间隔约 40 秒(DeadTimer 超时时间)。
排查过程:
-
抓包分析发现 Hello 报文大量丢失(丢失率约 30%)。
-
检查链路状态:
[R1] display interface GigabitEthernet 0/0/1
  Bandwidth: 1000000 Kbps
  ...
  Input bandwidth: 950000 Kbps    # 链路接近饱和
  Output bandwidth: 880000 Kbps
-
根因:链路拥塞导致 Hello 报文被丢弃。当连续丢失 4 个 Hello(40 秒)后,DeadTimer 超时,邻居状态变为 Down。
-
解决方案:
# 方案1:调整定时器(不推荐长期使用)
interface GigabitEthernet 0/0/1
 ospf timer hello 30
 ospf timer dead 120

# 方案2:增加链路带宽或调整QoS
# 方案3:为OSPF报文配置高优先级QoS
qospolicy
 traffic classifier OSPF-Hello
  if-match protocol ospf
 traffic behavior OSPF-Help
  queue af wrr queue 7
 qospolicy map classifier OSPF-Hello behavior OSPF-Help
4.3 案例三:BFD 联动加速故障检测
需求:OSPF 默认的 DeadTimer 为 40 秒,故障检测时间过长。配置 BFD 联动实现毫秒级故障检测。
# 配置BFD
bfd
 minimum-interval 10 min-rx-interval 10
 minimum-timer 10 min-remote-timer 10

# 在OSPF接口上启用BFD
interface GigabitEthernet 0/0/1
 ospf bfd enable

# 验证BFD状态
display bfd session all
display ospf peer
效果:链路故障在 30 毫秒内被检测并通知 OSPF,邻居状态立即变为 Down,远快于默认的 40 秒 DeadTimer。
五、总结
| 震荡类型 | 根因 | 排查命令 | 解决方案 |
|---|---|---|---|
| 物理层震荡 | 链路质量 | display interface | 修复链路/更换光模块 |
| Hello 丢失震荡 | 链路拥塞 | 抓包分析 | 增加带宽/调整QoS |
| 配置不当震荡 | 参数不匹配 | display ospf interface | 统一配置 |
| 资源不足震荡 | CPU/内存 | display cpu-usage | 增加资源/优化配置 |
| 软件异常震荡 | Bug | display version | 升级版本 |
思考
- OSPF SPF 抑制机制中的 Spreading Delay 和 Hold Down 有什么区别?各自的作用是什么?
- 当 OSPF 邻接频繁震荡时,对整个网络的影响是什么?哪些路由器会受到最严重的影响?
- BFD 联动可以加速 OSPF 的故障检测,但在什么场景下不建议使用 BFD?为什么?
下篇预告:第69篇:OSPF 特殊区域:Stub、Totally Stub、NSSA