第143篇:物理冗余与链路冗余的权衡
关键词:物理冗余、链路冗余、Eth-Trunk、M-LAG、RRPP、STP、高可用、容灾、华为
一、引言
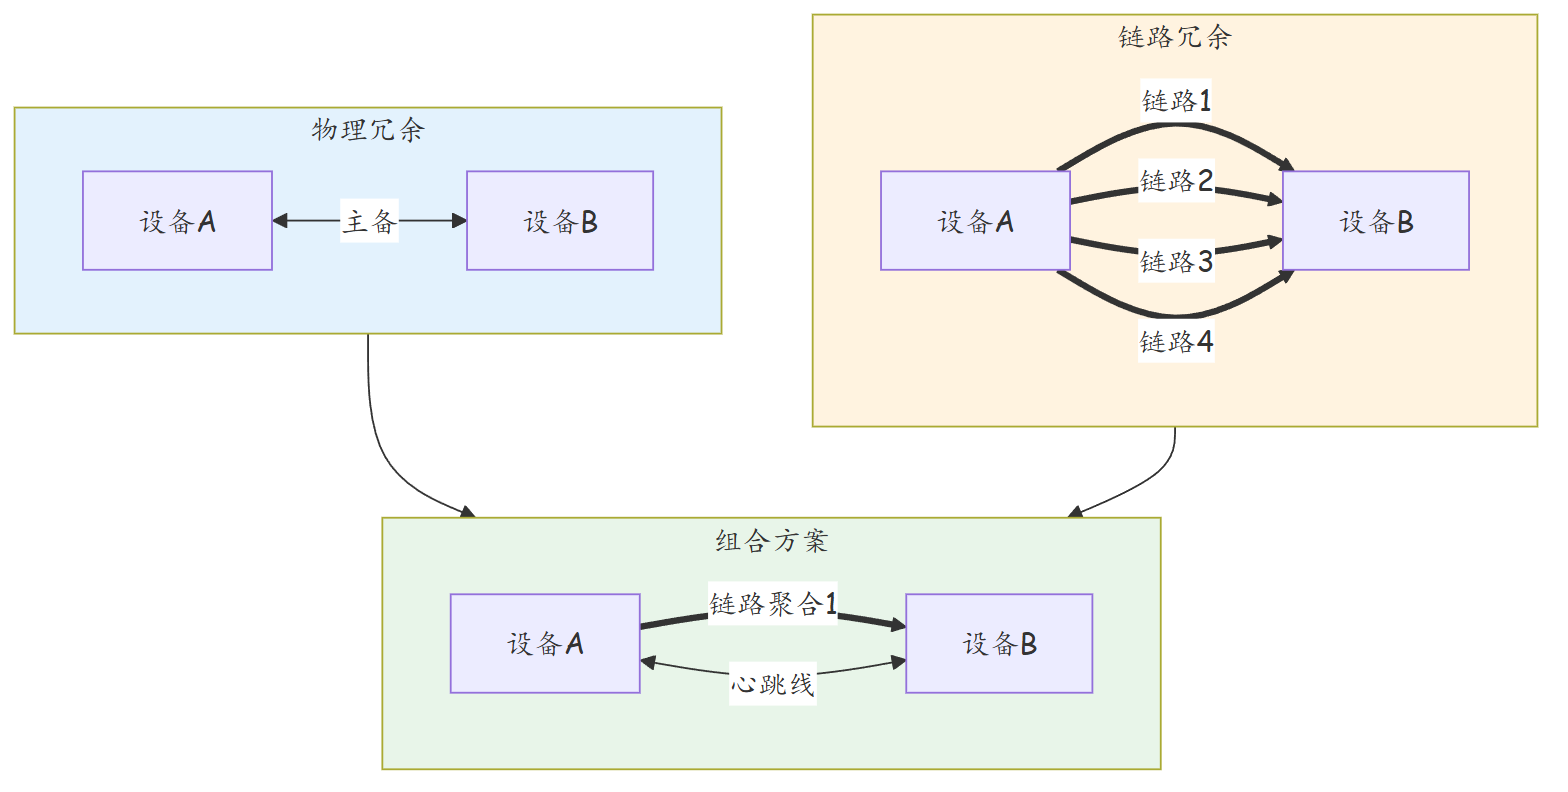
园区网高可用的核心手段有两条路径:物理冗余和链路冗余。物理冗余通过部署多台设备互为备份来实现,链路冗余通过在同一设备上绑定多条物理链路来提升带宽和可靠性。但在实际工程中,两者并非独立选择,而是需要综合权衡。
本文深入分析各种冗余技术的工作原理、适用场景、配置方法和局限性,帮助工程师在实际项目中做出最优选择。
二、核心概念
2.1 冗余技术分类
| 分类 | 技术 | 层级 | 切换时间 | 适用场景 |
|---|---|---|---|---|
| 链路冗余(单设备) | Eth-Trunk(链路聚合) | 接入→汇聚 | < 1ms | 同设备间多链路 |
| 链路冗余(跨设备) | M-LAG | 接入→多汇聚 | < 50ms | 跨设备链路聚合 |
| 环网冗余 | RRPP | 环型拓扑 | < 50ms | 工业环网、安防环 |
| 生成树冗余 | STP/RSTP/MSTP | 任意二层拓扑 | 1~30s | 简单拓扑 |
| 物理冗余 | VRRP/堆叠/iStack | 设备级 | < 1s / < 50ms | 核心/汇聚高可用 |
| 路由冗余 | OSPF/ECMP | 三层 | 1~10s | 三层多路径 |
2.2 物理冗余 vs 链路冗余
2.3 关键技术对比
| 维度 | Eth-Trunk | M-LAG | RRPP | 堆叠(iStack/CSS) |
|---|---|---|---|---|
| 设备数量 | 2 台 | 2 台以上 | 环上多台 | 多台逻辑为一台 |
| 链路利用率 | 100%(聚合) | 100%(聚合) | 单路径,备份空闲 | 100%(聚合) |
| 故障切换 | < 1ms | < 50ms | < 50ms | < 50ms |
| 配置复杂度 | 低 | 高 | 中 | 中 |
| 跨厂商兼容 | 是(LACP) | 否(华为私有) | 否(华为私有) | 否(华为私有) |
| 环路易用 | 否 | 是 | 是 | 是 |
三、技术细节
3.1 Eth-Trunk(链路聚合)
Eth-Trunk 是最基础也是使用最广泛的链路冗余技术。它将多条物理链路绑定为一个逻辑链路,提高带宽的同时提供链路级别的冗余。
聚合模式
| 模式 | 说明 | 适用场景 |
|---|---|---|
| Manual(手工) | 不协商,手工指定成员端口 | 对端不支持 LACP |
| Static(静态) | 手工绑定 + LACP 检测 | 对端支持 LACP 但不做负载分担 |
| Dynamic(动态 LACP) | 完全通过 LACP 协议协商 | 标准场景,推荐 |
负载分担算法
# Eth-Trunk 负载分担方式
[HUAWEI] interface Bridge-Aggregation 1
[HUAWEI-Bridge-Aggregation1] section load-balance src-mac           # 源MAC
[HUAWEI-Bridge-Aggregation1] section load-balance dst-mac           # 目的MAC
[HUAWEI-Bridge-Aggregation1] section load-balance src-dst-mac       # 源+目的MAC(默认)
[HUAWEI-Bridge-Aggregation1] section load-balance dst-ip            # 目的IP
[HUAWEI-Bridge-Aggregation1] section load-balance src-dst-ip        # 源+目的IP
[HUAWEI-Bridge-Aggregation1] section load-balance src-dst-ip-port   # 源+目的IP+端口(最均衡)
3.2 M-LAG(跨设备链路聚合)
M-LAG 解决了传统 Eth-Trunk 无法跨设备聚合的局限。它让两台物理设备对外呈现为一个聚合端,下行设备同时连接两台上行设备,实现跨设备冗余。
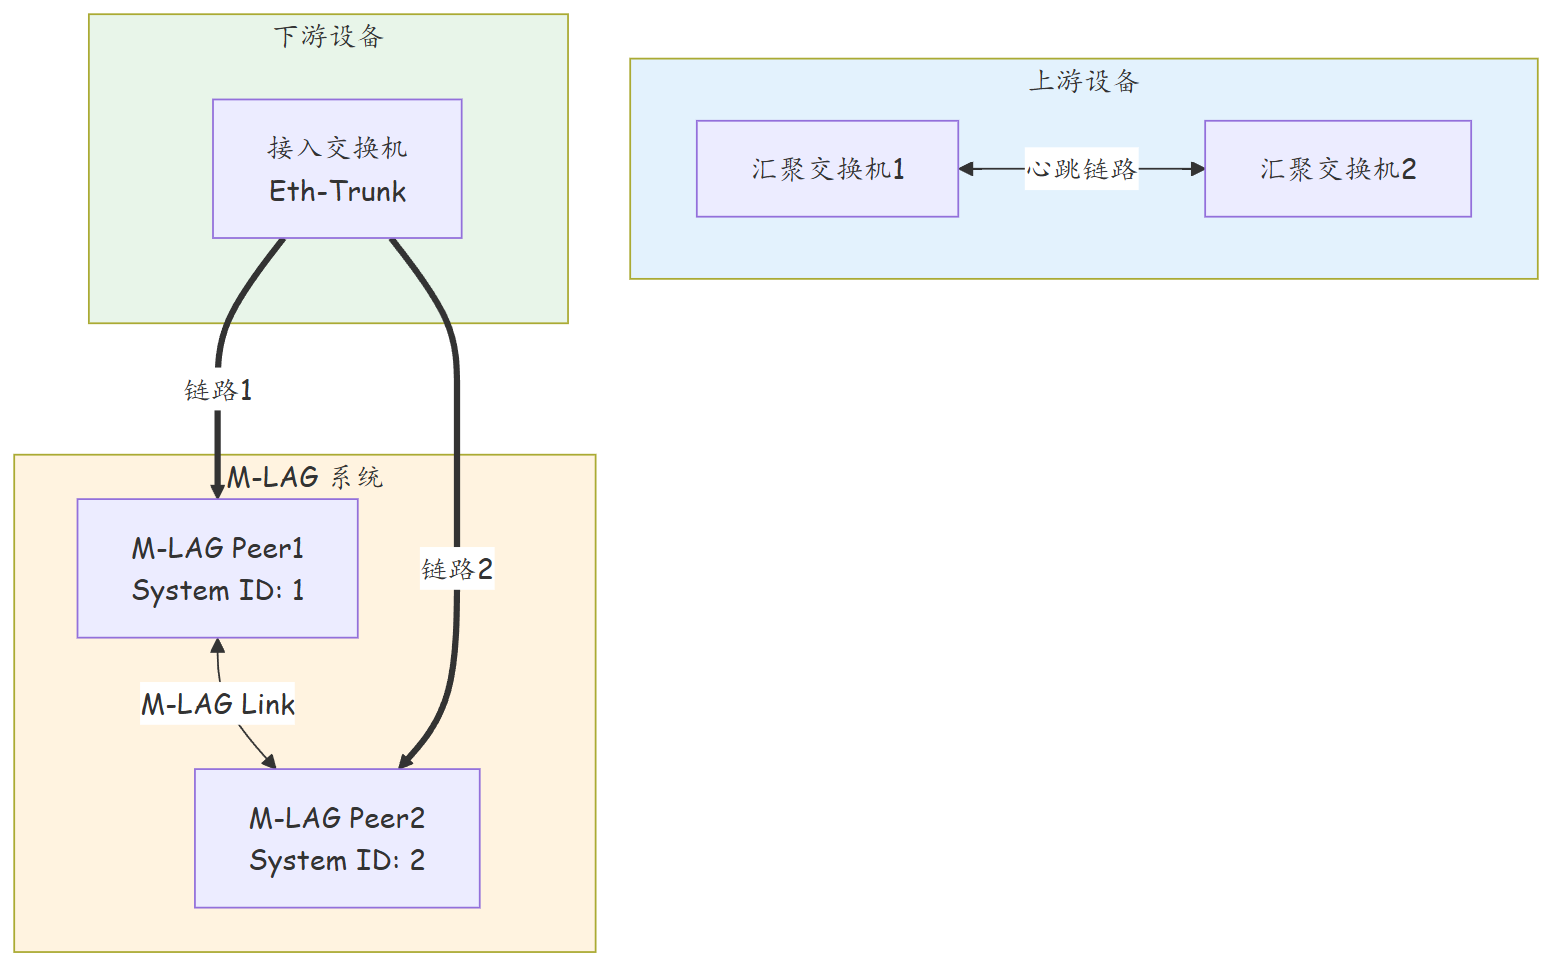
M-LAG 核心配置
# ========== 设备1(M-LAG Peer)==========
[HUAWEI] sysname MLAG-PEER1

# 创建 M-LAG 系统
[MLAG-PEER1] m-lag system priority 100
[MLAG-PEER1] m-lag system ip 10.255.255.1

# 配置对端连接(心跳)
[MLAG-PEER1] m-lag peer ip 10.255.255.2
[MLAG-PEER1] m-lag peer link HeartBeat 1
[MLAG-PEER1] interface FortyGigE1/0/1
[MLAG-PEER1-FortyGigE1/0/1] description HEARTBEAT-LINK
[MLAG-PEER1-FortyGigE1/0/1] port link-mode bridge
[MLAG-PEER1-FortyGigE1/0/1] m-lag peer-link interface

# 配置 M-LAG 接口
[MLAG-PEER1] interface Bridge-Aggregation 100
[MLAG-PEER1-Bridge-Aggregation100] link-aggregation mode dynamic
[MLAG-PEER1-Bridge-Aggregation100] m-lag
[MLAG-PEER1-Bridge-Aggregation100] m-lag peer-ip 10.255.255.2
[MLAG-PEER1-Bridge-Aggregation100] m-lag priority 100
[MLAG-PEER1-Bridge-Aggregation100] port trunk allow-pass vlan 10 20 30
3.3 RRPP(环网保护协议)
RRPP(Ring Relay Protocol Protection)是华为专有的环网保护协议,提供快速故障检测和切换。
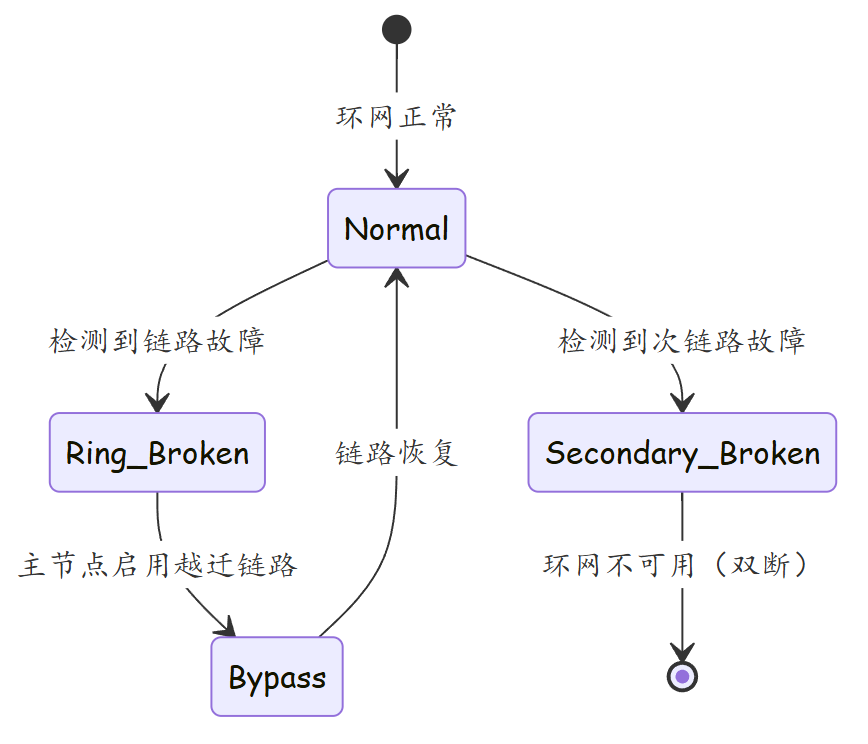
RRPP 角色与配置
| 角色 | 说明 | 数量 |
|---|---|---|
| 主节点(Master) | 控制环网保护,断开越迁端口 | 1 个 |
| 从节点(Slave) | 上报故障信息 | N-1 个 |
# ========== RRPP 主节点 ==========
[HUAWEI] sysname RRPP-MASTER

# 创建 RRPP 域
[RRPP-MASTER] rrpp domain-id 1
[RRPP-MASTER-rrpp-domain-1] control-vlan 1000
[RRPP-MASTER-rrpp-domain-1] priority 100
[RRPP-MASTER-rrpp-domain-1] stamp all

# 添加主环
[RRPP-MASTER-rrpp-domain-1] ring 1
[RRPP-MASTER-rrpp-domain-1-ring-1] mpid 1
[RRPP-MASTER-rrpp-domain-1-ring-1] primary-port FortyGigE1/0/1 neighbor 2.2.2.2 domain 1
[RRPP-MASTER-rrpp-domain-1-ring-1] secondary-port FortyGigE1/0/2 neighbor 3.3.3.3 domain 1
3.4 STP/RSTP/MSTP 对比
| 协议 | 收敛时间 | 支持实例 | 兼容性 | 适用场景 |
|---|---|---|---|---|
| STP (802.1D) | 30~50s | 1 个 | 全兼容 | 已淘汰,不推荐 |
| RSTP (802.1w) | 1~3s | 1 个 | 广泛 | 简单网络 |
| MSTP (802.1s) | 1~3s | 多达 64 个 | 广泛 | VLAN 映射不同路径 |
3.5 堆叠技术(iStack/CSS)
堆叠技术将多台物理交换机通过堆叠线缆连接,逻辑上呈现为一台交换机。
| 特性 | iStack(Huawei) | CSS(H3C) | vSS(Cisco) |
|---|---|---|---|
| 堆叠成员数 | 2~9 台 | 2~9 台 | 2 台 |
| 堆叠线缆 | 专用堆叠线 | 专用堆叠线 | 10GE 互联 |
| 管理 | 统一 IP | 统一 IP | 统一 IP |
| 配置 | 主设备统一下发 | 主设备统一下发 | 主设备统一下发 |
# iStack 配置示例
[HUAWEI] sysname iSTACK-SW-MASTER

# 配置 iStack 优先级
[iSTACK-SW-MASTER] irf priority 32
[iSTACK-SW-MASTER] irf member 1

# 配置堆叠链路
[iSTACK-SW-MASTER] interface FortyGigE1/0/1
[iSTACK-SW-MASTER-FortyGigE1/0/1] port link-type bridge
[iSTACK-SW-MASTER-FortyGigE1/0/1] irp-port 1/1

# 在另一台设备上
[HUAWEI] sysname iSTACK-SW-02
[iSTACK-SW-02] irf priority 1
[iSTACK-SW-02] irf member 2
[iSTACK-SW-02] interface FortyGigE1/0/1
[iSTACK-SW-02-FortyGigE1/0/1] irp-port 2/1
四、实战配置/案例分析
4.1 完整 Eth-Trunk + STP 冗余方案
# ========== 汇聚交换机1 ==========
[HUAWEI] sysname AGG-01

# 开启 STP
[AGG-01] stp mode mstp
[AGG-01] stp region-configuration
[AGG-01-stp-region] region-name CAMPUS-NET
[AGG-01-stp-region] revision-level 1
[AGG-01-stp-region] active region-configuration

# 上行 Eth-Trunk
[AGG-01] interface Bridge-Aggregation 1
[AGG-01-Bridge-Aggregation1] link-aggregation mode dynamic
[AGG-01-Bridge-Aggregation1] port trunk allow-pass vlan 10 20 30 40 50

[AGG-01] interface FortyGigE1/0/1
[AGG-01-FortyGigE1/0/1] eth-trunk 1
[AGG-01] interface FortyGigE1/0/2
[AGG-01-FortyGigE1/0/2] eth-trunk 1

# 下行 Eth-Trunk
[AGG-01] interface Bridge-Aggregation 10
[AGG-01-Bridge-Aggregation10] link-aggregation mode dynamic
[AGG-01-Bridge-Aggregation10] port trunk allow-pass vlan 10 20 30 40 50

[AGG-01] interface TenGigE1/0/10
[AGG-01-TenGigE1/0/10] eth-trunk 10
[AGG-01] interface TenGigE1/0/11
[AGG-01-TenGigE1/0/11] eth-trunk 10
4.2 故障案例:Eth-Trunk 单链路失效
场景:汇聚与核心之间的 Eth-Trunk(4 × 10G)中一条链路的光模块故障,导致链路 Down。
排查过程:
# 1. 检查 Eth-Trunk 状态
[AGG-01] display eth-trunk 1
# Eth-Trunk1:
#   Work Mode: LACP Dynamic
#   Loadbalance: src-dst-ip
#   Member interface: 4
#   Active interface: 3    ← 只有3条活跃
#   Inactive interface: 1
#   TenGigE1/0/2: Down (Physical down)

# 2. 检查物理接口
[AGG-01] display interface TenGigE1/0/2
# TenGigE1/0/2 current state : DOWN
#   Description: TO-CORE-01-Link2
#   Last protocol Up/Down time : 2026-09-01 14:23:15
#   Current system uptime : 1 days, 3 hours, 15 minutes

# 3. 检查光模块
[AGG-01] display transceiver interface TenGigE1/0/2
# RX power: -45.00 dBm  ← 无光输入,光模块故障或光纤断开
影响评估: - Eth-Trunk 从 40G 降为 30G,带宽降低 25% - 原走 TenGigE1/0/2 的流量自动重分布到其他 3 条链路 - 业务无感知中断(这是链路聚合的价值所在)
解决方案:
# 临时方案:将故障端口从 Eth-Trunk 中移除
[AGG-01] interface TenGigE1/0/2
[AGG-01-TenGigE1/0/2] undo eth-trunk 1
# 故障端口隔离,避免影响 Eth-Trunk 状态

# 永久方案:更换光模块或修复光纤
# 1. 更换光模块
# 2. 重新加入 Eth-Trunk
[AGG-01] interface TenGigE1/0/2
[AGG-01-TenGigE1/0/2] eth-trunk 1

# 3. 验证
[AGG-01] display eth-trunk 1
# Active interface: 4  ← 恢复为4条
4.3 故障案例:M-LAG Split-Brain(脑裂)
场景:某园区网采用 M-LAG 架构,维护人员误将两台 M-LAG Peer 交换机之间的两条心跳链路同时断开,导致两台设备都认为对方故障,各自独立处理流量,引发 ARP 冲突和广播风暴。
排查过程:
# 1. 检查 M-LAG 状态
[MLAG-PEER1] display m-lag summary
# M-LAG State: ALONE    ← 正常应为 ACTIVE
# Peer Link State: DOWN
# Peer IP State: DOWN

# 2. 检查日志
[MLAG-PEER1] display logbuffer | include M-LAG
# %M-LAG-4-PEER_DOWN: M-LAG peer link down, enter ALONE state
# %M-LAG-4-SPLIT_BRAIN: Possible split-brain detected

# 3. 检查 ARP 表
[MLAG-PEER1] display arp | include Duplicate
# 发现同一 MAC 在两个 M-LAG 端口上出现
根因:心跳链路全部中断后,两台 M-LAG Peer 设备失去通信。各自认为对端故障,进入 ALONE 状态,开始独立转发流量。下游设备发送的流量被两台 M-LAG Peer 同时接收和处理,造成 MAC 漂移、ARP 冲突和可能的广播风暴。
预防配置:
# 1. 配置多条心跳链路(冗余心跳)
[MLAG-PEER1] m-lag peer link HeartBeat 1
[MLAG-PEER1] m-lag peer link HeartBeat 2

[MLAG-PEER1] interface FortyGigE1/0/1
[MLAG-PEER1-FortyGigE1/0/1] m-lag peer-link interface
[MLAG-PEER1] interface FortyGigE1/0/2
[MLAG-PEER1-FortyGigE1/0/2] m-lag peer-link interface

# 2. 配置检测机制(BFD for M-LAG)
[MLAG-PEER1] m-lag detect bfd enable

# 3. 配置 ALONE 超时后自动关闭下游端口(防止脑裂危害)
[MLAG-PEER1] m-lag alone-timeout 300
# 进入 ALONE 状态 300 秒后,自动关闭 M-LAG 接口的下游端口
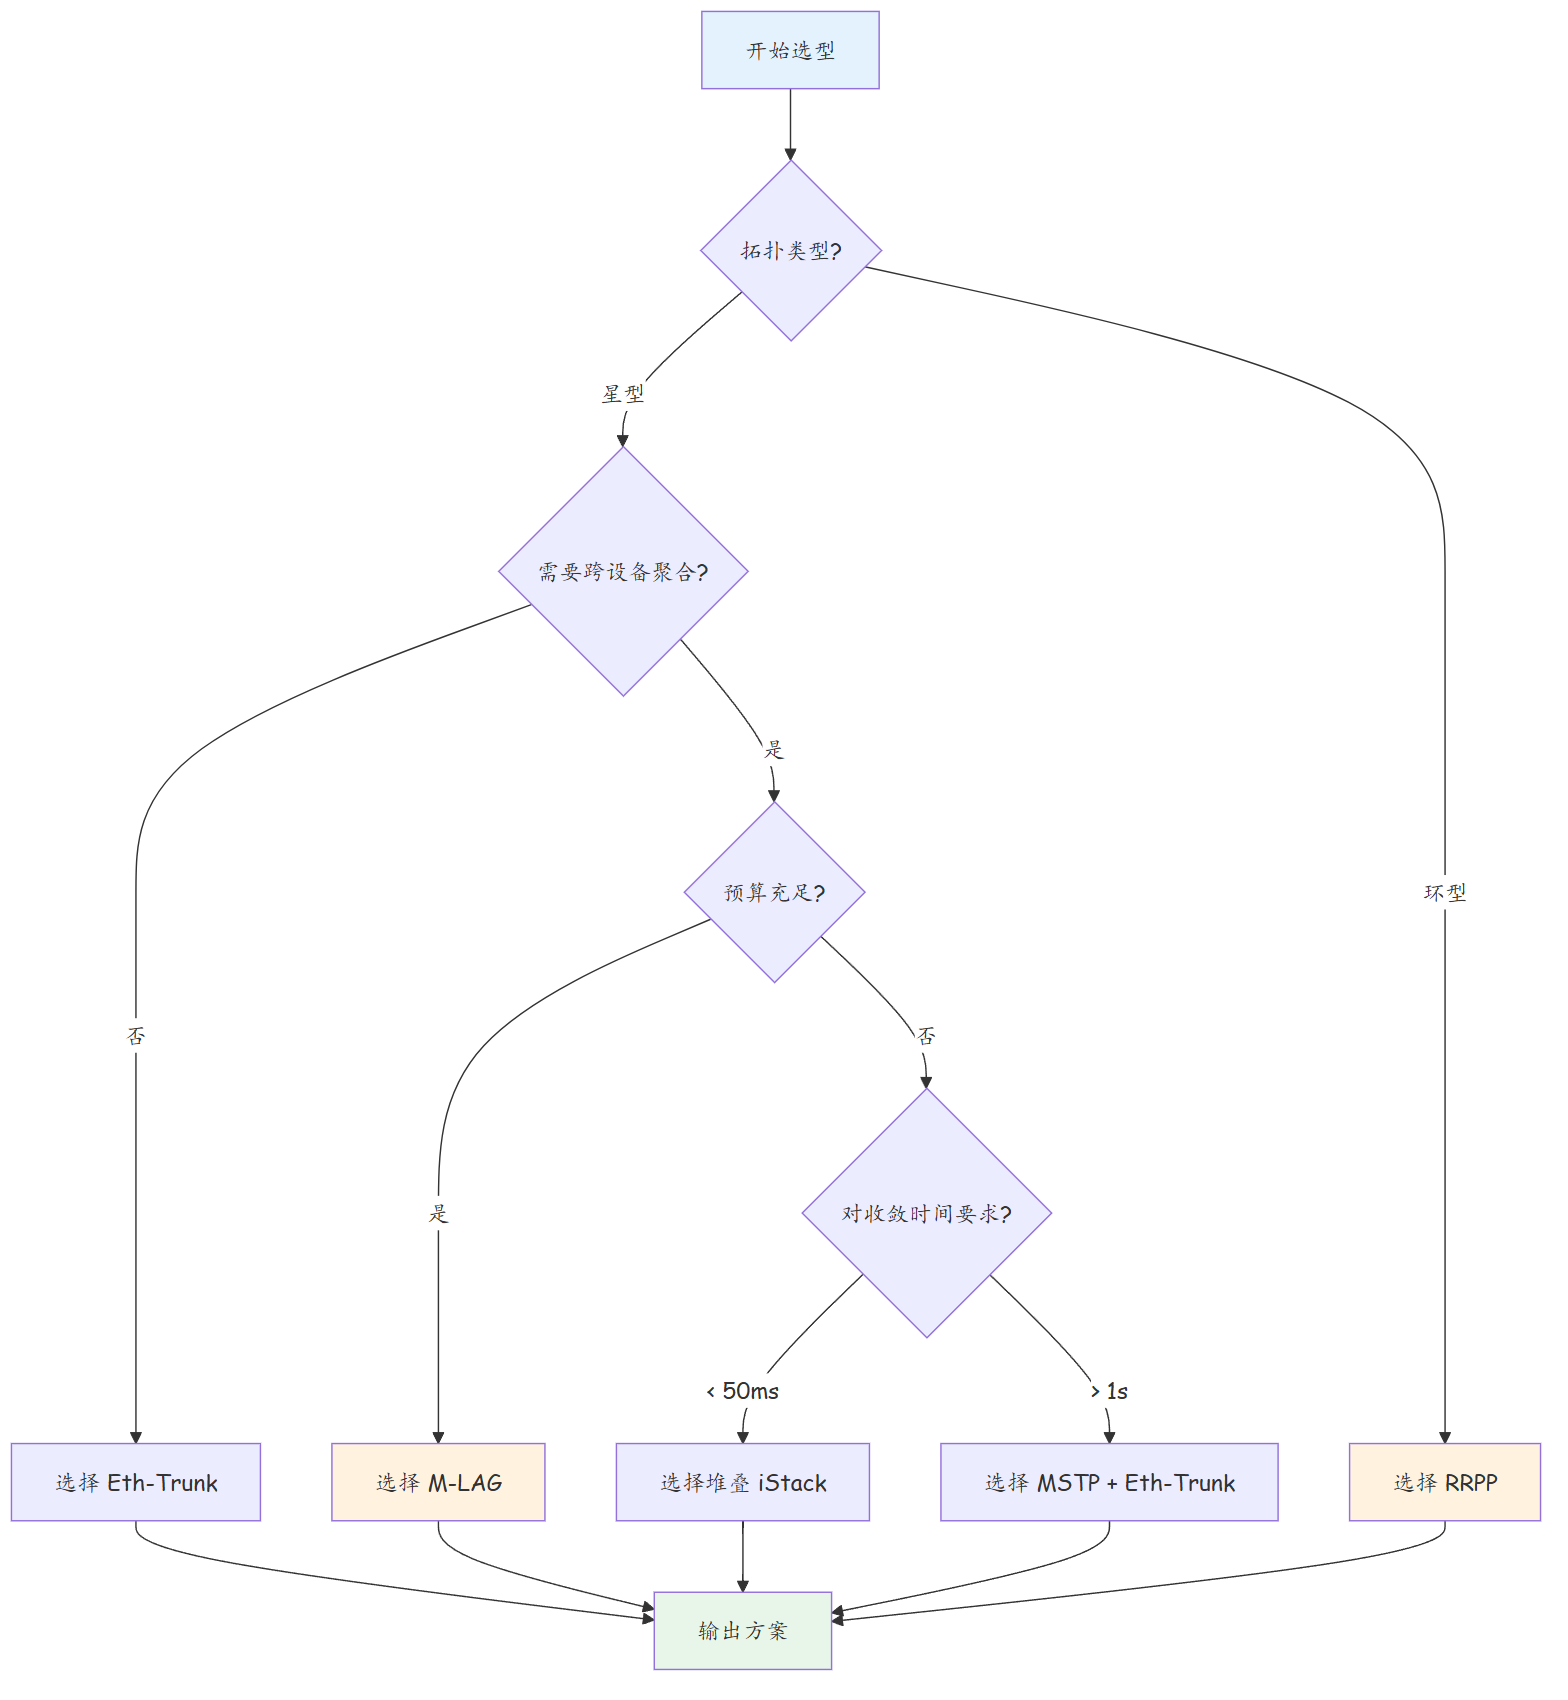
4.4 冗余方案选型决策流程
五、总结
| 项目 | 说明 |
|---|---|
| Eth-Trunk | 基础链路聚合,同设备多链路冗余,切换 < 1ms |
| M-LAG | 跨设备链路聚合,解决传统聚合无法跨设备的局限 |
| RRPP | 环网保护,切换 < 50ms,适合安防环、工业环 |
| MSTP | 通用生成树,兼容性最好,但收敛较慢(1~3s) |
| 堆叠 | 多设备逻辑统一,简化管理,适合同楼层多台接入 |
| 组合方案 | Eth-Trunk + M-LAG 为当前园区网主流方案 |
| 防脑裂 | M-LAG 必须配置冗余心跳 + ALONE 超时保护 |
思考
-
Eth-Trunk 的负载分担算法中,
src-dst-ip-port最均衡但需要三层信息。如果交换机工作在二层模式(不感知 IP),是否还能使用src-dst-ip-port算法? -
M-LAG 的 ALONE 超时保护(300秒后关闭下游端口)虽然防止了脑裂,但在这 300 秒内下游业务仍然受到影响。有没有更好的方案在检测到脑裂的瞬间就做出防护?
-
堆叠技术虽然简化管理,但所有成员交换机共享一个控制平面。如果堆叠中一台设备故障,是否会影响其他成员?与 M-LAG 方案相比,哪种方案的故障隔离能力更强?
下篇预告:第144篇:组播基础:IGMP 与组播地址