第26篇:堆叠分裂故障:双主检测与 MAD 机制
关键词:堆叠分裂、双主、MAD、直连检测、代理检测(relay)、Split-Brain
一、引言
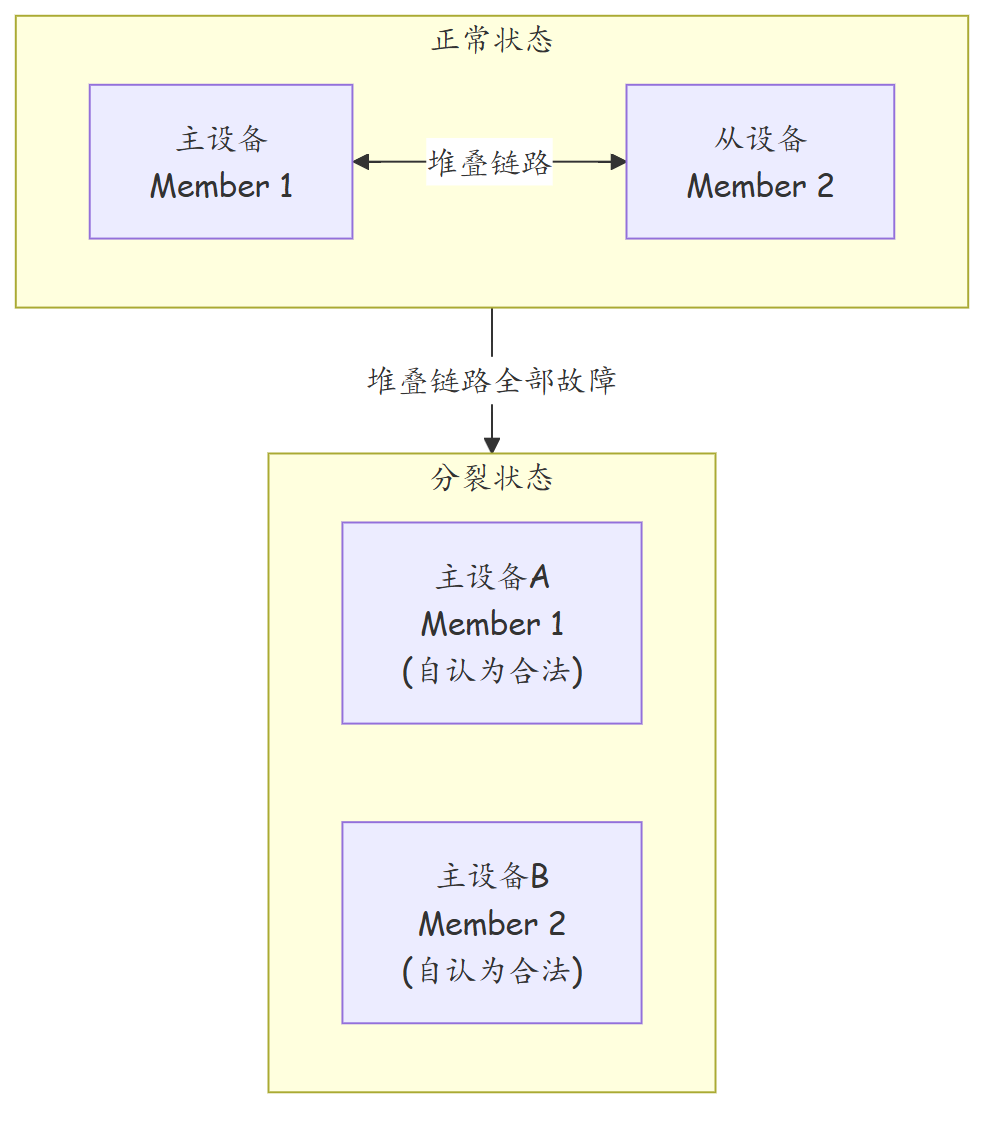
当堆叠系统的堆叠链路全部故障时,原本统一的逻辑设备会变成两个独立的堆叠系统,每个分区都会尝试选举自己的主设备,形成"双主"(Split-Brain)状态。这会导致 IP 地址冲突、路由震荡等严重后果。MAD(Multi-Active Detection,多主检测)机制正是为了避免这种双主问题而设计的。
二、核心概念
2.1 堆叠分裂场景
2.2 双主的危害
| 危害 | 说明 |
|---|---|
| IP 地址冲突 | 两个堆叠系统使用相同的堆叠管理 IP |
| 路由震荡 | 两个主设备同时发布路由,互相覆盖 |
| MAC 地址漂移 | 同一 MAC 地址出现在两个堆叠系统中 |
| 数据回环 | 终端不知该访问哪个主设备 |
| 业务中断 | ARP 表项频繁刷新,业务无法正常转发 |
2.3 MAD 检测方式对比
| 检测方式 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 直连检测(direct) | 分裂后的两个堆叠系统用专用业务口 MAD 链路直连,按 1s 周期互发 MAD 报文 | 最直接、无需中间设备 | 需要额外占用专用端口(且该端口只能用于 MAD) |
| 代理检测(relay) | 堆叠侧 Eth-Trunk 配 dual-active detect mode relay、中间设备 Eth-Trunk 配 dual-active proxy,L2 转发 MAD 报文 |
复用现有上联聚合口、不额外占端口 | 需要中间设备(代理设备)配合 |
说明:MAD 有直连检测和代理检测两种方式;同一堆叠系统中两种方式互斥,不能同时配置。
三、技术细节
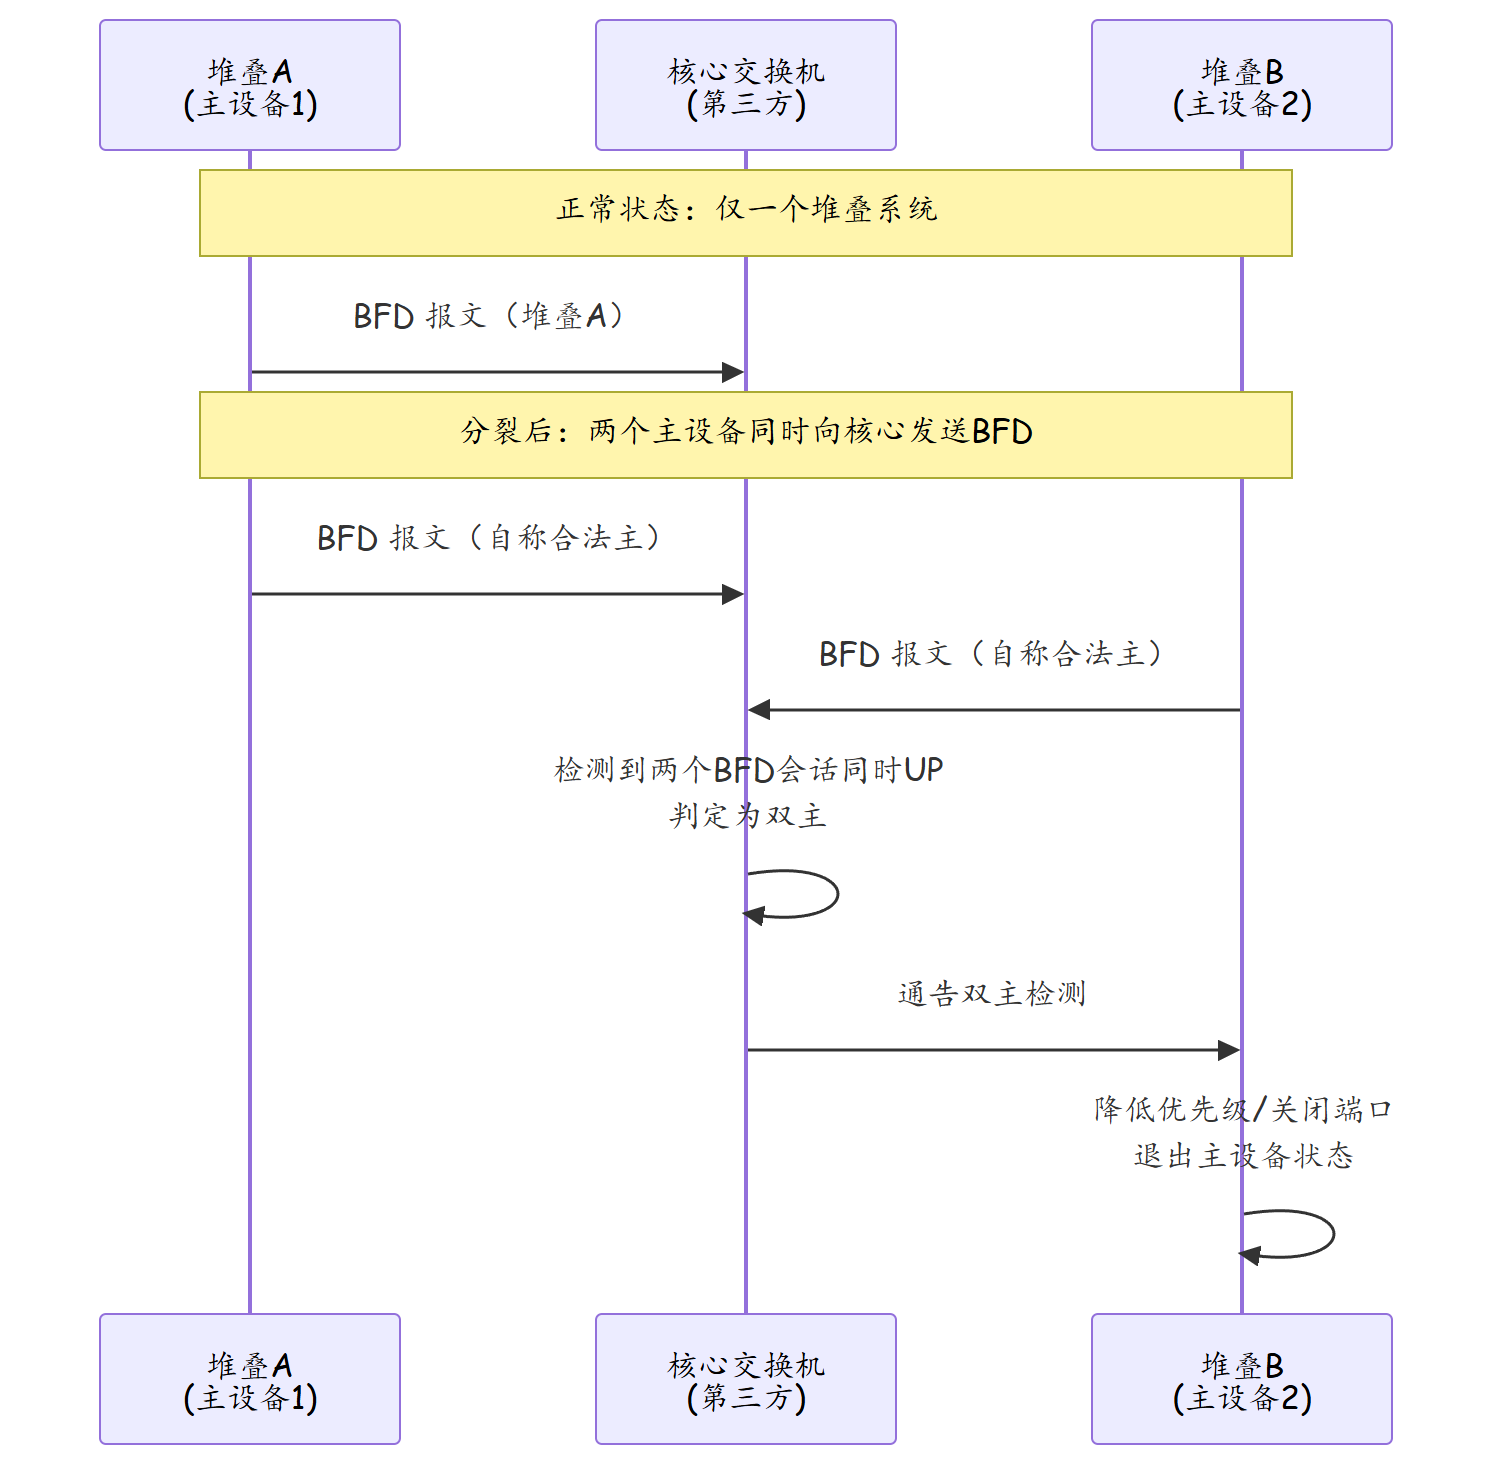
3.1 代理检测(relay)原理
代理检测借用堆叠系统与中间(代理)设备之间的 Eth-Trunk 上联链路来传递 MAD 报文,无需额外占用端口:
- 堆叠侧 Eth-Trunk 配置
dual-active detect mode relay; - 中间(代理)设备的 Eth-Trunk 配置
dual-active proxy,仅转发 MAD 报文; - 堆叠正常运行时不发送 MAD 报文;一旦分裂形成双主,两侧经代理设备的 Eth-Trunk 互发 MAD 竞争报文,从而检测到双主冲突。
3.2 直连检测(direct)原理
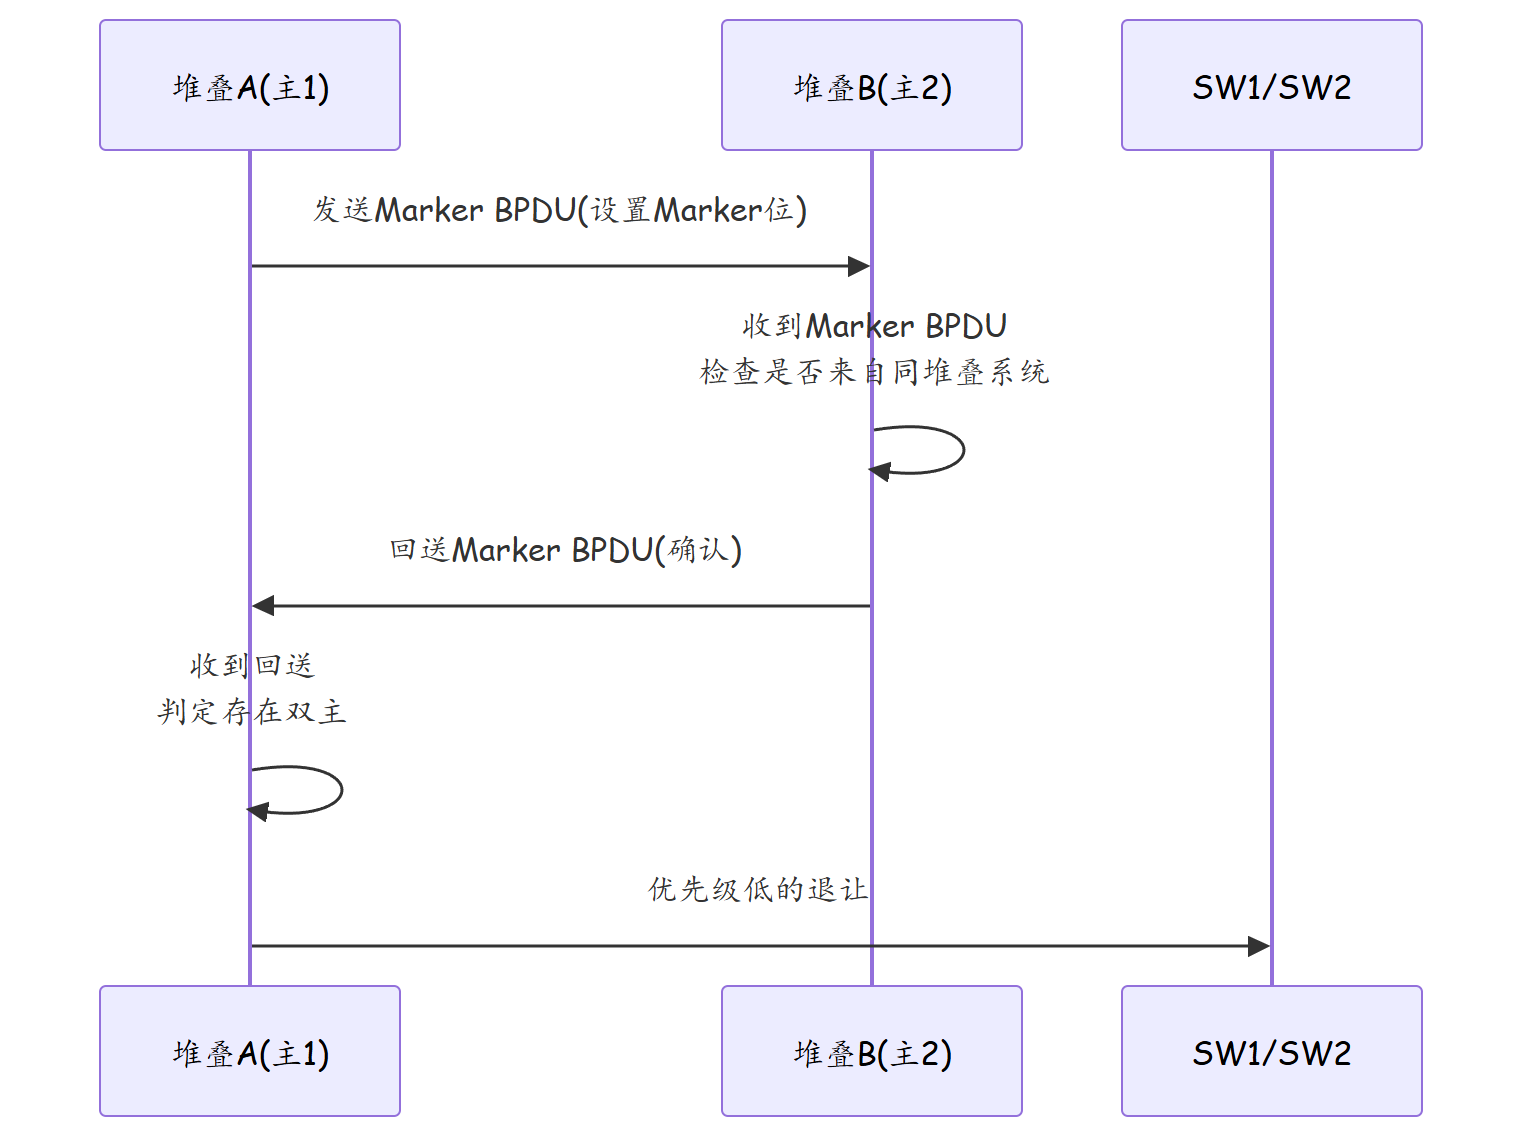
在分裂后的两个堆叠系统之间用一条专用 MAD 链路直连。正常运行时不发送 MAD 报文;一旦堆叠链路全部故障形成双主,两侧按 1s 周期通过该链路互发 MAD 报文进行冲突检测与处理。
3.3 MAD 检测到双主后的处理
| 处理方式 | 说明 | 配置 |
|---|---|---|
| 关闭全部非保留业务端口 | 竞争失败方进入 Recovery 状态,自动 shutdown 除保留端口外的所有业务端口 | 自动执行 |
| 指定保留端口 | 预先指定 MAD 冲突后仍保持 Up 的端口(堆叠口默认保留) | mad exclude interface |
| 手动恢复 | 若 Detect 侧故障/被下线,可在 Recovery 侧执行 mad restore 打开被关闭端口、接替业务 |
mad restore |
四、实战配置/案例分析
4.1 案例一:代理检测(relay)配置
需求:两台接入交换机的堆叠系统通过上联 Eth-Trunk 双链路连接到核心交换机,核心交换机作为 MAD 代理(中转)设备。
# ============ 堆叠系统侧(Stack-SW) ============
# 在承载上联业务的 Eth-Trunk 上启用"代理方式"多主检测
[Stack-SW] interface Eth-Trunk 1
[Stack-SW-Eth-Trunk1] dual-active detect mode relay
[Stack-SW-Eth-Trunk1] quit

# ============ 核心交换机侧(代理设备 Core-SW) ============
# 在与堆叠系统对接的 Eth-Trunk 上启用 MAD 代理(Relay)功能
[Core-SW] interface Eth-Trunk 1
[Core-SW-Eth-Trunk1] dual-active proxy
[Core-SW-Eth-Trunk1] quit
注意:代理设备必须为支持DAD代理功能的设备。如果是两套堆叠系统互为代理进行检查,对于同一个Eth-Trunk接口,不能既做代理检测功能的接口,又做代理功能的接口。
验证双主检测状态:
# 查看堆叠双主检测详细配置信息
<Stack-SW> display dual-active
Stack domainID: 1
Dual-active status: Normal
Dual-active detect mode: Relay
Dual-active relay detect interfaces configured:
 Eth-Trunk1
   10GE1/0/5       up  (Physical)  up  (Protocol)  10   (PeerDomain)
   10GE2/0/5       up  (Physical)  up  (Protocol)  10   (PeerDomain)

配置双主检测功能的接口Physical和Protocol均为up,说明双主检测功能配置成功。

# 查看Core-SW配置的代理信息。
<Core-SW> display dual-active proxy
Dual-active proxy interfaces configured:
 Eth-Trunk1
      10GE1/0/1        up
      10GE1/0/2        up

# 验证双主检测功能
双主检测功能配置后:
1. 如果堆叠系统分裂,设备会发出告警“STACK_1.3.6.1.4.1.2011.5.25.246.1.1 hwDadConflictDetect”。
2. 如果分裂故障恢复,设备会发出恢复告警“STACK_1.3.6.1.4.1.2011.5.25.246.1.2 hwDadConflictResume”。
4.2 案例二:直连检测(direct)配置
# 在两台堆叠系统间用一条专用业务口 MAD 链路直连
# 在 MAD 链路的物理接口上启用直连检测(两侧堆叠系统均需配置),
# 该接口会进入阻塞状态,只用于承载 MAD 报文
[Stack-SW] interface GigabitEthernet 0/0/25
[Stack-SW-GigabitEthernet0/0/25] dual-active detect mode direct
# 对端堆叠系统在其对应的 MAD 接口上同样执行 dual-active detect mode direct
4.3 案例三:堆叠分裂故障处理实录
故障现象:某园区网络,两台接入交换机堆叠,堆叠成员之间的堆叠电缆被施工误剪。
事件时间线:
| 时间 | 事件 |
|---|---|
| 10:00 | 堆叠电缆被剪断 |
| 10:00:01 | 堆叠系统分裂为两个独立系统 |
| 10:00:02 | 两个分区各自重新选举主设备,形成双主 |
| 10:00:05 | MAD(直连/代理检测)检测到双主 |
| 10:00:06 | MAD 动作执行:竞争失败(Recovery)的一侧关闭业务端口 |
| 10:00:07 | 业务流量集中在正常分区,业务短暂中断 |
| 14:00 | 运维人员修复物理连接 |
| 14:00:10 | 堆叠系统重新合并,恢复正常 |
故障分析:
# 通过命令display alarm active查看设备是否有双主检测告警。
<Stack-SW> display alarm active | include Dual-active
--------------------------------------------------------------------------------------
Sequence   AlarmId     Severity  Date Time    Description
--------------------------------------------------------------------------------------
12         0x9A90000   Critical  2026-10-10   Dual-active scenario is detected.
                                  15:00:38
--------------------------------------------------------------------------------------

# 查看堆叠状态

<Stack-SW> display stack
--------------------------------------------------------------------------------
MemberID Role     MAC              Priority   DeviceType         Description
--------------------------------------------------------------------------------
1        Master   00e0-fc12-1111   150        S6730-H24X6C-V2
2        Standby  00e0-fc12-2222   100        S6730-H24X6C-V2
--------------------------------------------------------------------------------

备设备缺席(堆叠链路已断)
未配置 MAD 的后果: - 两个主设备同时使用同一 IP 地址 → 全网 ARP 异常 - 两个主设备同时发布 BGP/OSPF 路由 → 路由震荡 - 故障恢复后,堆叠重新合并时配置冲突 → 业务延迟中断
五、总结
| MAD 方式 | 检测速度 | 配置复杂度 | 推荐场景 |
|---|---|---|---|
| 代理检测(relay) | 快 | 中(需中间设备 Eth-Trunk 配合) | 有 L2 上联聚合口可复用(推荐) |
| 直连检测(direct) | 快 | 低(需专用业务口链路) | 无可用中间设备场景 |
| 堆叠分裂预防 | 说明 |
|---|---|
| 堆叠链路双归 | 至少部署两条堆叠链路(防单断) |
| 启用 MAD | 强烈推荐,优先复用现有上联聚合口配置代理检测(relay) |
| 物理标记 | 堆叠线缆施工时贴警示标签 |
| 定期巡检 | 检查堆叠端口状态和日志 |
思考
- 堆叠分裂后 MAD 检测到双主,竞争失败(Recovery)的一侧会关闭业务端口。当堆叠链路恢复后,被关闭的一侧会自动恢复吗?
- 代理检测为什么要借用上联 Eth-Trunk 和中间(代理)设备,而不是像直连检测那样直接用一条专用链路?
- MAD 关闭业务端口后,堆叠链路恢复时会自动放开吗?还是需要在 Recovery 侧手动执行
mad restore?
下篇预告:第27篇:路由基础:什么是路由表,路由表关键字段